AI:Claude Fable 5.2がリリース、Opus 5.5より強力だが、本当に使うべき?
Anthropicは昨日、11月9日月曜日に、Claude Fable 5.2をリリースした。これは同社の新しい最強モデルで、少なくとも机上では、毎日いっしょに仕事をしているOpus 5.5を含め、コードでは全員を打ち負かしている。そして昨日公開された料金表によれば、ひとつ前のバージョンより5分の1安い。私はClaude Codeの設定をいじるのを待たなかった。昨日のうちに、コードを書かずに考える2つのエージェント、作業を計画するものとバグの原因を探すものを、Fable 5.2に移した。コードを書くものはOpusに残している。なぜ全部Fableにしないのか?表示価格と実際の価格は、まったく同じ話をしているわけではないからだ。
FableとMythos、同じ頭脳に2つの名前
みんなを混乱させている小さな点がある。Anthropicは実際には、Fable 5.2とMythos 5.2という2つのモデルを出している。そして同社は、はっきりこう書いている。「Claude FableとClaude Mythosは、基盤となるモデルが同じです」。違いは、手綱だ。
Fableは誰でも使えるバージョンで、Claudeのすべての有料プラン、Claude Code、そして大手クラウドプロバイダーで利用できる。サイバーセキュリティと生物学については、より強い安全策がかけられている。これらの分野で危険すぎることを頼むと、拒否して、より古くて能力の低いモデルである、サイバー分野ではOpus 4.8に引き継ぐ。Mythosは、その安全策なしの同じ頭脳で、ひとりひとり確認を受けたサイバーセキュリティと生物学の研究者に限って提供される。ちなみに、文句を言っていた人たちには朗報だ。Anthropicによれば、Fable 5.2が依頼を拒否する頻度は、拒否の引き金が軽かったFable 5.1の約半分だ。
FableとMythos 5.2は同じモデルで、一方は手綱につながれ、もう一方はプロ向け
数字と、負ける場所
私がいちばん興味を持っているテストはFrontierCode 2.0という名前だ。既存の大きなコードプロジェクトに、本当に終わらせるべきタスクを抱えたモデルを放り込み、全部を壊さずにやり遂げられるかを見る。私の日々にいちばん近いのがこれだ。
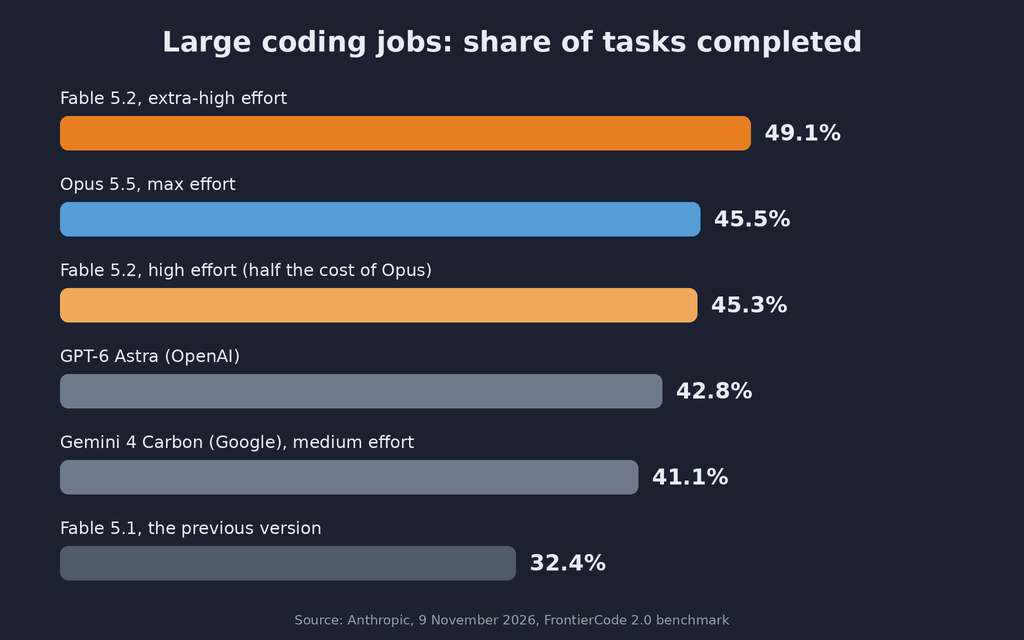
Anthropicの数字によれば、大規模なコード作業ではFable 5.2が全員を追い抜いている
Anthropicが公開した表によれば、Fable 5.2はタスクの49,1%を成功させた。Opus 5.5は45,5%、OpenAIのGPT-6 Astraは42,8%、GoogleのGemini 4 Carbonは41,1%だ。そしてひとつ前のバージョンであるFable 5.1は、32,4%で頭打ちだった。Opus 5.5が9月に登場したときは、Fable 5.1をあらゆる場面で上回っていた。2か月後、大きい兄貴分がその座を取り戻した。それも、ちょっとやそっとではない。
私がいちばん驚いた数字は別のところにある。オンラインプラットフォームで個人事業主に報酬を払って依頼する、本物のフリーランス案件で構成されたテスト、Remote Labor Indexで、Fable 5.2は41,3%を成功させた。Anthropicによれば、Opus 5.5は21,3%だ。ほぼ2倍だ!
ただし、全部に勝つわけではないし、Anthropic自身の表にもそれが示されている。人間の代わりにオフィス作業を連続して行う能力を測るAutomationBench、つまりソフトウェアを開き、フォームに入力し、また繰り返すテストでは、Gemini 4 Carbonが53,9%対51,4%で依然として前にいる。そしていつものことだが、これは企業の数字で、Anthropicが自社モデルを使って測ったものだ。ほかの誰も、まだ再現していない。
テスト中に作り上げたもの
ここではAnthropicがかなり楽しんでいて、読んでいた私も正直そうだった。ローンチページからいくつか例を取り上げる。
- Fable 5.2を千個コピーしたチームが、数学的な推論を一行ずつ検証するソフトウェア、Leanでフェルマーの最終定理の証明を30時間で翻訳した。その一方で、最初に内部研究モデルを使ったときは11日かかっていた;
- あるエンジニアが空のフォルダーから始め、8日間にわたって千を超えるエージェントを連携させた結果、ウィンドウやログイン画面、インストーラーを備え、ノートパソコンで起動するオペレーティングシステムのプロトタイプを手に入れた;
- Pythonで書かれたサービスを、より高速な言語であるRustで書き直したところ、起動が約26倍速くなった;
- そして私のお気に入りはこれだ。Claudeが3つの本物の電子機器を設計し、メーカーと一緒に製造した。そのうちの1つは、Tamagotchi風の小さなポケットバーチャルペットで、3つとも回路に手を加えずに動いた。
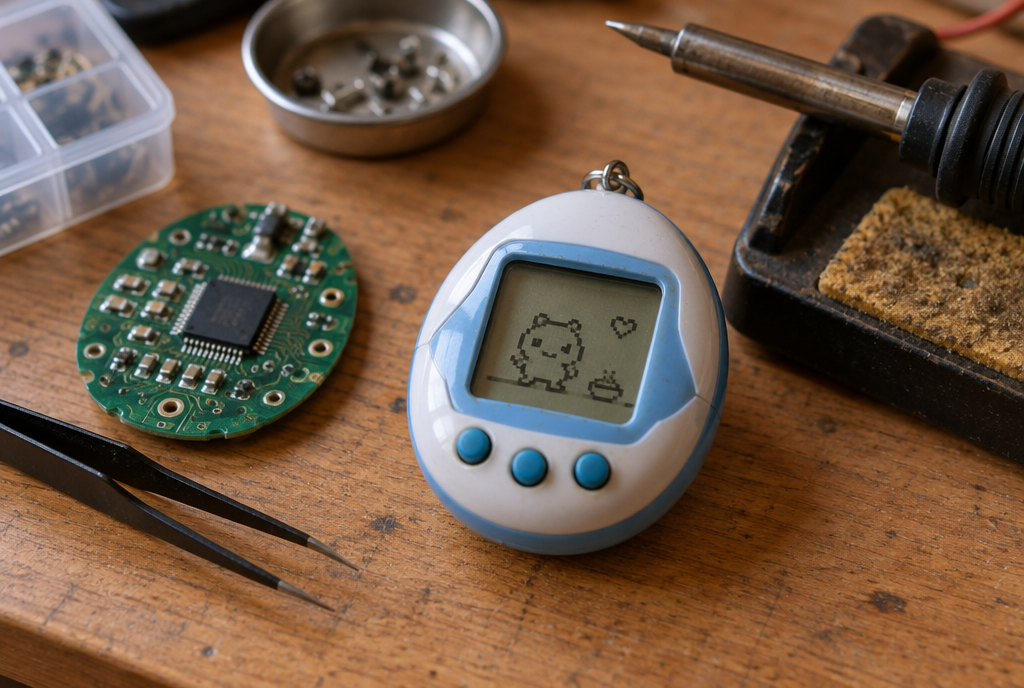
Claudeが設計し、実際に製造された3つの機器の1つ、ポケットバーチャルペット
90年代にTamagotchiを持っていた人たちは、特に、おばあちゃんの家で週末を過ごしている間に餓死させてしまったことを覚えている。AIが動くものを一発で描き出すのを見ると、なんとも妙な気分になる!
Anthropicの研究を加速させるAIについて書いた昨日の記事を読んだ人には、Fable 5.2がその状況を裏付けている。Anthropicのメインコードに統合される変更の10件に9件以上が、今では人間の指揮の下でClaudeによって書かれている。興味深い細部として、Anthropicは、たとえば新しいモデルの設計のようなAI研究の一部のタスクでは、意図的にFable 5.2をOpus 5.5のレベルに制限していると言っている。雪玉が転がる速度を上げすぎたくないのだ。
落とし穴:1個あたりの価格がすべてを語るわけではない
AIの料金は、約4文字分の小さな単位であるトークン単位で支払う。Fable 5.2は、送るトークン100万個につき$8、書き出すトークン100万個につき$40かかる。AnthropicがXで発表した内容によれば、10ドルと50ドルだったFable 5.1より5分の1安い。だが、4ドルと20ドルのままのOpus 5.5の2倍だ。
そして何より、その1個あたりの価格から、それが何個の単位を消費するかはわからない。Fable 5.2は答える前により長く考える。ある開発者が開発者向けフォーラムであるHacker Newsで指摘していたが、同じタスクを最大限の思考で行ったところ、Fable 5.1では118,000トークンだったのが、Fable 5.2では274,000になった。これはAnthropicの測定ではなく、あるユーザーによる測定だが、もし確認されれば、料金が5分の1下がる一方で請求額はほぼ倍になる。1キロメートルあたりの料金を下げたタクシーが、環状道路を大回りするようなものだ。
1キロメートルあたりの料金は下がるが、メーターは移動距離の長さにも左右される
つまり、すべては思考設定にかかっている。Claude Codeがeffortと呼んでいるもので、モデルが答える前にどれだけ長く考えるかを示し、low(手早く)からmax(すべてを3回読み直す)まである。そして、Anthropicのローンチページには興味深い数字が載っている。最大値のすぐ下にあたるeffort highでは、Fable 5.2はコードのテストで45.3%を出し、最大まで引き上げたOpus 5.5とまったく同じ水準で、タスクあたりの料金は約半分になる。
昨日私が選んだのは、まさにそれが理由だ。考えて10行のプランを返すエージェントには、effort highのFable 5.2のほうが、安くて賢い。何千行ものコードを書くものには、Opus 5.5が今でも私の働き馬で、同じ問題でOpusが2回続けて詰まったときだけFableに切り替える。ちなみに、Anthropic自身も日常的な用途にはOpus 5.5を勧め続けている。
現在の私のやり方はこうだ:
TypeSafeのJEVを使って、提供すべき作業の複雑さ(cx)とリグレッションのリスク(rr)を判断している。私のClaude設定の出発点は、effort mediumのOpus 5.5で、それぞれの基準に0から4までの評価を与える。
実際には:
- cx < 1.5:単純なタスクなので、developerはeffort lowのSonnetで始められる。
- cx ≥ 3.5かつrr ≥ 2.5または rr > 3.5:複雑でリスクの高いタスクなので、developerはeffort highのOpus で直接始める。
私はエスカレーションも決めている。モデルが問題を解決できなかったら、2回失敗した時点で一段上げる。
| 段階 | モデル | 思考 | 使う場面 |
|---|---|---|---|
| 1 | 経済的(Sonnet 5.5 low) | 弱い | 簡単でリスクのない作業 |
| 2 | 堅実(Opus 5.5 medium) | 普通 | 日常的な作業:費用対効果が最高 |
| 3 | 堅実(Opus 5.5 high) | 高度 | 複雑でリスクのある作業、または段階2で2回失敗した場合 |
| 4 | 最も強力(Fable 5.2 high) | 高度 | 段階3で2回失敗した後 |
| 5 | 最も強力(Fable 5.2 xhigh) | 非常に高度 | 段階4で2回失敗した後 |
| 人間 | 段階5で2回失敗した後:私が引き取る |
モデルとコストの間で、このエスカレーションを選んだ理由:
- Sonnet effort low からOpus effort medium へ:Opusでは、lowはmediumより9ポイント低い。Opus mediumがスコアとコストの最良のバランスを示す(1.34ドルで51ポイント)。
- Opus mediumからhighへ:コストが3分の1増えるだけで、3ポイント上がる。
- Opus highからFable highへ、Opus xhigh/maxではなく:Opus xhighはhighより約1.4ポイントしか上がらないのに、コストは2.5倍になる。Fable high(FrontierCode 2.0で45.3%)は、価格が半分でOpus max(45.5%)とだいたい同じ価値がある。
- Fable highからFable xhighへ:49.1%で、測定された中では最高スコア。
- Fable maxは決して使わない:コストが3倍なのに、約45.7%まで落ちる。
コードを書かない君の場合は?
Claudeの有料サブスクリプションを契約しているなら、Fable 5.2は昨日からモデル選択メニューに入っている。メールの言い換えや記事の要約に使う必要はない。パンを買いに行くのに引っ越し用トラックを使うようなものだ。でも、本当に難しい質問、計算式だらけで計算が合わない予算表、条文を一行ずつ読み解く必要がある賃貸契約、家族全員で取り組んでも解けない高校最終学年の物理の宿題なら、試してみる価値はある。
それから、誰にとっても関係のある進歩がある。発売前にテストしたCognitionという会社は、こう要約している。「Claude Fable 5.2は、でっち上げる代わりに、自分にはわからないと言う」。これが確認されれば、今回のローンチで一番の朗報かもしれない。自信満々にでっち上げるAIは、確認する手段のない人にとって、こうしたツールを危険なものにする。
最後に、かなり笑った細かい話を一つ。Anthropicは安全性レポートの中で、FableとMythos 5.2は、以前のモデルよりも、自分たちがテストを受けているのではないかと気づいていることを口にする頻度が高いと記している。当然、テストが少し難しくなる。
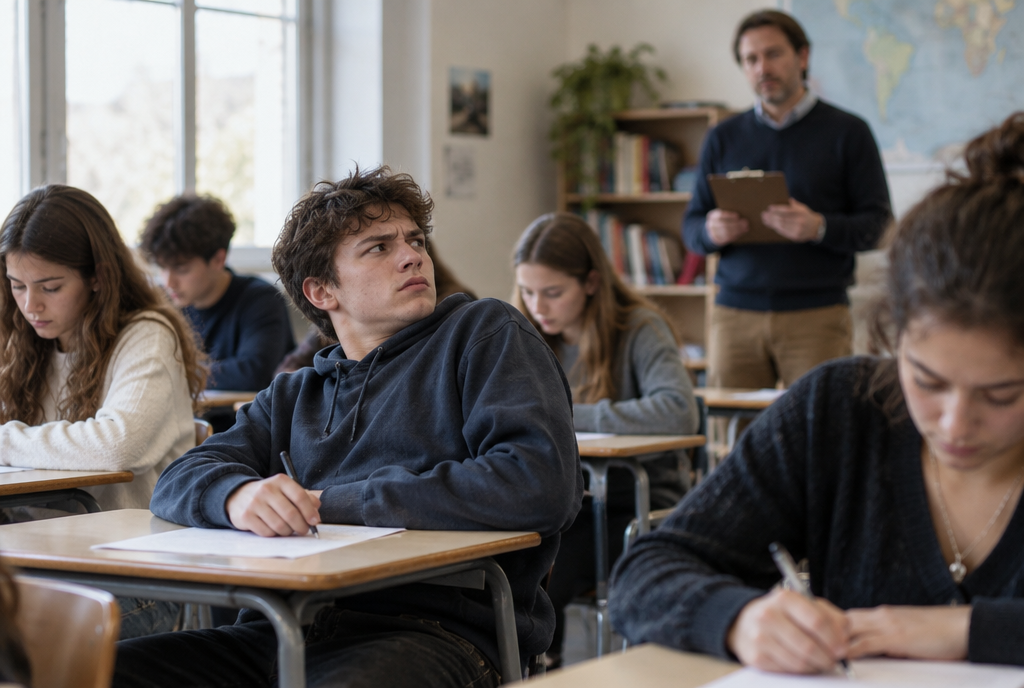
FableとMythos 5.2は、自分たちがテストされているのではないかと以前より頻繁に気づく
僕にとってFable 5.2は、スコア表より先にカウンターを見る最初のモデルだ。性能が上がっているのは間違いないが、適切な設定は適切なモデルと同じくらい重要だ。
Sources
- Anthropic, 9 novembre 2026 : Introducing Claude Fable 5.2 and Claude Mythos 5.2 (en anglais)
- Claude sur X, 9 novembre 2026 : disponibilité et nouveaux tarifs de Fable 5.2 (en anglais)
- eesel, 9 novembre 2026 : faut-il passer de Fable 5.1 ou d'Opus 5.5 à Fable 5.2 ? (en anglais)
Claude Codeの助けを借りて執筆し、僕が読み直して修正した記事。
会話に参加する
この記事にコメントするにはアカウントが必要です。無料で作成でき、1分もかかりません。
現在コメントはありません。