IA : Claude Fable 5.2 est sorti, plus fort qu'Opus 5.5, mais faut-il vraiment l'utiliser ?
Anthropic a sorti hier, lundi 9 novembre, Claude Fable 5.2, son nouveau modèle le plus costaud, et sur le papier il bat tout le monde en code, y compris Opus 5.5, celui avec lequel je bosse tous les jours. Et d'après la grille publiée hier, il coûte un cinquième de moins que la version d'avant. Je n'ai pas attendu pour toucher à ma config de Claude Code : dès hier, les deux agents qui réfléchissent sans écrire de code, celui qui planifie un chantier et celui qui cherche la cause d'un bug, sont passés sur Fable 5.2. Celui qui écrit le code reste sur Opus. Pourquoi pas tout sur Fable ? Parce que le prix affiché et le prix réel ne racontent pas tout à fait la même histoire.
Fable, Mythos : deux noms pour le même cerveau
Petit détail qui embrouille tout le monde : Anthropic sort en fait deux modèles, Fable 5.2 et Mythos 5.2. Et l'entreprise l'écrit noir sur blanc : « Claude Fable et Claude Mythos sont le même modèle sous-jacent ». La différence, c'est la laisse.
Fable, c'est la version pour tout le monde, disponible sur tous les abonnements payants de Claude, dans Claude Code et chez les grands fournisseurs de cloud. Il porte des garde-fous renforcés sur la cybersécurité et la biologie : quand tu lui demandes quelque chose de trop dangereux dans ces domaines, il refuse et passe la main à un modèle plus ancien et moins doué, Opus 4.8 pour la cyber. Mythos, c'est le même cerveau sans ces garde-fous, réservé aux chercheurs en sécurité et en biologie qui ont été vérifiés un par un. Bonne nouvelle au passage pour ceux qui râlaient : d'après Anthropic, Fable 5.2 refuse environ deux fois moins de demandes que Fable 5.1, qui avait la gâchette facile.
Fable et Mythos 5.2 sont le même modèle, l'un tenu en laisse, l'autre réservé aux pros
Les chiffres, et l'endroit où il perd
L'épreuve qui m'intéresse le plus s'appelle FrontierCode 2.0 : on lâche le modèle dans un gros projet de code existant, avec une vraie tâche à finir, et on regarde s'il y arrive sans tout casser. C'est ce qui ressemble le plus à mes journées.
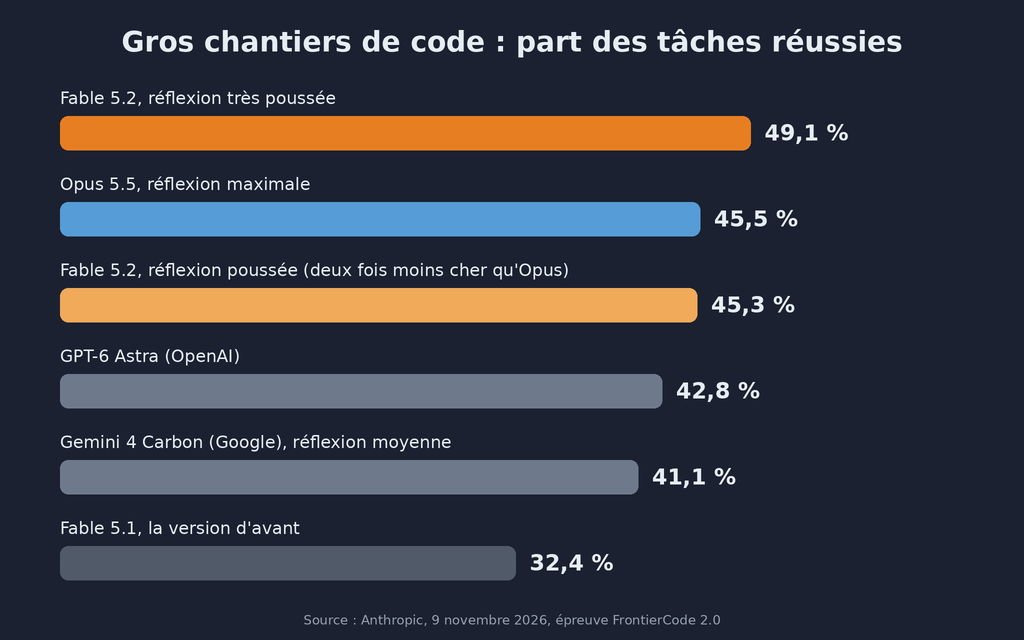
Sur les gros chantiers de code, Fable 5.2 passe devant tout le monde, d'après les chiffres d'Anthropic
D'après le tableau publié par Anthropic, Fable 5.2 réussit 49,1 % des tâches, contre 45,5 % pour Opus 5.5, 42,8 % pour GPT-6 Astra d'OpenAI et 41,1 % pour Gemini 4 Carbon de Google. Et la version d'avant, Fable 5.1, plafonnait à 32,4 %. Quand Opus 5.5 était sorti en septembre, il battait Fable 5.1 partout. Deux mois plus tard, le grand frère reprend sa place, et pas qu'un peu.
Le chiffre qui m'a le plus scotché est ailleurs. Sur le Remote Labor Index, une épreuve faite de vraies missions de freelance, celles qu'on paie à un indépendant sur une plateforme en ligne, Fable 5.2 en réussit 41,3 %, toujours selon Anthropic. Opus 5.5 : 21,3 %. Presque le double !
Mais il ne gagne pas tout, et Anthropic le montre dans son propre tableau. Sur AutomationBench, qui mesure l'enchaînement de tâches de bureau à la place d'un humain (ouvrir un logiciel, remplir un formulaire, recommencer), Gemini 4 Carbon reste devant, 53,9 % contre 51,4 %. Et comme toujours, ce sont des chiffres d'entreprise, mesurés par Anthropic sur ses propres modèles. Personne d'autre ne les a encore refaits.
Ce qu'il a fabriqué pendant les tests
Là, Anthropic s'est fait plaisir, et j'avoue que moi aussi en lisant. Quelques exemples tirés de la page de lancement :
- une équipe de mille copies de Fable 5.2 a traduit la démonstration du dernier théorème de Fermat dans Lean, un logiciel qui vérifie un raisonnement mathématique ligne par ligne, en 30 heures, alors que la première fois, avec un modèle de recherche interne, il avait fallu onze jours ;
- un ingénieur est parti d'un dossier vide et, avec plus de mille agents coordonnés pendant huit jours, a obtenu un prototype de système d'exploitation qui démarre sur un portable, avec ses fenêtres, son écran de connexion et son installateur ;
- un service écrit en Python a été réécrit en Rust, un langage plus rapide, et il démarre maintenant environ 26 fois plus vite ;
- et mon préféré : Claude a conçu trois vrais appareils électroniques, fabriqués avec un industriel, dont un petit animal virtuel de poche, façon Tamagotchi, et tous les trois ont marché sans retouche du circuit.
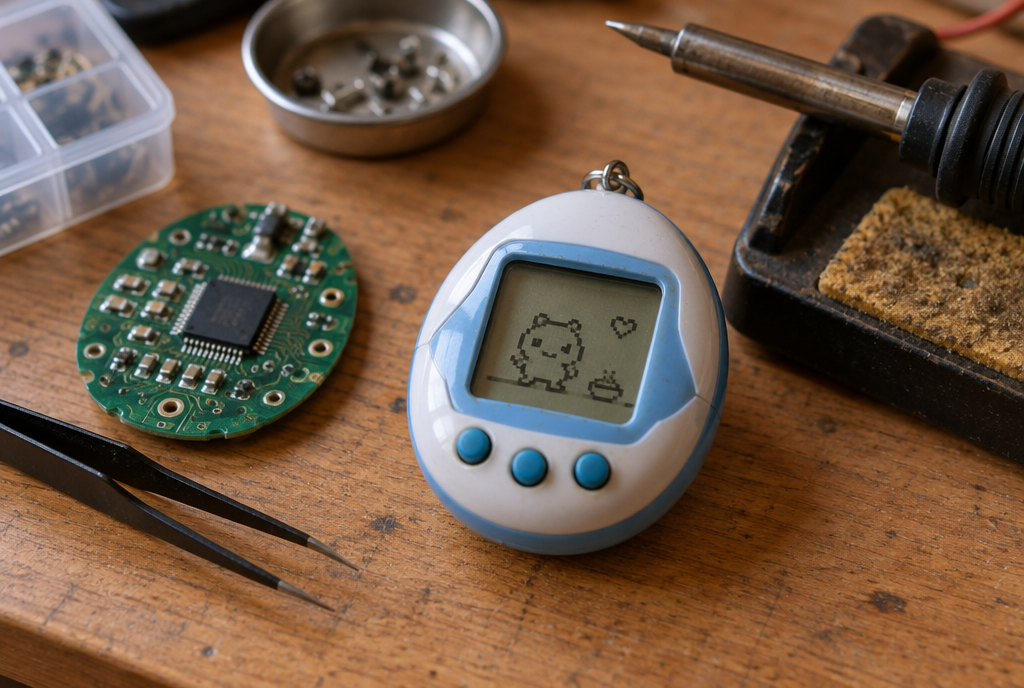
Parmi les trois appareils conçus par Claude et fabriqués pour de vrai, un animal virtuel de poche
Ceux qui ont eu un Tamagotchi dans les années 90 se souviennent surtout de l'avoir laissé mourir de faim pendant un week-end chez mamie. Voir une IA en dessiner un qui fonctionne du premier coup, ça fait un drôle d'effet !
Et pour ceux qui ont lu mon article d'hier sur l'IA qui accélère la recherche d'Anthropic, Fable 5.2 confirme le décor : plus de neuf modifications sur dix intégrées dans le code principal d'Anthropic sont maintenant écrites par Claude, sous la direction d'humains. Détail intéressant, Anthropic dit avoir volontairement bridé Fable 5.2 au niveau d'Opus 5.5 sur certaines tâches de recherche en IA, comme la conception de nouveaux modèles. Ils ne veulent pas que la boule de neige roule trop vite.
Le piège : le prix au morceau ne dit pas tout
Une IA se paie au token, un petit bout de mot d'environ quatre lettres. Fable 5.2 coûte 8 dollars le million de tokens qu'on lui envoie, et 40 dollars le million qu'il écrit. C'est un cinquième de moins que Fable 5.1, qui était à 10 et 50, d'après l'annonce d'Anthropic sur X. Mais c'est le double d'Opus 5.5, qui reste à 4 et 20.
Et surtout, le prix du morceau ne dit pas combien de morceaux il va consommer. Fable 5.2 réfléchit plus longtemps avant de répondre. Un développeur a relevé sur Hacker News, le forum des développeurs, que sur une même tâche en réflexion maximale, il est passé de 118 000 tokens avec Fable 5.1 à 274 000 avec Fable 5.2. C'est la mesure d'un utilisateur, pas d'Anthropic, mais si elle se confirme, le tarif baisse d'un cinquième pendant que la facture double presque. C'est le taxi qui baisse son prix au kilomètre et qui prend le grand tour du périphérique.
Le tarif au kilomètre baisse, mais le compteur dépend aussi de la longueur du trajet
Tout se joue donc sur le réglage de réflexion, que Claude Code appelle l'effort : combien de temps le modèle cogite avant de répondre, de low (vite fait) à max (il relit tout trois fois). Et là, la page de lancement d'Anthropic donne un chiffre intéressant. Avec un effort high, juste en dessous du maximum, Fable 5.2 fait 45,3 % sur l'épreuve de code, exactement le niveau d'Opus 5.5 poussé au maximum, pour environ deux fois moins cher par tâche.
C'est exactement pour ça que j'ai fait mon choix d'hier. Pour les agents qui réfléchissent et rendent un plan de dix lignes, Fable 5.2 en effort high, c'est plus malin pour moins cher. Pour celui qui écrit des milliers de lignes de code, Opus 5.5 reste mon cheval de trait, et je ne passe sur Fable que quand Opus bloque deux fois de suite sur le même problème. D'ailleurs, Anthropic lui-même continue de conseiller Opus 5.5 pour le quotidien.
Voici ma manière de faire actuellement :
J'utilise JEV de TypeSafe pour décider de la complexité (cx) du travail qui doit être fourni et du risque de régression (rr). Le point de départ de ma configuration de Claude est Opus 5.5 en effort medium, et chaque critère me donne une cote de 0 à 4.
En pratique :
- cx < 1,5 : tâche simple, le developer peut partir en Sonnet sur effort low.
- cx ≥ 3,5 et rr ≥ 2,5 ou rr > 3,5 : tâche complexe et risquée, le developer part directement en Opus sur effort high.
Jev décide aussi de l'escalade : si un modèle n'arrive pas à résoudre un problème, après deux échecs on monte d'un cran :
| Marche | Modèle | Réflexion | Quand |
|---|---|---|---|
| 1 | Économique (Sonnet 5.5 low) | Faible | Tâche simple et sans risque |
| 2 | Solide (Opus 5.5 medium) | Moyenne | Tâche courante : le meilleur rapport qualité/prix |
| 3 | Solide (Opus 5.5 high) | Poussée | Tâche complexe et risquée, ou deux échecs à la marche 2 |
| 4 | Le plus puissant (Fable 5.2 high) | Poussée | Après deux échecs à la marche 3 |
| 5 | Le plus puissant (Fable 5.2 xhigh) | Très poussée | Après deux échecs à la marche 4 |
| — | Humain | — | Après deux échecs à la marche 5 : je reprends la main |
Pourquoi ce choix d'escalade entre modèle et coût :
- Sonnet effort low → Opus effort medium : sur Opus, low perd 9 points par rapport à medium. Opus medium donne le meilleur rapport score/coût (51 points pour 1,34 $).
- Opus medium → high : +3 points pour un tiers de coût en plus.
- Opus high → Fable high plutôt qu'Opus xhigh/max : Opus xhigh ne gagne qu'environ 1,4 point sur high pour 2,5 fois le coût. Fable high (45,3 % sur FrontierCode 2.0) vaut à peu près Opus max (45,5 %) pour moitié prix.
- Fable high → Fable xhigh : 49,1 %, le meilleur score mesuré.
- Jamais de Fable max : il retombe à environ 45,7 % pour trois fois le coût.
Et pour toi, qui n'écris pas de code ?
Si tu as un abonnement payant à Claude, Fable 5.2 est dans le menu de choix du modèle depuis hier. Inutile de le sortir pour reformuler un mail ou résumer un article, c'est un peu comme prendre un camion de déménagement pour aller chercher le pain. Mais pour une question vraiment difficile, un tableur de budget plein de formules qui ne tombe pas juste, un contrat de location à décortiquer ligne par ligne, un devoir de physique de terminale qui résiste à toute la famille, ça vaut le coup d'essayer.
Et il y a un progrès qui concerne tout le monde. Cognition, une entreprise qui l'a testé avant sa sortie, résume : « Claude Fable 5.2 dit qu'il ne sait pas au lieu d'inventer. » Si ça se confirme, c'est peut-être la meilleure nouvelle du lancement. Une IA qui invente avec aplomb, c'est ce qui rend ces outils dangereux pour quelqu'un qui n'a pas les moyens de vérifier.
Dernier détail, qui m'a bien fait rire. Dans son rapport de sécurité, Anthropic note que Fable et Mythos 5.2 disent plus souvent que les modèles précédents qu'ils se doutent d'être en train de passer un test. Ce qui complique un peu les tests, forcément.
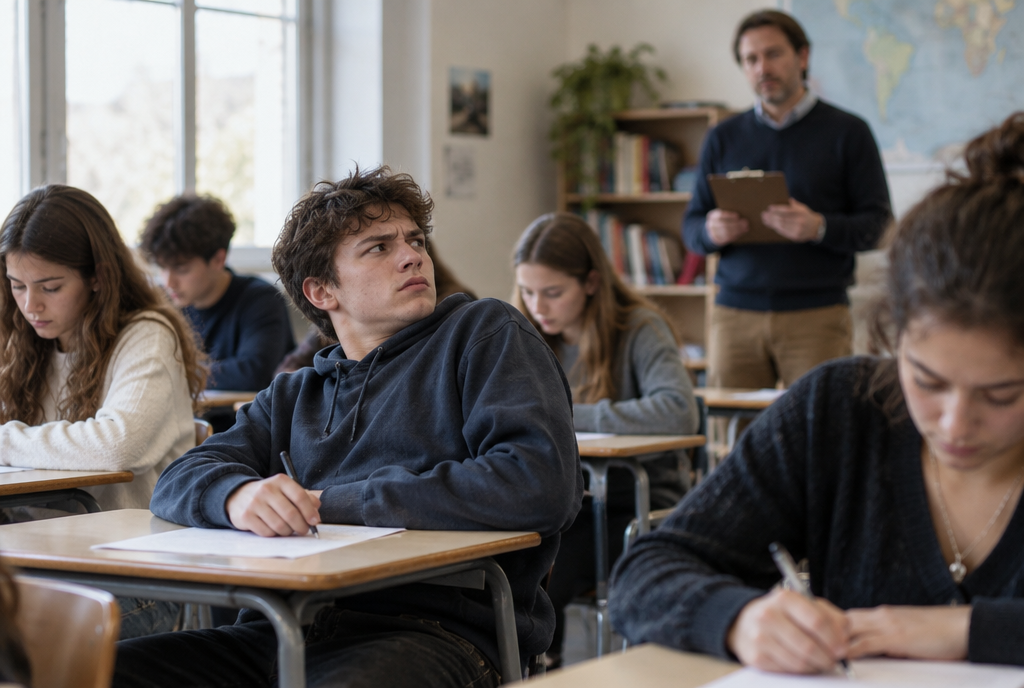
Fable et Mythos 5.2 se doutent plus souvent qu'avant qu'on est en train de les tester
Pour moi, Fable 5.2, c'est le premier modèle où je regarde le compteur avant le tableau des scores. Il est meilleur, c'est indiscutable, mais le bon réglage compte autant que le bon modèle.
Sources
- Anthropic, 9 novembre 2026 : Introducing Claude Fable 5.2 and Claude Mythos 5.2 (en anglais)
- Claude sur X, 9 novembre 2026 : disponibilité et nouveaux tarifs de Fable 5.2 (en anglais)
- eesel, 9 novembre 2026 : faut-il passer de Fable 5.1 ou d'Opus 5.5 à Fable 5.2 ? (en anglais)
Article écrit avec l'aide de Claude Code, relu et corrigé par moi.
Rejoignez la conversation
Vous devez avoir un compte pour commenter cet article. La création est gratuite et prend moins d'une minute.
Aucun commentaire pour le moment.