Claude écrit 90 % de son propre code : qui relit tout ça ?
Claude écrit environ 90 % du code de Claude Code. Pas 90 % des brouillons, pas 90 % des petits bouts : 90 % du logiciel que des centaines de milliers de développeurs lancent tous les jours. Du coup, la question que tout le monde se pose finit par arriver : qui relit tout ça ? Anthropic a publié jeudi sa réponse. Et ce n'est pas « plus personne ».
Tout ne passe pas par le même guichet, et c'est précisément l'idée
Le problème, en un chiffre
Chez Anthropic, le nombre de modifications intégrées chaque jour est passé d'environ 2 500 en mai à plus de 30 000 en septembre. Douze fois plus en quatre mois. Je racontais il y a trois jours comment cette avalanche les a poussés à remplacer Git, l'outil qui garde l'historique du code depuis vingt ans. Mais changer de tuyau ne règle qu'une moitié du problème. L'autre moitié, c'est que quelqu'un doit regarder ce qui passe dedans.
Et la relecture de code, pour ceux qui ne sont pas du métier, c'est le rituel central du développement : avant qu'une modification entre dans le logiciel, un collègue la lit et donne son avis. Ça attrape les bêtises, ça diffuse la connaissance, ça évite qu'une seule personne soit la seule à comprendre un bout du programme. C'est lent, c'est pénible, et aucune équipe sérieuse ne s'en passe.
Sauf qu'à 30 000 modifications par jour, « un collègue la lit » devient mathématiquement impossible. Il faudrait embaucher la moitié de la ville.
Ce qu'ils ont fait, et ce n'est pas supprimer la relecture
La réponse d'Anthropic tient en une phrase : ce n'est plus l'humain qui lit tout, c'est lui qui décide ce qui mérite d'être lu. Le reste descend d'un cran à chaque étape.
D'abord, avant même de proposer sa modification, Claude lance les tests et fait relire son travail par un autre exemplaire de lui-même, qui découvre le code sans savoir comment il a été écrit. Ensuite, la machinerie habituelle vérifie que ça compile et que les tests passent. Puis une équipe d'agents relit en parallèle, chacun cherchant des bugs de son côté.
Et là il y a un détail que je trouve malin : les remarques trouvées ne sont pas publiées telles quelles. Un autre groupe d'agents vote sur chacune, et la remarque n'apparaît que si assez de votants la trouvent justifiée. Tout ce qui relève du style ou du rangement est jeté d'office. C'est leur parade contre le pire défaut d'un relecteur automatique : le type qui te sort quarante commentaires dont trente-neuf sur l'indentation.
Trois files d'attente, comme à l'aéroport
Vient ensuite la partie qui m'a le plus parlé. Un classificateur, c'est-à-dire un petit programme qui trie, regarde la modification et décide de son niveau de risque. Trois niveaux, trois traitements.
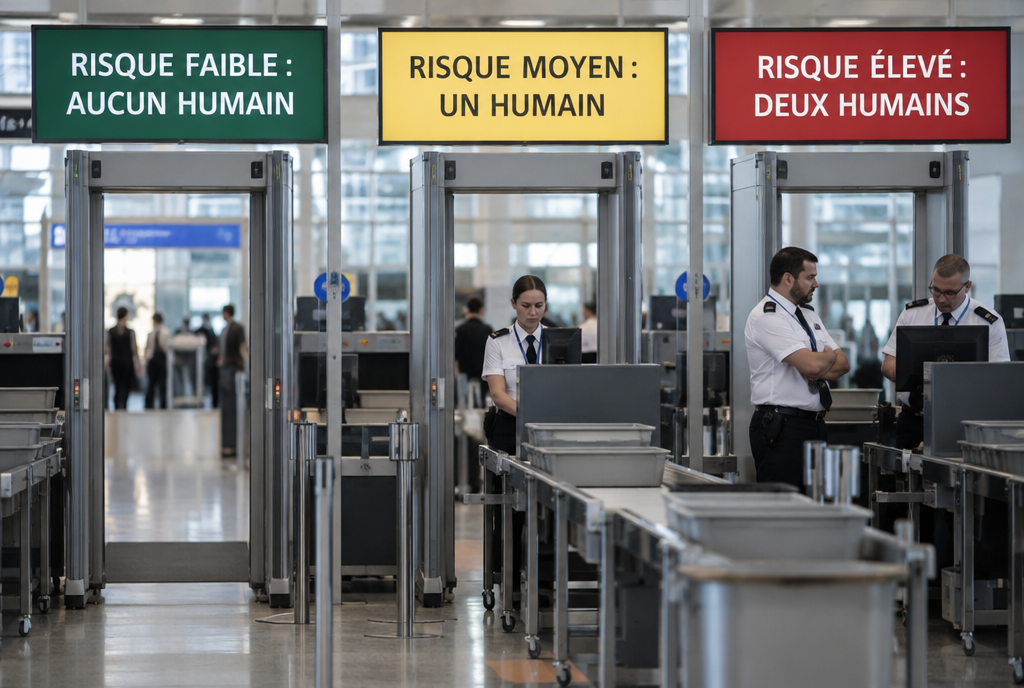
Le classificateur juge la modification, pas la tête de celui qui l'a écrite
Risque faible, comme de la documentation ou une fonction ajoutée derrière un interrupteur qui la garde éteinte : personne ne relit, du moment que les contrôles automatiques sont au vert. Risque moyen, c'est-à-dire la plupart des changements du produit : une personne. Risque élevé, les zones sensibles comme la facturation ou le système de mise à jour automatique : deux personnes, toujours.
Deux garde-fous que je note parce qu'ils disent tout du reste : l'approbation d'un agent ne compte jamais comme celle d'un humain, et une approbation vaut pour une version précise, pas pour « ce que fera ce développeur ensuite ».
La boucle infinie à trois heures du matin
Le passage le plus drôle du billet, et le plus parlant, c'est l'histoire d'une modification qui a fait plus de cinquante allers-retours de relecture dans la nuit. L'agent trouvait un problème, l'agent corrigeait, l'autre agent retrouvait un problème, et ainsi de suite jusqu'à ce que l'auteur, au réveil, débranche tout.
Cinquante tours de relecture pendant que tu dors. Le rêve, sur le papier
Le plus cruel : 59 % de ce que le relecteur continuait à signaler concernait du code qui était déjà là au premier passage. Il relisait en boucle son propre territoire, comme un chien qui court après sa queue.
Ils ont donc ajouté des règles de bon sens. Après trois tours, on arrête et on se demande si l'approche n'est pas mauvaise dès le départ. Les relectures suivantes ne regardent que ce qui a changé depuis. Et une remarque déjà faite ne se refait pas.
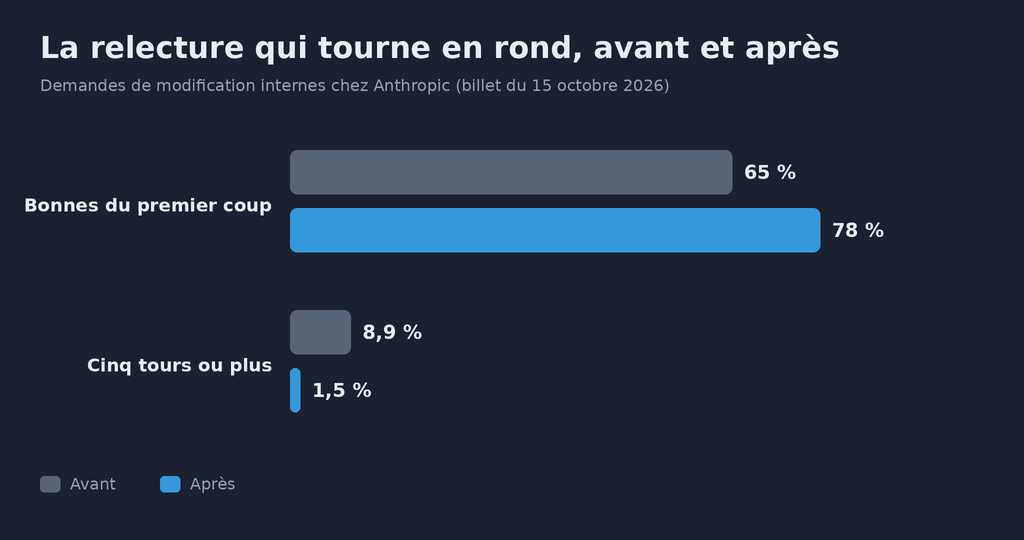
La deuxième ligne est la vraie victoire : les nuits blanches divisées par six
Résultat, les modifications qui passent du premier coup montent de 65 à 78 %, et celles qui demandent cinq tours ou plus tombent de 8,9 à 1,5 %. Leur priorité est d'ailleurs écrite noir sur blanc : attraper les vrais bugs d'abord, réduire le nombre de tours ensuite. Dans cet ordre.
Les deux fichiers qui pilotent tout ça
Côté pratique, et c'est transposable chez toi, tout repose sur deux fichiers texte posés dans le projet.
Le premier, CLAUDE.md, décrit le projet : les technologies utilisées, les conventions, ce que le projet cherche à faire et ce qu'il ne fera pas. Leur conseil est de le garder court et de pointer vers le reste de la documentation plutôt que de tout recopier dedans.
Le second, REVIEW.md, est écrit par ceux qui connaissent le mieux chaque partie du code, et il dit au relecteur ce qui compte vraiment ici. Les bons exemples cités sont très concrets : dire à quoi ressemble un échec dans ce coin précis, limiter le nombre de remarques de détail, lister les dossiers à ignorer, exiger un fichier et un numéro de ligne comme preuve, et commencer le compte rendu par le nombre de problèmes trouvés, quitte à écrire franchement qu'il n'y a rien à corriger.
J'ai exactement ces deux fichiers dans mes projets, et je confirme que la différence entre un relecteur utile et un emmerdeur tient surtout à ce qu'on a pris la peine d'y écrire.
Ce que les humains gardent
Leur liste est courte, et c'est celle que je garderais si je ne devais retenir qu'un paragraphe. Décider s'il faut construire la chose. Relire le code qui touche à l'argent et aux mises à jour. Relire l'architecture que les autres vont recopier pendant trois ans. Regarder les preuves, c'est-à-dire les résultats des tests et les captures d'écran, plutôt que les lignes une par une. Et porter le chapeau quand ça casse en production, parce que ça, aucun agent ne le fera à ta place le dimanche soir.
Une phrase du billet résume bien le virage : « est-ce qu'un humain a lu le code ? » est une mauvaise question, un à-peu-près commode. La bonne, c'est « qu'est-ce qui pourrait mal tourner ici, et quel contrôle attrape ça ? ». Du coup la relecture humaine descend de son piédestal : elle devient un contrôle parmi d'autres, qu'on place là où il rapporte le plus.
Mon avis
Je suis assez d'accord sur le fond, et il y a une statistique qui me fait sourire : quand ils ont branché leur relecteur automatique en interne, la part des modifications recevant un vrai commentaire de fond est passée de 16 à 54 %. Autrement dit, avant l'IA, cinq modifications sur six passaient sans que personne ne dise rien de substantiel. On a tous fait ça : on regarde le titre, on clique « approuvé », on retourne à son propre travail. La machine ne remplace pas une relecture rigoureuse, elle remplace surtout une relecture qui n'avait pas lieu.
Ce qui me chiffonne quand même, c'est la connaissance. Relire le code d'un collègue, c'est comme ça qu'on apprend un projet. Si la machine lit tout et que l'humain ne regarde plus que les preuves, qui connaît encore le programme dans cinq ans ? Anthropic y répond avec des explications de code générées automatiquement, et je demande à voir. Lire un résumé sur une maison, ce n'est pas la même chose que d'y avoir vécu !
Sources
- Addy Osmani, Morgan Westlee Lunt et Qing Wang, 15 octobre 2026 : comment l'équipe Claude Code fait sa relecture de code
- Hacker News : la discussion des développeurs autour de ce billet
Article écrit avec l'aide de Claude Code, relu et corrigé par moi.
Rejoignez la conversation
Vous devez avoir un compte pour commenter cet article. La création est gratuite et prend moins d'une minute.
Aucun commentaire pour le moment.