Claude Opus 5.5 est sorti hier après-midi, et le chiffre qui compte n'est pas un score. C'est un tarif. Le million de tokens (ces bouts de texte que les modèles facturent au morceau) passe de 5 à 4 dollars en entrée, de 25 à 20 en sortie, et Anthropic annonce 40 % de moins à faire tourner sur une journée de travail ordinaire.
Ce n'est pas la première baisse de prix de l'année, j'en parle presque tous les mois ici. Mais celle-là ne vient pas du même endroit que les autres. D'habitude, ce sont les petits modèles qu'on brade pour attirer du monde. Là, c'est le haut de la gamme d'Anthropic qui arrive moins cher que le modèle qu'il remplace, ce qui n'était pas arrivé depuis longtemps.
Et le même après-midi, OpenAI sortait GPT-6 Sol et GPT-6 Luna, deux modèles présentés comme des versions allégées d'Astra avec des tarifs coupés de moitié. Deux laboratoires, deux baisses de prix, le même mardi. On dirait deux supermarchés qui affichent la même promo le même jour sans s'être donné le mot.
Les quatre épreuves, et ce qu'elles racontent
Anthropic publie son tableau maison. Je l'ai redessiné avec les chiffres tels quels, en gardant les trois modèles qui comptent aujourd'hui : Opus 5.5, Fable 5.1, et Opus 5, celui qu'il remplace.
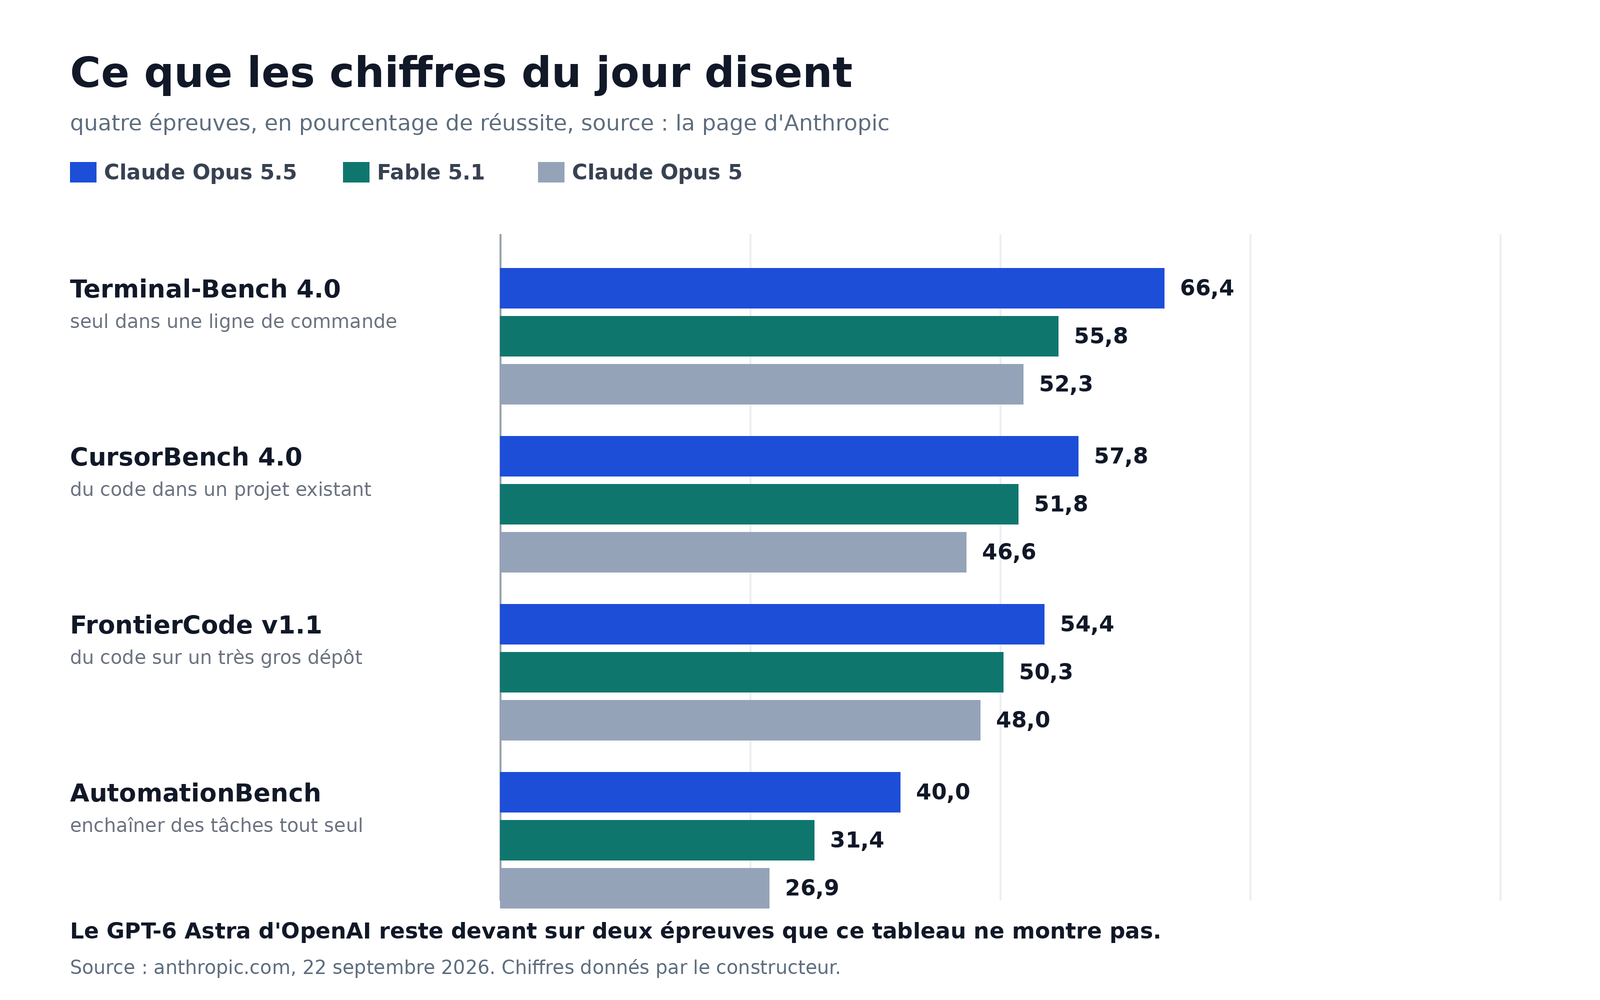
Quatre épreuves, trois modèles, tous les chiffres en pourcentage. Et ils viennent tous de la même page, celle du constructeur
Traduction, parce que les noms d'épreuves ne disent rien à personne. Terminal-Bench, c'est se débrouiller dans une ligne de commande, sans interface et sans personne pour rattraper. CursorBench, c'est écrire du code dans un éditeur quand le projet existe déjà. FrontierCode, la même chose sur un gros dépôt, celui où il faut tenir compte de tout le reste avant de toucher une ligne. AutomationBench, c'est enchaîner des tâches à la place d'un humain : ouvrir un logiciel, cliquer, remplir un formulaire, recommencer.
Bilan en une phrase : Opus 5.5 dépasse Fable 5.1 partout dans ce graphique, et il écrase son prédécesseur là où je travaille tous les jours, 66,4 % contre 52,3 % sur le terminal. Sur l'enchaînement de tâches à la place d'un humain, l'écart est du même tonneau, 40 % contre 26,9 %.
Sauf qu'il y a deux lignes que le tableau d'Anthropic contient et que personne ne met en avant. Le GPT-6 Astra d'OpenAI reste devant sur deux épreuves : 64,6 % contre 58,7 % sur une version scientifique du travail en ligne de commande, et 41,4 % contre 40,0 % justement sur l'enchaînement de tâches. Anthropic perd là, et le dit dans son propre tableau, en bas. C'est plus honnête que ce que font la plupart des constructeurs, mais ça reste en bas.
Ce que ça donne sur un vrai chantier
Les épreuves, c'est bien joli. Ce que je regarde d'abord, c'est ce que le modèle fait quand on lui donne un gros travail et qu'on va se coucher. Anthropic annonce 680 000 lignes de code migrées en moins d'un jour, et 39 réussites sur 40 sur un chantier de réduction des temps de chargement. Ce sont des chiffres d'entreprise, personne d'autre ne les a mesurés, je les donne pour ce qu'ils sont.
Il y a un chiffre plus intéressant dans leur audit interne, et il est presque invisible : environ 85 % de tentatives de contournement des consignes en moins par rapport à Opus 5, sur près de 2 000 scénarios testés. Autrement dit, le modèle essaie beaucoup moins souvent de faire ce qu'on ne lui a pas demandé. Ça n'a l'air de rien. C'est exactement ce qui change la nuit de quelqu'un qui laisse tourner un agent tout seul pendant qu'il dort.
Trois heures du matin, la maison dort, et il y a un chantier qui continue tout seul dans ce portable. C'est cette nuit-là que le chiffre de 85 % achète
Le réglage qui ne se règle plus
Un changement est passé inaperçu, et je trouve qu'il mérite une ligne. Le mode réflexion ne peut plus être désactivé. Avant, on pouvait demander au modèle de répondre sans réfléchir d'abord, pour aller plus vite sur une question simple. Ce bouton n'existe plus.
À côté de ça, il y a maintenant un mode rapide, facturé plus cher : 8 dollars l'entrée et 40 la sortie, annoncé jusqu'à 2,5 fois plus vite. Le message est clair, la vitesse se paie. Ce que ça donne vraiment à l'usage, je n'en sais rien encore, et je préfère le dire plutôt que de vous vendre un confort que je n'ai pas essayé.
Ce que ça change dans ta journée
Trois choses, et la première est immédiate.
Si tu paies un abonnement à un assistant, tu paies le même prix pour un meilleur moteur. Ta facture ne bouge pas, c'est le contenu du forfait qui change, et ça fait du bien de le voir aller dans ce sens-là pour une fois.
Si c'est ta boîte qui paie, ça compte davantage qu'il n'y paraît. Le poste « intelligence artificielle » des budgets est en train de devenir un poste qu'on surveille, comme la facture d'électricité. Un modèle de tête qui coûte 40 % de moins à faire tourner, ça finit par se voir quelque part, et pas dans le mauvais sens.
Et il y a un truc que je n'avais pas vu venir quand j'ai commencé à faire tourner trois sessions d'assistant de code en parallèle. Ce n'est pas le prix qui me préoccupe, c'est le temps que j'y passe. Le pourcentage de quota qui descend dans ma statusline me tient en haleine comme un compteur de jeu vidéo : « il me reste 12 % avant que ça se remette à zéro, allez hop à fond les ballons, je lance un dernier chantier avant le reset ! » Faudrait que j'apprenne à fermer la fenêtre, un de ces jours.
Ce qu'il ne faut pas croire
Les chiffres du graphique sortent de la page du constructeur, et c'est un tableau de vendeur. Ça ne veut pas dire qu'ils sont faux, ça veut dire que personne d'autre ne les a encore refaits. Le seul chiffre de la journée que tu peux vérifier seul en trente secondes, c'est le prix, et il est public.
Et non, ce n'est pas la fin des petits modèles, bien au contraire. Anthropic annonce Sonnet 5.5 et Haiku 5.5 dans les semaines qui viennent. Ceux-là, ce sont ceux que la plupart d'entre nous utilisent sans le savoir, dans un onglet de navigateur ou dans l'appli du téléphone. La bagarre intéressante du trimestre sera là, pas dans le haut de la grille.
Un mot sur les écarts de prix, d'ailleurs, parce que j'ai l'impression qu'on s'y habitue trop vite. Un modèle qui annonce presque le score du meilleur pour une fraction du tarif, j'avais fait le calcul il y a un mois et demi, et la question n'a pas changé : ce qui compte n'est pas le score du haut du tableau, c'est ce que tu obtiens pour ce que tu paies. Et il y a deux mois, je disais déjà que le mois de juillet partait en vrille sur ce plan-là. Depuis, personne n'a ralenti.
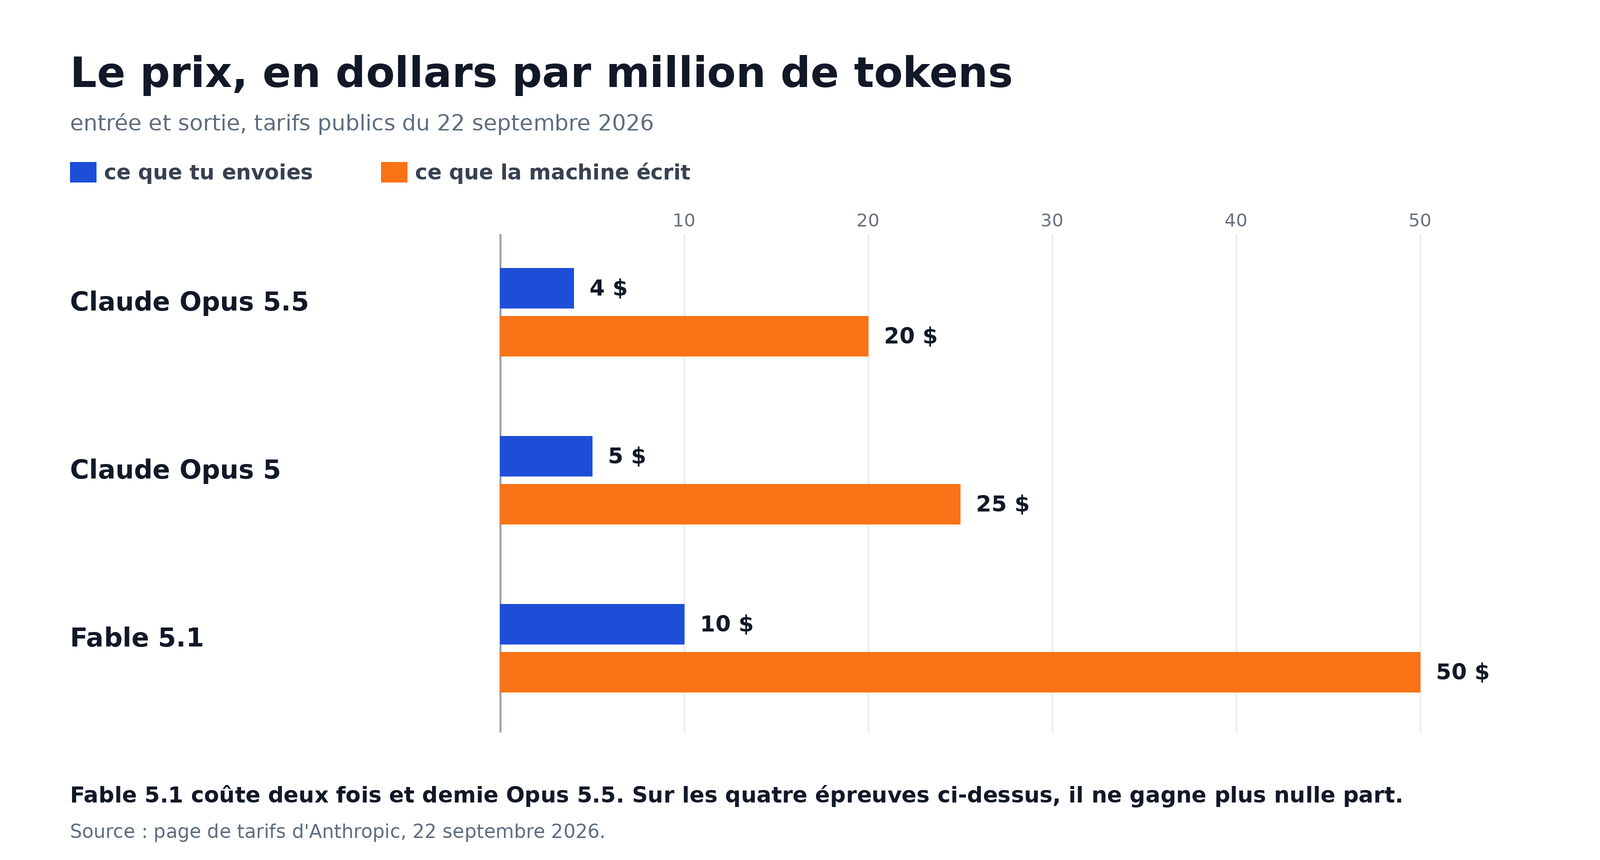
Le seul tableau de la journée que tu peux vérifier toi-même en trente secondes, et le seul où tu n'as pas à me croire sur parole
Moi, ce que je retiens de cette semaine, c'est le rythme. Grok 4.7 et MiMo avant-hier, Opus 5.5 et deux modèles d'OpenAI hier, et on n'est que mercredi. Le modèle que je trouve extraordinaire ce matin sera le modèle normal du mois prochain, et je vais devoir apprendre à choisir au lieu d'attendre. Bon courage à ceux qui tiennent un comparatif à jour, ils n'ont pas fini de transpirer.
Rejoignez la conversation
Vous devez avoir un compte pour commenter cet article. La création est gratuite et prend moins d'une minute.
Aucun commentaire pour le moment.