Combien un développeur doit-il vraiment consacrer à l'IA chaque mois ?
J'ai mesuré ma consommation réelle pendant quatorze jours. J'ai ensuite appliqué les grilles tarifaires officielles du marché pour calculer le prix au million de tokens de chaque offre. Cette fois, je commence par la réponse. La première version de cet article donnait tous les chiffres, mais ne répondait pas clairement à la question.
Voici donc la réponse. Les tableaux viennent après.
Ce que tu dois prendre, tout de suite
| Ton cas | Ce que tu prends | Par mois | En euros TTC |
|---|---|---|---|
| Tu apprends ou tu bricoles le soir | GLM-4.7 Flash en API, gratuit, et Ollama sur ta machine | 0 $ | 0 € si tu as déjà la carte graphique |
| Tu codes pour gagner ta vie | Claude Pro pour le jugement, GLM Coding Lite pour le volume, un fond d'API DeepSeek pour les débordements | 58 $ | environ 65 € |
| L'IA est ton poste de travail, du matin au soir | Claude Max 20x, plus GLM Coding Pro comme second moteur | 272 $ | environ 303 € |
| Vous êtes cinq | Copilot Business à 19 $ par siège, un GLM Coding Pro partagé, un fond de crédits pour les tests | 190 $ | environ 212 €, récupérables si tu as une société |
Et si tu ne veux vraiment pas y réfléchir, prends Claude Pro à 20 $. Tu ne feras pas une mauvaise affaire. Tu paieras simplement un peu trop cher le jour où tu atteindras le plafond.
Voilà. Tu peux fermer l'onglet. La suite explique comment j'arrive à cette réponse. Elle montre surtout pourquoi le prix affiché par un éditeur n'a presque aucun rapport avec ce que tu vas réellement payer.
Le prix affiché ment, et je peux te dire de combien
Un abonnement ne vend plus directement des tokens. Claude Pro, ChatGPT Plus et GLM Coding Plan vendent des fenêtres de cinq heures et des plafonds hebdomadaires. Pour calculer un prix au million de tokens, il faut donc connaître sa consommation réelle. Je suis allé mesurer la mienne.
J'ai analysé les journaux de mes sessions Claude Code dans ~/.claude/projects : 724 fichiers, du 28 juillet au 11 août 2026. Mon script additionne les tokens déclarés par l'API dans chaque réponse, puis applique la grille tarifaire d'Anthropic.
| Ce que j'ai mesuré | Résultat |
|---|---|
| Période | 14 jours, du 28/07 au 11/08/2026, 724 fichiers de session |
| Tokens consommés | 5,85 milliards |
| Ce que l'API m'aurait facturé | 4 867 $, soit environ 10 400 $ par mois |
| Coût moyen au million | 0,84 $, et non 5 $ ou 25 $ |
| Lecture de cache | 95,81 % du volume |
| Écriture de cache | 3,60 % du volume |
| Sortie, le code réellement écrit | 0,55 % du volume |
| Entrée jamais vue auparavant | 0,04 % du volume |
Claude Opus 5 coûte 5 dollars par million de tokens en entrée et 25 en sortie. Pourtant, mon coût réel tombe à 0,84 dollar. Pourquoi ? Un agent de code passe son temps à relire le même dépôt. Ces relectures viennent du cache, une copie du contexte conservée par le fournisseur et facturée dix fois moins cher. Elles représentent presque tout le volume. Le code réellement produit, lui, ne compte que pour un demi pour cent.
Les comparatifs qui supposent 70 % d'entrée et 30 % de sortie arrivent à 11 dollars par million avec la grille d'Opus 5. Moi, je mesure 0,84 dollar. Leur résultat est treize fois trop élevé.
Mais un autre résultat m'a fait relever la tête. Je ne l'avais pas remarqué dans la première version.
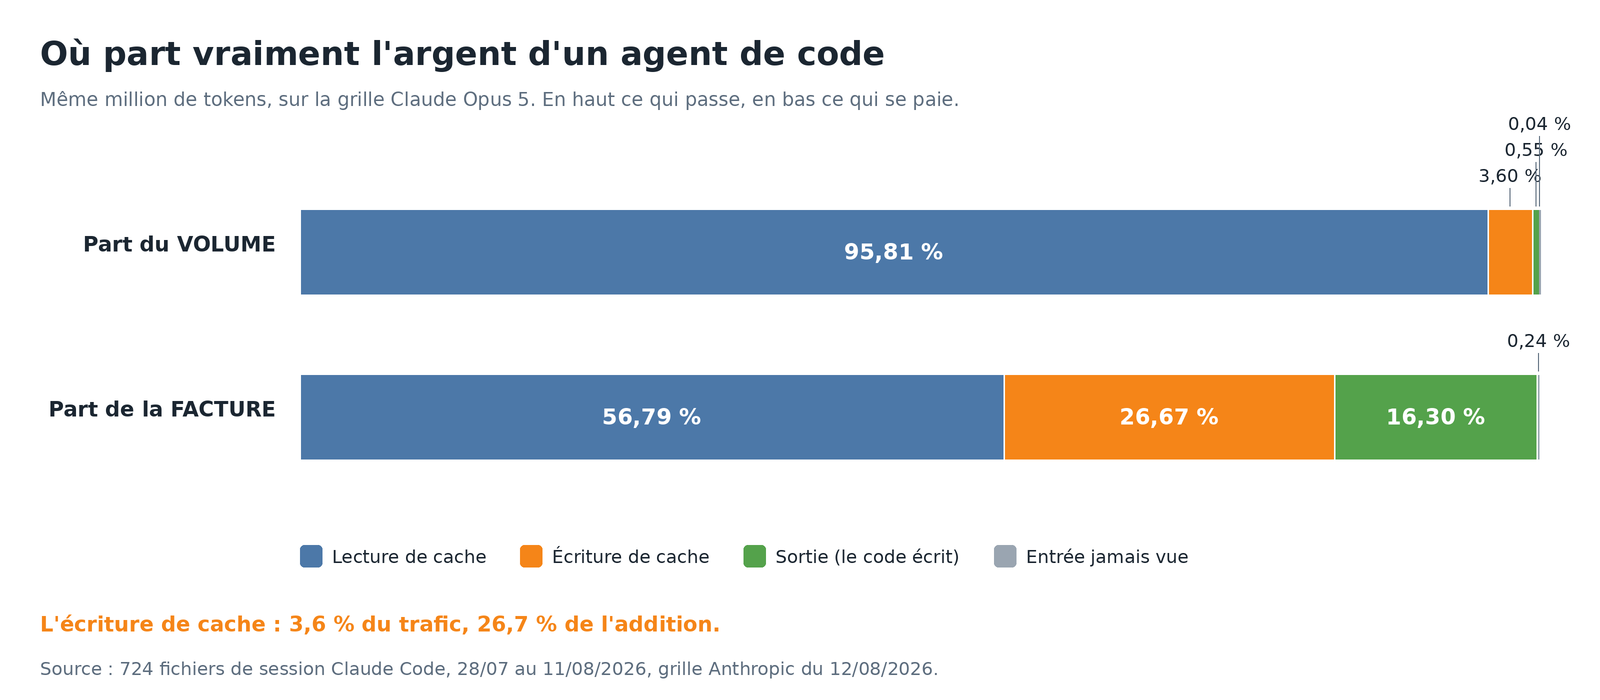
Trois virgule six pour cent du volume, vingt-sept pour cent de l'addition. L'écriture de cache, c'est le pop-corn du cinéma.
La lecture du cache représente 95,81 % du volume, mais seulement 57 % de la facture. L'écriture du cache ne pèse que 3,6 % du volume, mais 27 % du prix. Un quart de l'addition pour environ un trentième du trafic. C'est là que part ton argent. Et personne n'en parle, parce que ce coût n'apparaît clairement sur aucune page de tarifs.
J'applique donc une règle simple dans toute la suite : je recalcule chaque ligne avec ses quatre tarifs, l'entrée, la lecture du cache, l'écriture du cache et la sortie. Pas de formule universelle. Un modèle sans cache facture chaque relecture au prix fort. La différence est brutale.
effectif = cache_lecture x 0,9581
         + cache_ecriture x 0,0360
         + sortie x 0,0055
         + entree x 0,0004
Deux réserves. Mon usage est extrême : j'orchestre plusieurs sous-agents en parallèle, ce qui explique les vingt heures cumulées de session par jour dans la mesure. Je n'ai pas non plus testé les quarante offres de cet article. J'utilise Claude Code tous les jours et j'ai bricolé avec Ollama. Pour le reste, je m'appuie sur les grilles officielles.
Le tableau, en une seule fois
Voici tout le marché dans un seul tableau, du moins cher au plus cher. L'indice de capacité est le mien. Je l'ai construit à partir des résultats SWE-bench Verified et SWE-bench Pro relevés sur BenchLM le 10 août, puis complété par mon ressenti lorsqu'aucun score public n'était disponible. Une astérisque signale les estimations. Les prix viennent directement des sources officielles.
| Modèle | Indice | Entrée | Cache | Sortie | Effectif | Où l'avoir |
|---|---|---|---|---|---|---|
| GLM-4.7 Flash | 48* | gratuit | gratuit | gratuit | 0 $ | API et local |
| DeepSeek V4 Flash | 60* | 0,14 $ | 0,0028 $ | 0,28 $ | 0,009 $ | API |
| DeepSeek V4 Pro | 74* | 0,435 $ | 0,0036 $ | 0,87 $ | 0,024 $ | API, poids ouverts |
| GPT-5.6 Luna | 58* | 0,20 $ | 0,02 $ | 1,20 $ | 0,033 $ | API et abonnement |
| MiniMax M2 | 64* | 0,30 $ | 0,03 $ | 1,20 $ | 0,049 $ | API |
| Qwen3 Coder Next | 66* | 0,30 $ | 0,03 $ | 1,50 $ | 0,051 $ | API, poids ouverts |
| Qwen3.7 Plus | 68* | 0,40 $ | 0,04 $ | 1,60 $ | 0,065 $ | API |
| GLM-4.7 | 70* | 0,60 $ | 0,06 $ | 2,20 $ | 0,091 $ | API, poids ouverts |
| Claude Haiku 4.5 | 62* | 1,00 $ | 0,10 $ | 5,00 $ | 0,169 $ | API et abonnement |
| GLM-5.2 | 76* | 1,40 $ | 0,14 $ | 4,40 $ | 0,209 $ | API et abonnement |
| Kimi K2.7 Code | 72* | 0,95 $ | 0,19 $ | 4,00 $ | 0,239 $ | API, poids ouverts |
| GPT-5.3 Codex | 82* | 1,75 $ | 0,175 $ | 14,00 $ | 0,308 $ | API et abonnement |
| GPT-5.6 Terra | 84* | 2,00 $ | 0,20 $ | 12,00 $ | 0,330 $ | API et abonnement |
| Gemini 3.1 Pro | 80* | 2,00 $ | 0,20 $ | 12,00 $ | 0,330 $ | API et abonnement |
| Claude Sonnet 5 | 86 | 2,00 $ | 0,20 $ | 10,00 $ | 0,337 $ | API et abonnement |
| Grok 4.5 | 75* | 2,00 $ | 0,30 $ | 6,00 $ | 0,393 $ | API et abonnement |
| GPT-5.4 | 78* | 2,50 $ | 0,25 $ | 15,00 $ | 0,413 $ | API et abonnement |
| Kimi K3 | 78* | 3,00 $ | 0,30 $ | 15,00 $ | 0,479 $ | API, poids ouverts |
| GPT-5.6 Sol | 88* | 5,00 $ | 0,50 $ | 30,00 $ | 0,826 $ | API et abonnement |
| Claude Opus 5 | 100 | 5,00 $ | 0,50 $ | 25,00 $ | 0,844 $ | API et abonnement |
| Claude Fable 5 | 98 | 10,00 $ | 1,00 $ | 50,00 $ | 1,687 $ | API et abonnement |
| GPT-5.5 Pro | 85* | 30,00 $ | aucun | 180,00 $ | 30,825 $ | API |
Les prix sont indiqués en dollars par million de tokens. Ils ont été relevés le 12 août 2026 sur les pages officielles. La colonne « Cache » correspond au tarif de lecture du cache.
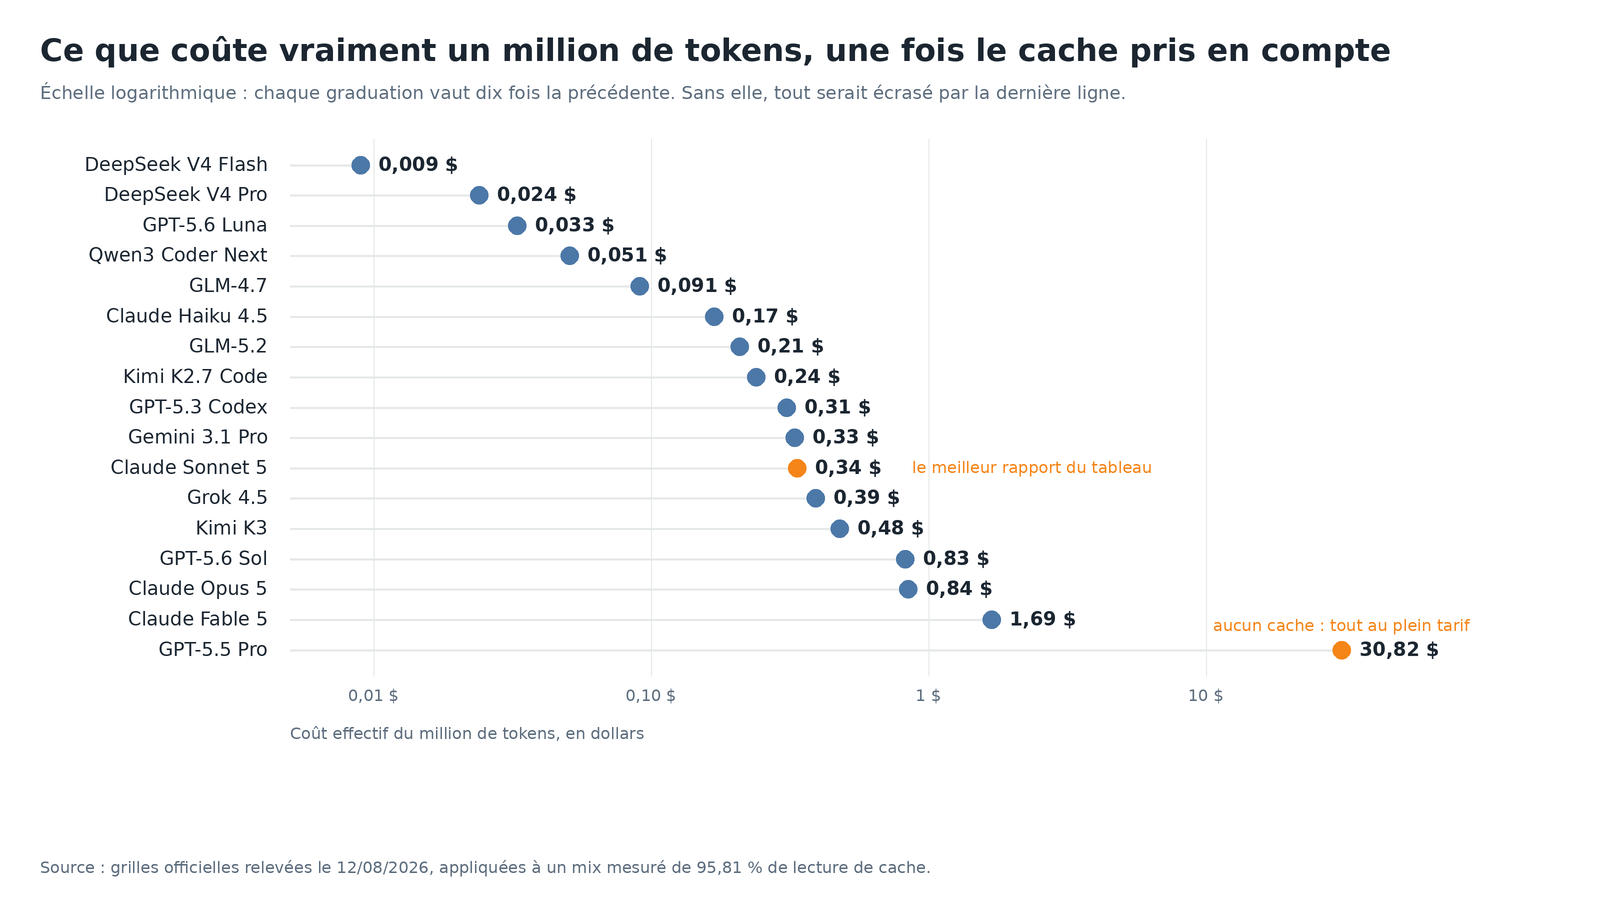
Quatre-vingt-dix fois d'écart de prix. Deux fois d'écart de capacité. Cherchez l'erreur.
Quatre constats sautent aux yeux. Le dernier corrige une erreur repérée par un lecteur très attentif : moi-même, deux jours plus tard.
D'abord, le tarif de lecture du cache décide presque de tout. DeepSeek facture cette lecture 0,0028 dollar, soit 2 % du prix d'entrée. La plupart des autres fournisseurs appliquent 10 %. Pour un agent qui relit son contexte en boucle, cet écart compte davantage que le prix d'entrée affiché. DeepSeek V4 Flash tombe ainsi sous le centime par million, soit quatre-vingt-treize fois moins cher qu'Opus 5.
Ensuite, deux fournisseurs facturent le cache plus cher que la moyenne, et cela passe presque inaperçu. Kimi K2.7 facture la lecture à 0,20 fois le prix d'entrée. Grok 4.5 la facture à 0,15 fois, contre 0,10 presque partout ailleurs. Leur coût réel grimpe ainsi de 50 % et de 25 %.
Troisièmement, Gemini ajoute un piège que je n'ai vu nulle part ailleurs. En plus de la lecture, Google facture le stockage du cache à 4,50 dollars par million et par heure. Si tu laisses le cache ouvert pendant le déjeuner, il continue à te coûter de l'argent sans relire le moindre token. Pchhh. Maintenant, tu le sais.
Enfin, GPT-5.5 Pro. Ce modèle n'a aucun tarif de cache. Dans la première version, je lui avais quand même appliqué une remise de cache. Bête comme faute, énorme comme conséquence. Sans cache, les 95,81 % de relecture sont facturés au prix fort : 30,83 dollars le million, soit trente-sept fois Opus 5, et non six fois comme je l'avais écrit. Il fait moins bien en code et coûte trente-sept fois plus. Pour un agent, ce n'est pas cher. C'est éliminatoire.
Deux seuils méritent aussi ton attention. Gemini et Grok doublent leurs tarifs au-delà de 200 000 tokens de contexte. Chez Grok, ce doublement s'applique à toute la requête, pas seulement aux tokens qui dépassent le seuil. GPT-5.6 applique le même piège à 272 000 tokens. Quand le contexte franchit la limite, la facture ne monte pas doucement. Elle double d'un coup.
Les abonnements, et ce qu'ils cachent vraiment
Ici, on quitte les grilles tarifaires publiques pour entrer dans le flou. Le tableau montre deux choses : le prix de l'offre et ce que l'éditeur publie réellement sur son plafond. La seconde colonne en dit déjà long.
| Offre | Par mois | Ce que le plafond dit vraiment |
|---|---|---|
| Claude Pro | 20 $, ou 17 $ en annuel | Fenêtres de 5 h, plafond hebdomadaire, aucun chiffre publié |
| Claude Max 5x | 100 $ | Cinq fois Pro, toujours sans chiffre |
| Claude Max 20x | 200 $ | Vingt fois Pro. Chez moi, mesure obtenue : 12,5 milliards de tokens par mois, soit 0,016 $ le million |
| GLM Coding Lite | 18 $ | 10 000 crédits par semaine, chiffre publié. Environ 43 à 87 Mtok selon ton taux de cache |
| GLM Coding Pro | 72 $ | 60 000 crédits par semaine, chiffre publié |
| GLM Coding Max | 160 $ | 140 000 crédits par semaine, chiffre publié |
| ChatGPT Plus | 20 $ | 15 à 90 messages par fenêtre de 5 h sur Sol, avec une grille en crédits par million désormais publiée |
| ChatGPT Pro | 100 $ pour 5x, 200 $ pour 20x | Multiples de Plus. Pas d'illimité, la documentation le précise |
| ChatGPT Business | 25 $ le siège, 20 $ en annuel | 3 000 requêtes par semaine sur le modèle de raisonnement |
| Google AI Pro | 21,99 € | 1 500 requêtes par jour sur Code Assist |
| Google AI Ultra | 99,99 € | 2 000 requêtes par jour |
| SuperGrok | 30 $ | Un quota hebdomadaire exprimé en pourcentage. Aucun chiffre absolu |
| GitHub Copilot Pro | 10 $ | 10 $ de crédits, consommés au tarif API |
| GitHub Copilot Pro+ | 39 $ | 39 $ de crédits |
| GitHub Copilot Business | 19 $ le siège | 19 $ de crédits par siège |
| Cursor Pro | 20 $ | 20 $ d'usage inclus, au tarif API |
| Cursor Ultra | 200 $ | 400 $ d'usage inclus |
| Zed Pro | 10 $ | 5 $ de crédits, puis tarif API majoré de 10 % |
| Le Chat Pro | 14,99 $ | 150 réponses rapides par jour |
Trois remarques:
GitHub Copilot est passé à la facturation à l'usage le 1er juin 2026. Tu paies 10 dollars et tu obtiens 10 dollars de crédits. Un pour un. Ce n'est donc plus vraiment un forfait, mais une API entourée d'un éditeur. Même chose chez Cursor et Zed, qui te revendent des tokens au tarif de l'éditeur avec une enveloppe mensuelle. Le mot « abonnement » ne veut plus dire grand-chose pour la moitié de ce tableau.
GLM reste le seul à publier son plafond dans des unités vérifiables. Son système a changé le 30 juillet : on ne compte plus en « prompts » mais en crédits, avec 10 000 crédits par semaine pour l'offre Lite. Mon équivalence en tokens suppose un taux de cache de 90,9 %. Ce chiffre vient de la documentation, pas de mon chapeau. Les autres fournisseurs se cachent derrière des fenêtres de cinq heures impossibles à vérifier. Claude est le pire sur ce point, alors que c'est justement celui que j'utilise. Ça m'embête de l'écrire, mais c'est vrai.
Mon propre chiffre reste le plus parlant. En quatorze jours, j'ai consommé l'équivalent de 4 867 dollars d'API. Comparé au prix de Max 20x sur la même période, cela donne un rapport de 52 pour 1. Aucun forfait ne peut être rentable avec ce profil. Soit Anthropic subventionne massivement l'usage, soit les plafonds empêchent presque tout le monde d'atteindre ce niveau. Probablement les deux. Je ne vais pas m'en plaindre trop fort.
Les quatre piles, et quand elles craquent
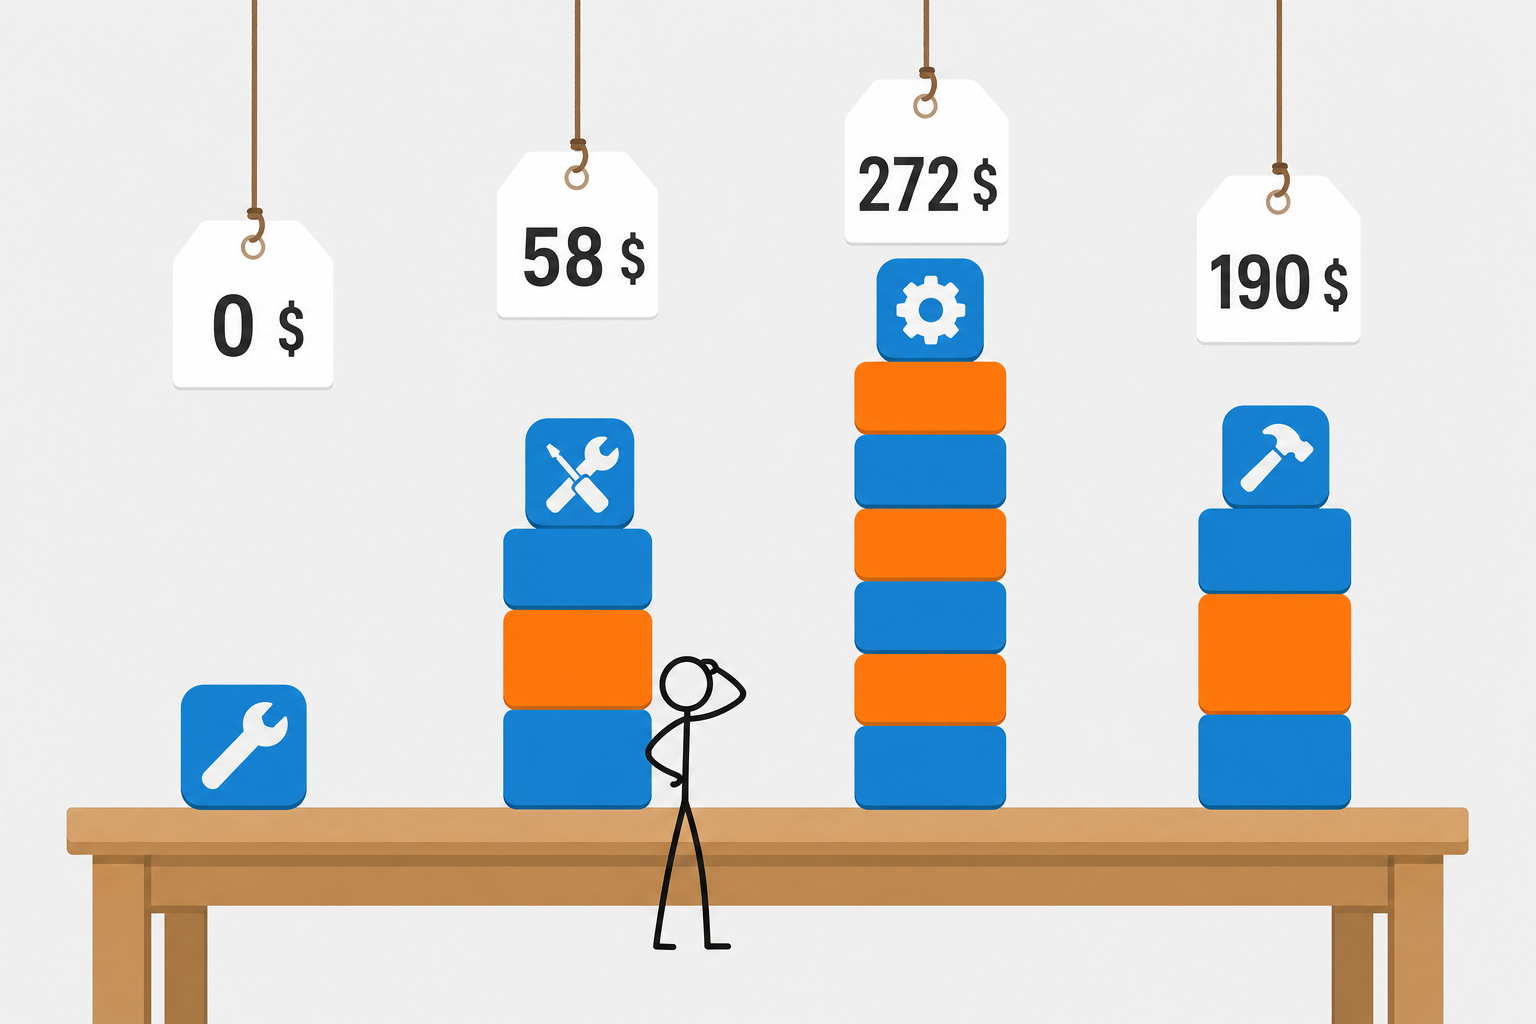
Quatre étages. Le seul choix à faire, c'est de savoir sur lequel tu habites.
Tu apprends, 0 $. GLM-4.7 Flash en API fait le gros du travail. Ollama s'occupe de l'autocomplétion et du travail hors ligne. Cette pile craque dès qu'une tâche exige un vrai raisonnement : le modèle tourne en rond, et tu dois savoir reprendre la main. Elle n'est vraie que si tu possèdes déjà une carte graphique. Sinon, compte 1 500 euros pour une 4090 d'occasion, soit 42 euros par mois avec un amortissement sur trois ans. Le gratuit a une facture.
Tu codes pour vivre, 58 $. Claude Pro à 20 $ apporte le jugement. GLM Coding Lite à 18 $ fournit le volume. Environ 20 $ d'API DeepSeek absorbent les débordements. Tu fais poser la base par le modèle bon marché, puis tu demandes au meilleur de la peaufiner. Avec 20 dollars, DeepSeek V4 Flash fournit plus de deux milliards de tokens au tarif effectif. Oui, deux milliards. Cette pile craque si tu passes toutes tes journées dedans. Claude Pro atteint alors son plafond avant le reste. C'est le signal pour passer à Max.
L'IA est ton métier et tu programmes encore au soir, 272 $. Claude Max 20x sert de moteur principal. GLM Coding Pro tourne en parallèle comme second moteur. C'est à peu près ma pile. Le calcul est simple : ma consommation coûterait 10 400 dollars par mois avec l'API. Même en la divisant par cinq pour représenter un usage plus raisonnable, l'abonnement reste dix fois moins cher. Ce qu'on y perd ? 272 dollars. À ce niveau, tu paies surtout pour ne plus regarder le compteur. Honnêtement, ça vaut le prix.
L'IA est ton métier mais tu ne programmes plus le soir et le week-end: Un abonnement Claude Code Max x20 a 200$ bien optimisé (pas de gros Claude.md, Roslyn en mcp si tu code du .Net (ca évite les 'grep' à tout va)) pourrait aussi être suffisant, à toi de voir ta consommation
Vous êtes cinq, 190 $. Copilot Business coûte 19 $ par siège et couvre l'autocomplétion ainsi que l'intégration aux dépôts. Un GLM Coding Pro partagé à 72 $ prend les gros chantiers. Une vingtaine de dollars de crédits OpenRouter permet de tester d'autres modèles sans ouvrir cinq comptes. Le défaut, c'est que personne n'a en permanence accès à un modèle de pointe. Si toute l'équipe utilise des agents lourds toute la journée, il faut passer à des sièges Claude Team. Le budget change alors d'ordre de grandeur.
Le local et les agrégateurs, deux détours à connaître
Le local n'est pas gratuit. C'est probablement le mensonge le plus répandu sur le sujet. L'électricité coûte peu : avec 350 watts en charge au tarif belge, on arrive à environ 0,55 euro par million de tokens produits. Le vrai coût, c'est la carte graphique. Une 4090 d'occasion tourne autour de 1 500 euros, soit 42 euros par mois sur trois ans, avant même d'avoir écrit une ligne. Une 3090 d'occasion à 700 euros fait tourner les mêmes modèles, environ 20 % moins vite, mais divise l'amortissement par deux.
| Modèle local | Indice | VRAM | Débit sur RTX 4090 | Ce que j'en pense |
|---|---|---|---|---|
| Qwen3-Coder 30B | 55* | 19 Go | 40 à 60 tok/s | Le meilleur choix. Son architecture à experts n'active que 3,3 milliards de paramètres, ce qui le rend rapide malgré sa taille. Son contexte de 256K est énorme pour du local. Il faut une carte de 24 Go |
| Qwen3.6 27B | 50* | 17 Go | environ 30 tok/s | Modèle dense, donc tous les paramètres travaillent à chaque token. Il est presque deux fois plus lent pour un résultat comparable |
| GLM-4.7 Flash | 48* | 19 Go | non mesuré chez moi | Un contexte de 198K et le même gabarit. C'est une solution crédible, également disponible dans une API gratuite si tu préfères garder ta carte pour autre chose |
| Kimi et DeepSeek complets | 70 et plus* | 200 Go et plus | très lent | Superbes sur le papier, impraticables sur un PC de développeur. Il faut une station équipée de plusieurs cartes ou un Mac avec 128 Go, et le résultat reste poussif. À réserver aux curieux |
L'écart de capacité est bien réel. Un modèle local qui tient dans 19 Go de mémoire vidéo atteint environ 55 sur mon indice, contre 100 pour Opus 5. Ce n'est pas une simple différence de finition. C'est l'écart entre un assistant qui complète une ligne et un agent qui refactorise seul un module. Le local sert surtout à l'autocomplétion, aux tâches mécaniques et au code qui ne doit quitter aucune machine. Pour le reste, une API bon marché coûte moins cher que l'amortissement de la carte.
Passons aux agrégateurs. Ce sont des intermédiaires qui fournissent un compte et une seule facture pour accéder à des dizaines de modèles.
OpenRouter ne prend aucune marge sur l'inférence. Sa documentation l'indique clairement. Le service se rémunère sur le rechargement des crédits, avec 5,5 % de frais par carte bancaire. Surprise, il peut même être moins cher que l'éditeur, car il dirige la requête vers le fournisseur le moins cher de son réseau. Kimi K2.7 y coûte 0,68 dollar, contre 0,95 chez Moonshot. J'avais écrit « pour du volume, va direct chez l'éditeur ». Il faut donc vérifier au cas par cas, car ce n'est plus toujours vrai.
Together AI affiche lui aussi des prix inférieurs à ceux de certains éditeurs. Hugging Face annonce une marge nulle et offre 2 dollars de crédits par mois aux comptes PRO. Fireworks publie une grille fondée sur la taille du modèle, de 0,10 à 1,20 dollar par million. Chez Cerebras, les deux forfaits Code, à 50 dollars pour 24 millions de tokens par jour et 200 dollars pour 120 millions, sont affichés « sold out ». Voilà ce qui arrive quand on vend de la vitesse.
Ce qui va bouger d'ici l'automne
Commençons par une bonne nouvelle, qui annule une phrase de ma première version. J'avais écrit que le tarif d'introduction de Claude Sonnet 5 expirerait le 31 août, avant de remonter à 3 et 15 dollars, et que je mettrais le tableau à jour en septembre. La hausse est annulée. Anthropic a rendu permanents les tarifs de 2 et 10 dollars. Aucune mise à jour n'est donc prévue. Sonnet 5 reste à 0,337 dollar par million effectif, ce qui lui donne le meilleur rapport entre capacité et prix du tableau.
DeepSeek, à l'inverse, annonce dans sa documentation une hausse significative à venir. Ne construis pas ton budget annuel sur un tarif de 0,009 dollar.
SuperGrok Heavy a également disparu des pages officielles de xAI. Il ne reste que SuperGrok à 30 dollars et SuperGrok Plus à 100. Les montants de 300 dollars qui circulent viennent de blogs, jamais d'une page de l'éditeur.
Ce que je retiens
Le prix affiché d'un modèle ne dit presque rien de ta facture réelle. Le tarif de lecture du cache compte beaucoup, car cette lecture représente 96 % de ce qu'un agent consomme. L'écriture du cache compte aussi, puisqu'elle produit un quart de la facture pour environ un trentième du trafic. Deux modèles affichés au même prix peuvent finir avec un rapport de un à cinq. Quant à un modèle sans cache, il est éliminé d'office, quel que soit son score.
L'écart de prix entre le haut et le bas du tableau atteint environ quatre-vingt-dix fois, contre seulement deux fois pour la capacité. Cela ne rend pas les modèles haut de gamme inutiles. Si un petit modèle échoue sur une tâche, son faible prix ne sert à rien. Seul le résultat compte. En revanche, envoyer chaque tâche au modèle le plus cher reste du gaspillage pur. Une bonne pile combine donc deux modèles.
Si tu ne dois retenir qu'un chiffre, retiens celui-ci : pour 40 à 60 dollars par mois, soit environ 45 à 65 euros TTC, un développeur indépendant peut aujourd'hui accéder à une puissance qui coûtait plusieurs milliers de dollars il y a un an. La question n'est plus « est-ce que ça vaut le coup ». Elle est « quelle combinaison ». La réponse est en haut de la page.
Article écrit le 12 août 2026, les prix pourraient changer entre-temps.
Rejoignez la conversation
Vous devez avoir un compte pour commenter cet article. La création est gratuite et prend moins d'une minute.
Aucun commentaire pour le moment.