Inkling 2 Mini : peut-il tourner sur une carte graphique de particulier ?
Depuis hier, tout le monde ne parle que de ça dans les salons IA : Inkling 2 Mini. Sorti le 20 novembre par Thinking Machines Lab, la boîte de Mira Murati (l'ex directrice technique d'OpenAI), avec une promesse qui fait lever un sourcil : un modèle presque aussi bon que les gros, qui tient dans 20 Go de mémoire au lieu des 50 ou 60 Go habituels. Licence Apache 2.0, donc libre de droits, gratuit à télécharger et à modifier.
Sur le papier, c'est le genre d'annonce qui sent la lessive qui lave plus blanc que blanc. Alors au lieu de recopier le communiqué de presse, j'ai loué une vraie carte graphique sur un serveur, j'ai installé le bazar moi-même, et j'ai regardé ce qui se passe réellement quand on essaie de le faire tourner. Spoiler : ça tient la route sur le papier, et ça devient tout de suite plus compliqué sur une carte de monsieur Tout-le-monde.
Pas de câble réseau sur la photo, et c'est tout le propos : un modèle qui tourne chez toi n'a besoin de rien envoyer ailleurs.
Le truc malin : il relit trois fois le même morceau
Pour comprendre pourquoi ce modèle tient dans si peu de mémoire, il faut regarder comment il est construit, et c'est franchement astucieux. Un modèle de langage classique, c'est une pile d'étages (on les appelle des couches) que chaque mot traverse une fois, dans l'ordre, du premier au dernier. Pour un modèle de la taille d'Inkling, ça fait 48 étages, et il faut les garder TOUS en mémoire en même temps pendant que le modèle travaille.
Inkling 2 Mini fait un tour de passe-passe : il ne stocke que 24 étages, groupés en quatre blocs. Le premier bloc et le dernier ne travaillent qu'une fois. Mais les deux blocs du milieu, eux, ils les font tourner trois fois d'affilée sur le même mot avant de passer à la suite. Résultat : le mot traverse quand même 48 fois un étage au total, exactement comme le modèle classique, mais la machine n'a besoin de garder que la moitié des étages en mémoire à un instant donné. Un peu comme un élève qui relirait trois fois son brouillon avant de le recopier au propre, plutôt que d'écrire d'un coup une version deux fois plus longue.
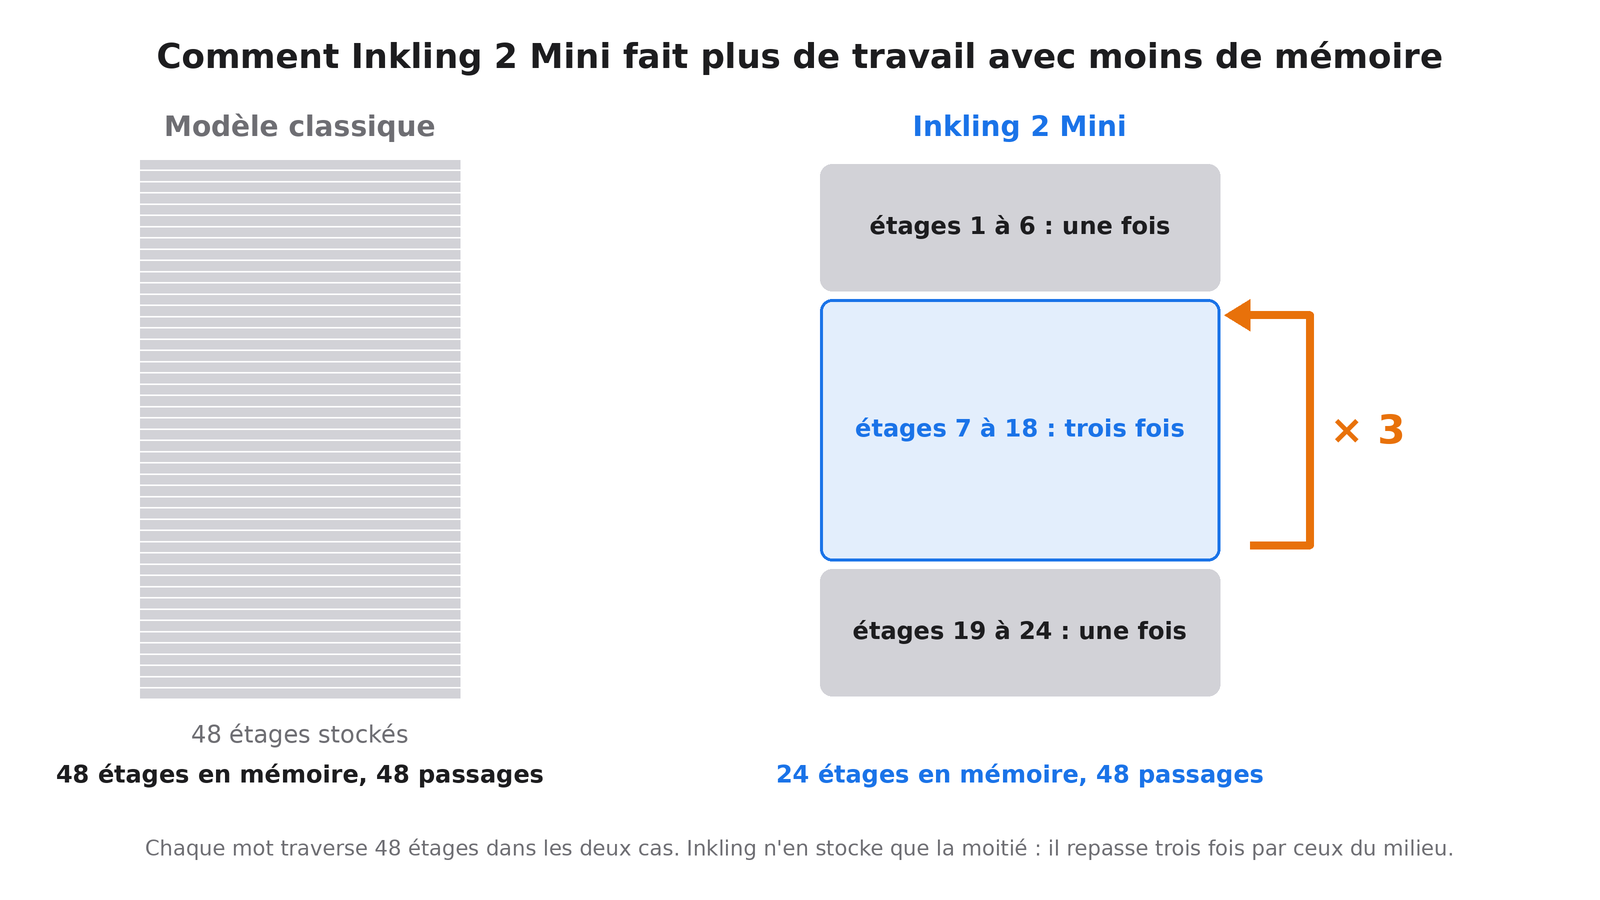
Même nombre de passages, moitié moins d'étages à stocker. C'est tout l'art de relire au lieu d'empiler.
Là où ça devient encore plus radical, c'est qu'Inkling utilise aussi la technique du mélange d'experts (ce n'est pas nouveau, Mistral l'avait déjà fait tourner en 2023 avec Mixtral). Le modèle compte 26,4 milliards de paramètres au total, mais sur les 128 "experts" internes dont il dispose, il n'en active que 8 par mot. C'est comme un hôpital qui aurait 128 portes de spécialistes dans son couloir, et qui ne t'enverrait voir que les 8 bons, sans te faire défiler devant les 120 autres. Pour chaque mot généré, seuls 3,4 milliards de paramètres travaillent vraiment (un peu plus avec les boucles, autour de 5,4 milliards en pratique). C'est ce qui permet d'avoir un gros modèle qui coûte comme un petit à l'usage.
120 portes fermées, 8 qui s'ouvrent. Personne n'a envie de défiler devant tout le service avant de voir le bon médecin, et le modèle non plus.
Ce que le fabricant promet
Autre astuce qui explique le gain de mémoire : le modèle a été entraîné directement en 4 bits (un format de calcul ultra compact que les toutes dernières puces Nvidia savent lire nativement) au lieu des 16 bits habituels. Ça divise la taille par quatre d'un coup. Résultat affiché par Thinking Machines Lab : avec 32 Go de mémoire (un Mac récent, une carte graphique haut de gamme, ou le petit boîtier DGX Spark de Nvidia), ça doit tourner sans problème. Le modèle accepte aussi des images en entrée, et garde en mémoire jusqu'à un million de mots de conversation.
Face à Qwen3.8 27B, un concurrent chinois de taille comparable que j'ai justement utilisé comme point de comparaison, Thinking Machines Lab avance, sur sa fiche technique du 20 novembre, de meilleurs scores sur les tests de correction de bugs réels : 79,2 contre 77,8 sur SWE-bench Verified, un test qui fait corriger de vrais bugs dans de vrais logiciels open source, le genre d'épreuve qu'on ne peut pas tricher en apprenant les réponses par cœur. Le site indépendant Artificial Analysis, qui fait tourner tout le monde sur les mêmes tests pour comparer honnêtement, leur donne le 20 novembre la même note globale (20 sur son indice, qui agrège une dizaine de tests différents), mais avec un argument choc sur le prix : 0,59 dollar en moyenne par tâche contre 3,53 dollars pour Qwen, et 9 minutes contre 38 pour arriver au bout.
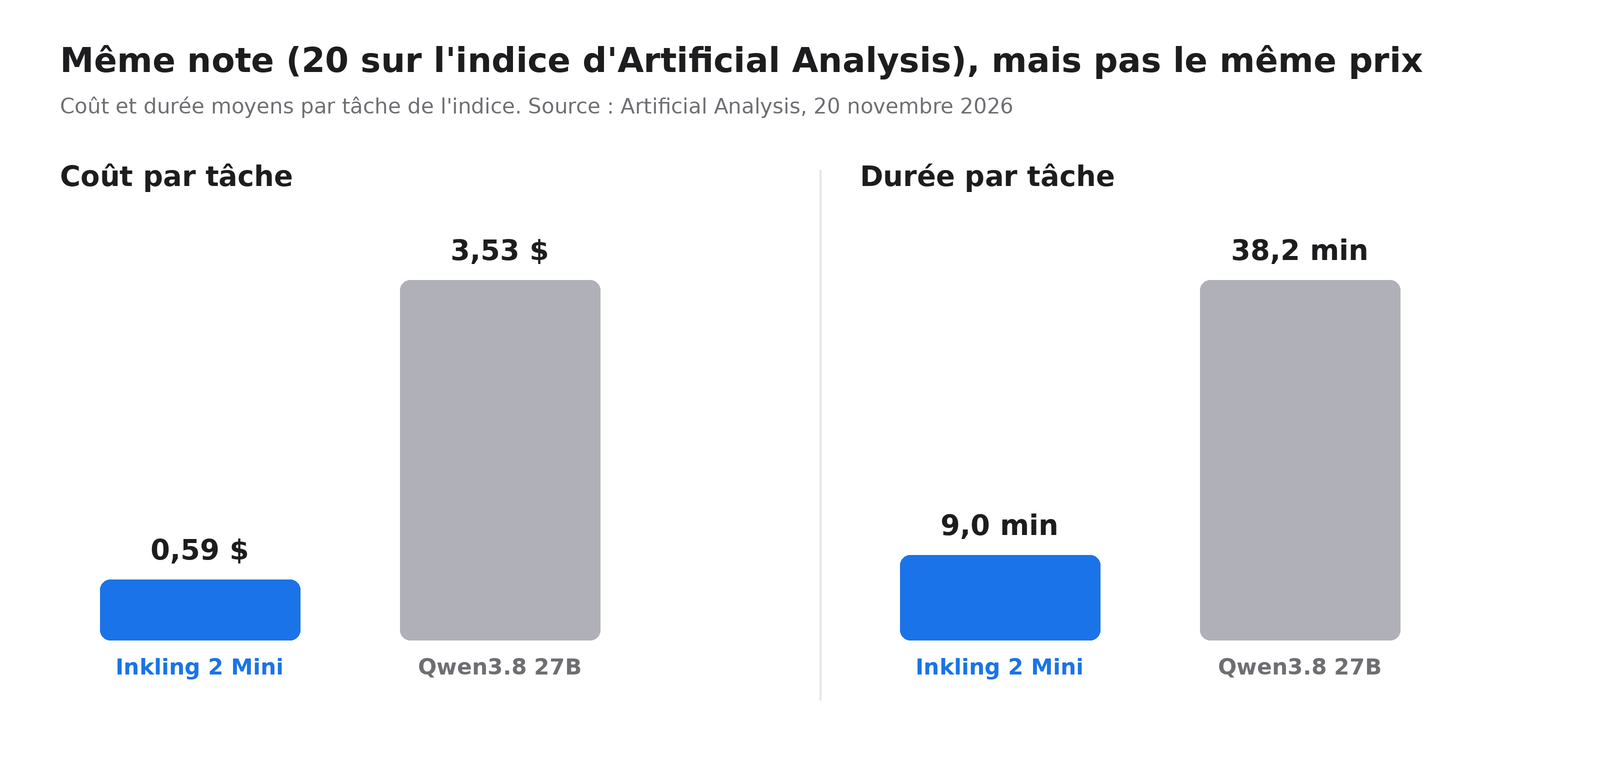
Mêmes notes, facture six fois moins salée. Sur le papier du fabricant, en tout cas.
Ces chiffres-là viennent de centres de données équipés des toutes dernières cartes Nvidia, celles qui lisent le format 4 bits nativement, sans avoir à le traduire à la volée. Sur du matériel plus ordinaire, celui que la plupart d'entre nous avons sous le bureau, l'histoire se corse nettement.
Mon test sur une vraie carte, pas sur un communiqué de presse
Ce samedi 21 novembre, j'ai loué une carte RTX 3090 (24 Go, sortie en 2020, toujours une des plus répandues chez les particuliers) pendant une demi-heure, pour un peu moins de 10 centimes. Dessus, j'ai installé Ollama (le logiciel gratuit le plus utilisé pour faire tourner des IA chez soi) en version 0.40.17, et j'ai fait passer trois modèles sur les mêmes onze questions pièges : du calcul, de la logique, des énigmes à piège, et deux petits programmes à écrire.
Qwen3.8 27B a répondu juste aux onze questions, à 58,9 mots générés par seconde. Inkling 2 Mini a chargé 21,2 Go en mémoire (un peu plus que les 20 Go annoncés), a eu besoin de deux tentatives de démarrage parce que la carte a pris plus de 100 secondes avant de répondre au premier message, et une fois lancé, il a répondu juste à dix questions sur onze... à 5,4 mots par seconde. Presque onze fois plus lent que Qwen, sur la même carte.
Et la question ratée est un clin d'oeil amusant pour un modèle dont l'argument de vente, c'est justement de boucler sur lui-même : je lui ai demandé d'écrire un petit programme FizzBuzz, et il est parti en boucle de génération jusqu'à taper le plafond que j'avais fixé, sans jamais produire de réponse. Le modèle qui boucle intelligemment a bouclé tout court.
J'ai aussi testé la version compressée que propose Unsloth (une entreprise spécialisée dans la réduction de taille des modèles), censée tourner sur des cartes avec moins de mémoire. Résultat : échec complet dans Ollama, avec un message disant que le moteur ne reconnaît pas cette architecture. Les boucles d'Inkling sont une nouveauté technique, et le support dans les outils grand public n'a pas encore rattrapé le retard.
La raison derrière cette lenteur sur ma carte : une RTX 3090 ne lit pas nativement le format 4 bits dans lequel Inkling a été entraîné. Elle doit le traduire à la volée, étage par étage, et visiblement trois fois sur les étages du milieu. Les chiffres impressionnants du fabricant sortent de cartes dernier cri qui n'ont pas ce problème.
Concrètement, ça change quoi pour toi
Si tu n'as jamais touché à une IA locale, voilà pourquoi tout ça compte. Aujourd'hui, quand tu discutes avec ChatGPT ou Claude, tes messages partent sur un serveur appartenant à une entreprise américaine. Un modèle comme Inkling, lui, peut tourner entièrement sur ta propre machine : rien ne sort de chez toi. Utile si tu veux faire relire un contrat, dicter tes comptes, ou poser des questions un peu personnelles sans que ça atterrisse dans les journaux d'un tiers.
Deuxième effet concret : un modèle qui n'active que 8 experts sur 128 par mot consomme beaucoup moins d'électricité qu'un modèle qui ferait tout défiler à chaque fois, exactement comme l'hôpital qui n'ouvre que les bonnes portes. Si tu envisages de laisser une IA tourner chez toi en permanence, ça se voit sur la facture.
Honnêtement, maintenant : sur une carte de 2020 comme la mienne, c'est fonctionnel mais pas agréable à l'usage. Ça tourne bien, aujourd'hui, sur un Mac avec 32 Go de mémoire unifiée ou sur les toutes dernières cartes Nvidia. Pour le reste d'entre nous, il faut attendre que les outils rattrapent cette nouvelle architecture, ce qui ressemble plus à une affaire de semaines ou de mois qu'à une attente sans fin : le mélange d'experts, qui semblait exotique à son arrivée avec Mixtral en 2023, est aujourd'hui banal dans tous les modèles sérieux. Les boucles devraient suivre le même chemin.
Ce que le fabricant admet lui-même
La fiche technique d'Inkling liste elle-même ses défauts, et c'est plutôt honnête de leur part. Le modèle peut se tromper avec beaucoup d'assurance, sans prévenir qu'il n'est pas sûr de sa réponse. Il peut partir dans des boucles de réflexion sans fin (je confirme, je viens de le vivre avec mon FizzBuzz). Branché à un agent capable d'agir sur ton ordinateur, il peut entreprendre des actions irréversibles sans demander confirmation. Il est sensiblement moins bon hors de l'anglais. Et il est étrangement trop prudent sur les questions de santé mentale, au point de refuser d'aider alors que la question était inoffensive.
Est-ce que ça tourne chez toi ?
Pour savoir dans quelle case tu te trouves, pas besoin de démonter ton ordinateur : sur Windows ou Linux, la commande nvidia-smi dans un terminal affiche direct la quantité de mémoire de ta carte, dans la colonne Memory-Usage.
Sur un Mac avec 32 Go de mémoire ou plus : oui, sans souci, grâce à la façon dont Apple partage la mémoire entre le processeur et la puce graphique. Sur une carte graphique de 24 Go comme la mienne : ça charge et ça répond, mais lentement, en attendant que les logiciels s'améliorent, pas besoin de revendre un rein pour une carte à 3000 euros en attendant. Sur une carte de 16 Go : Unsloth annonce une version compressée en 3 bits qui devrait tenir dans 13 à 15 Go, avec une perte de qualité supplémentaire qu'il faudra vérifier soi-même.
C'est d'ailleurs exactement le genre de rattrapage dont je parlais il y a six jours en évoquant la sortie de llama.cpp en version 1.0 : les nouveaux formats de modèles sortent toujours plus vite que le support dans les outils qui les font tourner chez les particuliers. Si tu veux un modèle de cette taille qui fonctionne bien dès aujourd'hui sur ta carte graphique, Qwen3.8 27B, que j'ai utilisé comme référence dans ce test, reste pour l'instant le choix le plus sûr.
Inkling 2 Mini est une vraie trouvaille technique, pas du vent qu'on nous vend. Juste une trouvaille arrivée un peu avant que les outils grand public soient prêts à l'accueillir correctement. Alors si toi aussi tu as une RTX 3090 qui tourne à 5 mots par seconde sur cette bête-là, ne va surtout pas la revendre : laisse-la tranquille, et retente dans deux ou trois mois. Elle n'a rien fait de mal.
Mise à jour : la version sans filtre est déjà là
Il n'aura pas fallu 48 heures. AtomicChat, l'équipe derrière l'application Atomic Chat qui fait tourner des modèles hors ligne, a publié sur Hugging Face (la grande bibliothèque en ligne des modèles d'IA) une version « uncensored » d'Inkling 2 Mini, c'est-à-dire sans filtre. Plus de 9 500 téléchargements au compteur ce 21 novembre au soir. La mode des IA qui ne disent jamais non a encore frappé, et vite.
Comment on enlève les refus d'un modèle sans le réentraîner ? C'est assez malin, et franchement moins sorcier qu'on l'imagine. Ils ont posé au modèle une série de questions qu'il refuse, puis une série de questions banales, en anglais et en russe, et ils ont regardé ce qui change dans sa tête entre les deux. Ce qui change, c'est en gros le réflexe « non merci ». Une fois repéré, ils l'ont effacé, étage par étage, avec un petit correctif de 40 Mo posé sur un modèle de 16 Go. La fiche n'emploie pas le mot, mais c'est le principe de ce qu'on appelle l'abliteration : on n'apprend rien de nouveau au modèle, on lui retire juste l'envie de refuser.
Et ça marche, d'après leurs propres chiffres : sur 81 demandes en anglais que l'original refusait toutes, la version sans filtre n'en refuse plus aucune. Même chose en russe, de 91 refus sur 100 à zéro. Plus intéressant pour la vie de tous les jours, sur 250 questions parfaitement innocentes mais qui sonnent mal (le genre « comment tuer un processus Python », qu'un modèle trop prudent prend pour une menace), l'original en refusait 10, la nouvelle version zéro. Tu te souviens du défaut avoué plus haut, ce modèle trop frileux sur la santé mentale ? C'est exactement ce genre de blocage que ces versions font sauter.
Ça a un prix, et AtomicChat a l'honnêteté de l'écrire. Sur un test de culture générale de 2 000 questions (MMLU), le modèle perd un point et demi, de 80,65 % à 79,15 % de bonnes réponses. Et sur deux de leurs propres critères de qualité, ils écrivent noir sur blanc qu'ils ont raté la cible : les premiers mots des réponses aux questions banales ont plus changé qu'ils ne l'auraient voulu. Rare de voir une équipe publier ses propres ratés, ça mérite d'être salué.
La vraie bonne nouvelle pour les petites configurations, c'est la taille. AtomicChat propose trois versions compressées, et la plus petite descend à 8,67 Go.
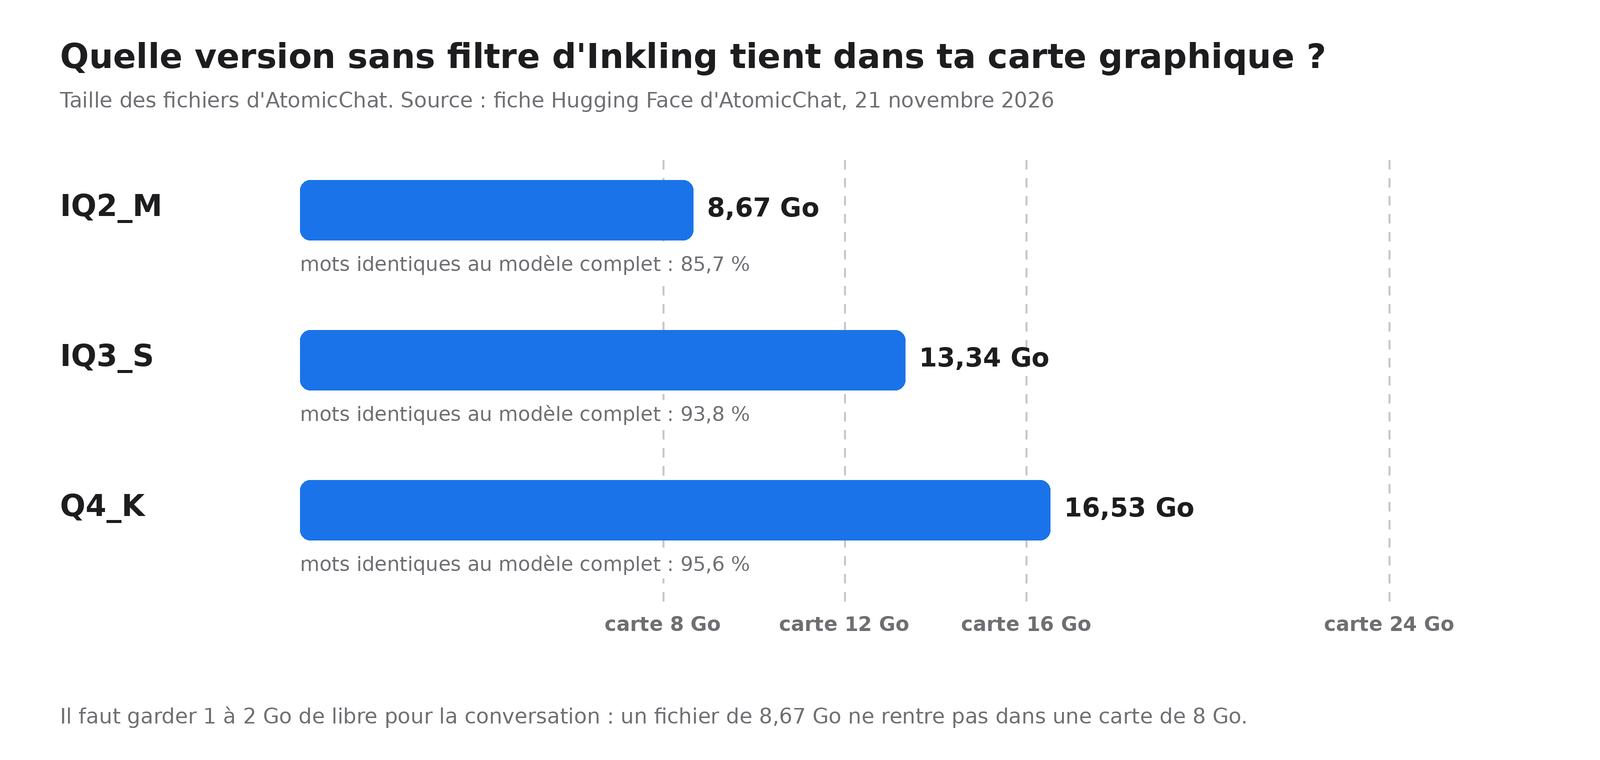
La version IQ2_M rate la carte de 8 Go d'un cheveu. Il fallait bien qu'il y ait un piège.
Pour situer : une version compressée, c'est le modèle dont on a arrondi tous les nombres, comme si on écrivait 3,1 au lieu de 3,14159. Il perd un peu de finesse et beaucoup de poids. Le chiffre sous chaque barre dit combien de fois, sur 100 mots, la version compressée choisit le même mot que le modèle complet : 96 fois pour la plus grosse, 86 pour la plus petite. Autrement dit, la version de 8,67 Go se trompe de mot une fois sur sept par rapport à l'original, ça se sent.
Évidemment, j'ai voulu la passer à la même moulinette que l'original. Sa fiche cite Ollama parmi les logiciels compatibles, alors j'ai lancé les deux plus petites versions avec la toute dernière version d'Ollama (0.40.17), sur une carte louée pour l'occasion. Refus net, avant même la première question : Ollama ne reconnaît pas l'architecture « inkling2_loop ». Exactement le même mur que la version d'Unsloth un peu plus haut. Deux centimes de location pour apprendre qu'il ne faut pas toujours croire la liste des logiciels compatibles.
Le vrai prérequis est écrit un peu plus bas sur la fiche : llama.cpp, le moteur qu'Ollama embarque sous le capot, dans une version au moins aussi récente que la b12600, qui sait faire tourner les boucles d'Inkling. Ollama ne l'a pas encore intégrée. Pour l'instant, il faut donc passer par llama.cpp en direct, avec la commande donnée par AtomicChat :
llama serve -hf AtomicChat/Inkling-2-Mini-Uncensored-GGUF:IQ2_MLa version IQ2_M demande une carte de 12 Go. Avec 16 Go, prends plutôt IQ3_S. Et si Ollama te répond « unknown model architecture », ce n'est pas ta carte qui est en cause : c'est juste qu'Ollama n'a pas encore rattrapé llama.cpp.
Mon avis, sans détour : une IA qui ne refuse plus rien n'a rien d'illégal en soi, et elle dépanne vraiment quand un modèle prend une question de pharmacienne, de romancier ou d'informaticien pour une menace. Mais la loi, elle, ne change pas, et AtomicChat l'écrit sans fard sur sa fiche : « ce modèle répondra aux demandes que l'original refuse, vous êtes responsable de l'usage que vous en faites ». Et n'oublie pas qu'un modèle sans filtre garde tous les autres défauts de l'original, à commencer par celui de se tromper avec un aplomb parfait. Sans le garde-fou, c'est toi le garde-fou.
Article écrit avec l'aide de Claude Code, relu et corrigé par moi.
Rejoignez la conversation
Vous devez avoir un compte pour commenter cet article. La création est gratuite et prend moins d'une minute.
Aucun commentaire pour le moment.