Inkling 2 Mini: Kann es auf einer Grafikkarte für Privatleute laufen?
Seit gestern redet in den KI-Salons jeder nur noch darüber: Inkling 2 Mini. Am 20. November von Thinking Machines Lab veröffentlicht, der Firma von Mira Murati (der Ex-Technikchefin von OpenAI), mit einem Versprechen, das eine Augenbraue hochziehen lässt: ein Modell, das fast so gut ist wie die großen und in 20 GB Speicher passt statt in die üblichen 50 oder 60 GB. Apache-2.0-Lizenz, also frei nutzbar, kostenlos herunterzuladen und zu verändern.
Auf dem Papier ist das die Art von Ankündigung, die nach Waschmittelwerbung klingt, die noch weißer wäscht. Also habe ich statt die Pressemitteilung abzuschreiben eine echte Grafikkarte auf einem Server gemietet, den Kram selbst installiert und mir angesehen, was tatsächlich passiert, wenn man versucht, das Ding zum Laufen zu bringen. Spoiler: Auf dem Papier hält das, was es verspricht, und auf einer Grafikkarte von Hinz und Kunz wird es sofort komplizierter.
Kein Netzwerkkabel auf dem Foto, und genau darum geht es: Ein Modell, das bei dir läuft, muss nichts irgendwohin schicken.
Der clevere Trick: Es liest dasselbe Stück dreimal
Um zu verstehen, warum dieses Modell in so wenig Speicher passt, muss man sich ansehen, wie es aufgebaut ist, und das ist wirklich clever. Ein klassisches Sprachmodell ist ein Stapel von Etagen (man nennt sie Schichten), den jedes Wort einmal durchläuft, der Reihe nach, von der ersten bis zur letzten. Bei einem Modell von der Größe von Inkling sind das 48 Etagen, und während das Modell arbeitet, muss es sie ALLE gleichzeitig im Speicher behalten.
Inkling 2 Mini führt einen Zaubertrick vor: Es speichert nur 24 Etagen, gruppiert in vier Blöcken. Der erste und der letzte Block arbeiten nur einmal. Die beiden Blöcke in der Mitte hingegen lassen sie dreimal hintereinander über dasselbe Wort laufen, bevor sie weitermachen. Ergebnis: Das Wort durchläuft insgesamt trotzdem 48 Mal eine Etage, genau wie beim klassischen Modell, aber der Rechner muss zu einem bestimmten Zeitpunkt nur die Hälfte der Etagen im Speicher behalten. Ein bisschen wie ein Schüler, der seinen Entwurf dreimal durchlesen würde, bevor er ihn ins Reine schreibt, statt sofort eine doppelt so lange Version zu schreiben.
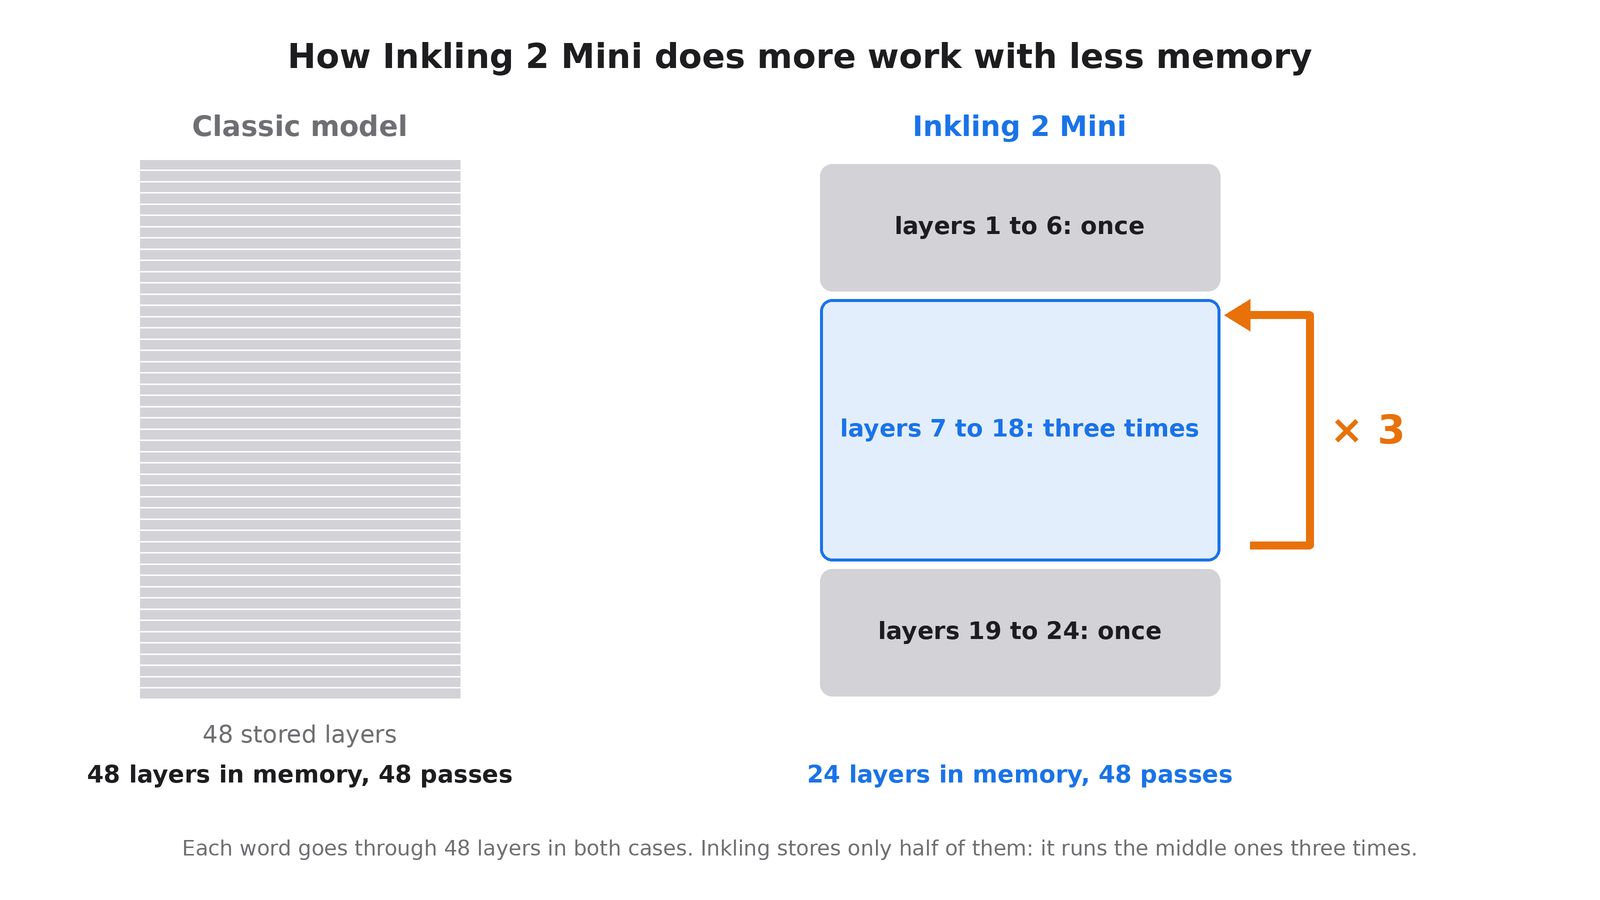
Gleiche Anzahl an Durchläufen, halb so viele zu speichernde Etagen. Die ganze Kunst besteht darin, noch einmal zu lesen, statt immer mehr Etagen aufeinanderzustapeln.
Noch radikaler wird es dadurch, dass Inkling auch die Technik der Mischung von Experten verwendet (das ist nichts Neues, Mistral hatte das 2023 mit Mixtral schon zum Laufen gebracht). Das Modell hat insgesamt 26,4 Milliarden Parameter, aber von den 128 internen „Experten“, über die es verfügt, aktiviert es pro Wort nur 8. Das ist wie ein Krankenhaus mit 128 Türen zu Spezialisten auf seinem Flur, in das man dich nur zu den 8 richtigen schicken würde, ohne dich an den 120 anderen vorbeizuführen. Bei jedem erzeugten Wort arbeiten tatsächlich nur 3,4 Milliarden Parameter (mit den Schleifen etwas mehr, in der Praxis etwa 5,4 Milliarden). Dadurch kann man ein großes Modell haben, das in der Nutzung so viel kostet wie ein kleines.
120 geschlossene Türen, 8, die sich öffnen. Niemand hat Lust, am ganzen Dienst vorbeizulaufen, bevor er den richtigen Arzt sieht, und dem Modell geht es genauso.
Was der Hersteller verspricht
Ein weiterer Trick, der den Speichervorteil erklärt: Das Modell wurde direkt mit 4 Bit trainiert (einem extrem kompakten Berechnungsformat, das die allerneuesten Nvidia-Chips nativ lesen können) statt mit den üblichen 16 Bit. Dadurch wird die Größe auf einen Schlag durch vier geteilt. Das von Thinking Machines Lab angezeigte Ergebnis: Mit 32 GB Speicher (einem aktuellen Mac, einer High-End-Grafikkarte oder der kleinen DGX-Spark-Box von Nvidia) soll es problemlos laufen. Das Modell akzeptiert auch Bilder als Eingabe und behält bis zu eine Million Gesprächswörter im Speicher.
Gegenüber Qwen3.8 27B, einem chinesischen Konkurrenten vergleichbarer Größe, den ich gerade als Vergleichspunkt verwendet habe, weist Thinking Machines Lab in seinem Datenblatt vom 20. November bessere Ergebnisse bei Tests zur Behebung echter Fehler aus: 79,2 gegenüber 77,8 bei SWE-bench Verified, einem Test, bei dem echte Fehler in echter Open-Source-Software behoben werden, also genau die Art Prüfung, bei der man nicht schummeln kann, indem man die Antworten auswendig lernt. Die unabhängige Website Artificial Analysis, die alle mit denselben Tests laufen lässt, um ehrlich zu vergleichen, gibt ihnen am 20. November dieselbe Gesamtnote (20 auf ihrem Index, der etwa zehn verschiedene Tests zusammenfasst), liefert aber ein schlagendes Argument beim Preis: durchschnittlich 0,59 Dollar pro Aufgabe gegenüber 3,53 Dollar für Qwen, und 9 Minuten gegenüber 38, um ans Ende zu kommen.
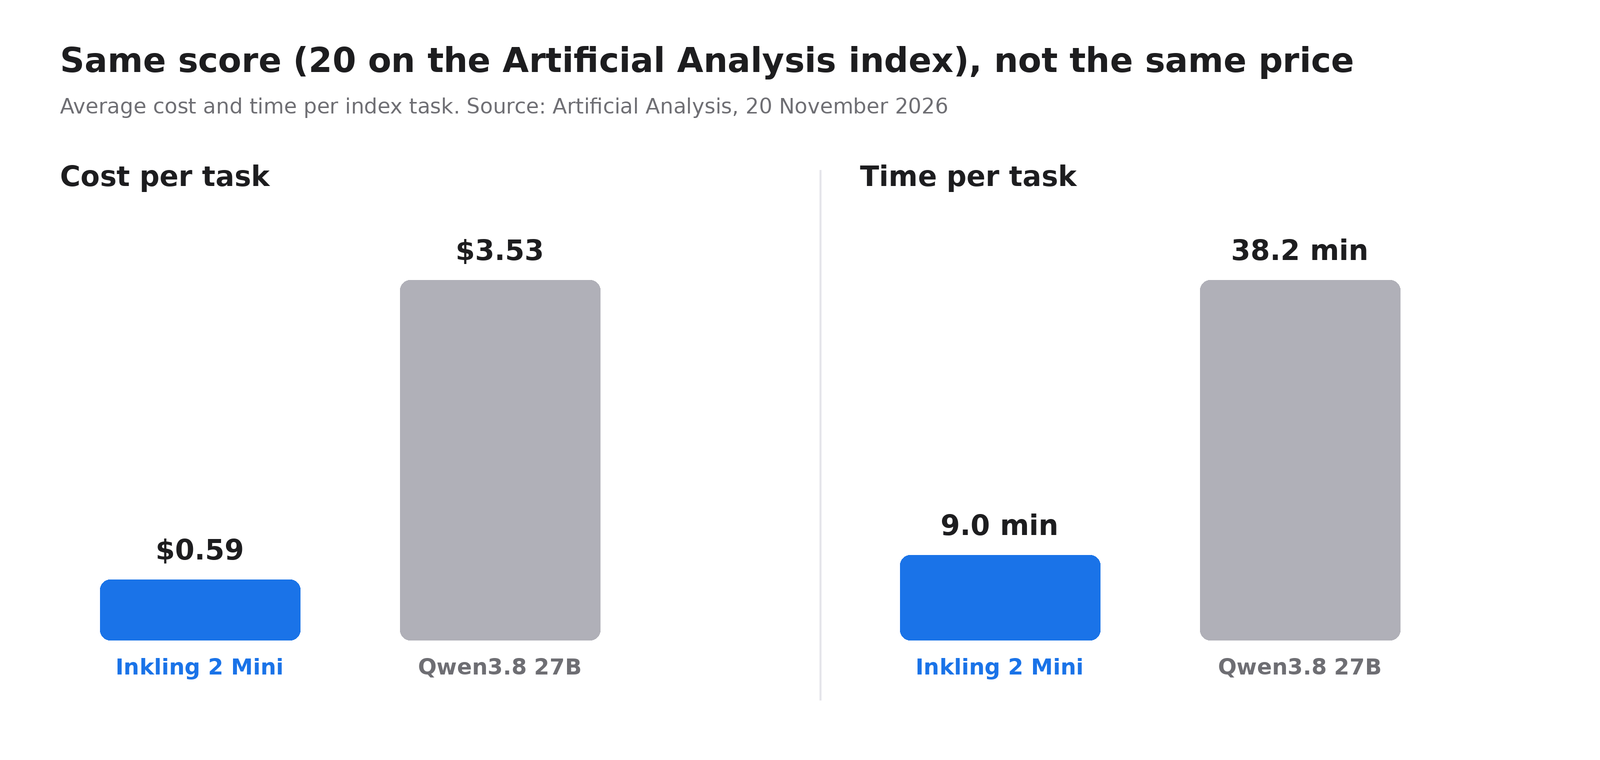
Gleiche Noten, sechsmal weniger saftige Rechnung. Auf dem Papier des Herstellers, jedenfalls.
Diese Zahlen stammen aus Rechenzentren, die mit den allerneuesten Nvidia-Karten ausgestattet sind, die das 4-Bit-Format nativ lesen, ohne es während des Betriebs übersetzen zu müssen. Auf gewöhnlicherer Hardware, also der, die bei den meisten von uns unter dem Schreibtisch steht, wird die Sache deutlich komplizierter.
Mein Test auf einer echten Karte, nicht auf einer Pressemitteilung
An diesem Samstag, dem 21. November, habe ich eine RTX 3090 (24 GB, 2020 auf den Markt gekommen, bei Privatleuten immer noch eine der am weitesten verbreiteten) eine halbe Stunde lang für knapp 10 Cent gemietet. Darauf habe ich Ollama (die meistgenutzte kostenlose Software, um KI zu Hause laufen zu lassen) in Version 0.40.17 installiert, und ich habe drei Modelle dieselben elf Fangfragen beantworten lassen: Rechenaufgaben, Logik, Rätsel mit Stolperfallen und zwei kleine Programme zum Schreiben.
Qwen3.8 27B hat die elf Fragen richtig beantwortet, mit 58,9 erzeugten Wörtern pro Sekunde. Inkling 2 Mini hat 21,2 GB im Speicher belegt (etwas mehr als die angekündigten 20 GB), brauchte zwei Startversuche, weil die Karte mehr als 100 Sekunden brauchte, bevor sie auf die erste Nachricht antwortete, und nachdem es gestartet war, beantwortete es zehn von elf Fragen richtig... mit 5,4 Wörtern pro Sekunde. Auf derselben Karte fast elfmal langsamer als Qwen.
Und die nicht beantwortete Frage ist ein amüsanter Seitenhieb auf ein Modell, dessen Verkaufsargument gerade darin besteht, sich selbst zu wiederholen: Ich habe es gebeten, ein kleines FizzBuzz-Programm zu schreiben, und es ist in eine Generierungsschleife geraten, bis es die von mir festgelegte Obergrenze erreicht hatte, ohne jemals eine Antwort zu erzeugen. Das Modell, das intelligent schleift, hat einfach nur geschleift.
Ich habe auch die komprimierte Version getestet, die Unsloth anbietet (ein auf die Verkleinerung von Modellen spezialisiertes Unternehmen), die angeblich auf Karten mit weniger Speicher laufen soll. Ergebnis: vollständiger Fehlschlag in Ollama, mit einer Meldung, dass die Engine diese Architektur nicht erkennt. Inklings Schleifen sind eine technische Neuerung, und die Unterstützung in den gängigen Werkzeugen hat den Rückstand noch nicht aufgeholt.
Der Grund für diese Langsamkeit auf meiner Karte: Eine RTX 3090 liest das 4-Bit-Format, in dem Inkling trainiert wurde, nicht nativ. Sie muss es Schicht für Schicht während des Betriebs übersetzen, und offenbar dreimal bei den mittleren Schichten. Die beeindruckenden Zahlen des Herstellers stammen von Karten der neuesten Generation, die dieses Problem nicht haben.
Was das konkret für dich ändert
Wenn du noch nie eine lokale KI angefasst hast, kommt hier der Grund, warum das alles wichtig ist. Heute gehen deine Nachrichten, wenn du dich mit ChatGPT oder Claude unterhältst, an einen Server eines amerikanischen Unternehmens. Ein Modell wie Inkling kann dagegen vollständig auf deinem eigenen Rechner laufen: Nichts verlässt dein Zuhause. Nützlich, wenn du einen Vertrag gegenlesen lassen, deine Konten diktieren oder ein paar persönlichere Fragen stellen willst, ohne dass das in den Protokollen eines Dritten landet.
Zweiter konkreter Effekt: Ein Modell, das pro Wort nur 8 von 128 Experten aktiviert, verbraucht deutlich weniger Strom als ein Modell, das jedes Mal alles durchlaufen lassen würde, genau wie ein Krankenhaus, das nur die richtigen Türen öffnet. Wenn du darüber nachdenkst, eine KI bei dir zu Hause dauerhaft laufen zu lassen, sieht man das auf der Rechnung.
Ehrlich gesagt, jetzt: Auf einer Karte aus dem Jahr 2020 wie meiner funktioniert es, macht aber keinen Spaß bei der Nutzung. Heute läuft es gut auf einem Mac mit 32 GB gemeinsam genutztem Speicher oder auf den allerneuesten Nvidia-Karten. Für den Rest von uns heißt es abwarten, bis die Werkzeuge diese neue Architektur eingeholt haben, was eher nach einer Sache von Wochen oder Monaten aussieht als nach einem Warten ohne Ende: Das Expertenmischen, das bei seiner Ankunft mit Mixtral im Jahr 2023 exotisch wirkte, ist heute in allen ernstzunehmenden Modellen alltäglich. Die Schleifen sollten denselben Weg nehmen.
Was der Hersteller selbst zugibt
Das technische Datenblatt von Inkling listet seine Mängel selbst auf, und das ist ihrerseits ziemlich ehrlich. Das Modell kann sich mit großer Sicherheit irren, ohne darauf hinzuweisen, dass es seiner Antwort nicht sicher ist. Es kann sich in endlosen Denkschleifen verlieren (ich bestätige das, ich habe es gerade mit meinem FizzBuzz erlebt). Verbunden mit einem Agenten, der auf deinem Computer handeln kann, kann es unumkehrbare Aktionen durchführen, ohne eine Bestätigung zu verlangen. Außerhalb des Englischen ist es deutlich schlechter. Und bei Fragen zur psychischen Gesundheit ist es merkwürdig übervorsichtig, bis zu dem Punkt, an dem es die Hilfe verweigert, obwohl die Frage harmlos war.
Läuft das bei dir?
Um herauszufinden, in welcher Kategorie du landest, musst du deinen Computer nicht auseinandernehmen: Unter Windows oder Linux zeigt der Befehl nvidia-smi in einem Terminal direkt die Speichermenge deiner Grafikkarte in der Spalte Memory-Usage an.
Auf einem Mac mit 32 GB Arbeitsspeicher oder mehr: ja, problemlos, dank der Art, wie Apple den Speicher zwischen Prozessor und Grafikchip aufteilt. Mit einer Grafikkarte mit 24 GB wie meiner: Es lädt und antwortet, aber langsam, während die Software besser wird, du musst in der Zwischenzeit keine Niere für eine 3000-Euro-Karte verkaufen. Mit einer 16-GB-Karte: Unsloth kündigt eine komprimierte 3-Bit-Version an, die in 13 bis 15 GB passen sollte, mit einem zusätzlichen Qualitätsverlust, den du selbst überprüfen musst.
Das ist übrigens genau die Art von Aufholjagd, von der ich vor sechs Tagen bei der Ankündigung des Erscheinens von llama.cpp in Version 1.0 gesprochen habe: Neue Modellformate erscheinen immer schneller, als die Unterstützung dafür in den Werkzeugen verfügbar ist, mit denen Privatleute sie ausführen. Wenn du ein Modell dieser Größe willst, das schon heute gut auf deiner Grafikkarte funktioniert, bleibt Qwen3.8 27B, das ich in diesem Test als Referenz verwendet habe, fürs Erste die sicherste Wahl.
Inkling 2 Mini ist eine echte technische Entdeckung, kein heiße-Luft-Verkauf, den man uns andreht. Nur ist diese Entdeckung etwas früher eingetroffen, als die Werkzeuge für den Massenmarkt bereit waren, sie ordentlich aufzunehmen. Wenn also auch du eine RTX 3090 hast, die bei diesem Biest 5 Wörter pro Sekunde schafft, verkauf sie bloß nicht: Lass sie in Ruhe und versuch es in zwei oder drei Monaten noch einmal. Sie hat nichts Falsches getan.
Update: Die Version ohne Filter ist schon da
Es hat keine 48 Stunden gedauert. AtomicChat, das Team hinter der Anwendung Atomic Chat, die Modelle offline ausführt, hat auf Hugging Face (der großen Online-Bibliothek für KI-Modelle) eine „uncensored“-Version von Inkling 2 Mini veröffentlicht, also eine Version ohne Filter. Am Abend des 21. November waren es bereits mehr als 9.500 Downloads. Der Trend zu KIs, die niemals Nein sagen, hat wieder zugeschlagen, und zwar schnell.
Wie entfernt man die Verweigerungen eines Modells, ohne es neu zu trainieren? Das ist ziemlich clever und ehrlich gesagt weniger magisch, als man denkt. Sie haben dem Modell eine Reihe von Fragen gestellt, die es ablehnt, danach eine Reihe banaler Fragen, auf Englisch und Russisch, und sie haben sich angesehen, was sich in seinem Kopf zwischen den beiden verändert. Was sich verändert, ist im Großen und Ganzen der Reflex „nein danke“. Nachdem sie ihn erkannt hatten, haben sie ihn Etage für Etage gelöscht, mit einem kleinen 40-MB-Korrekturpaket, das auf ein 16-GB-Modell gelegt wurde. Im Datenblatt wird das Wort nicht verwendet, aber es ist das Prinzip dessen, was man Abliteration nennt: Man bringt dem Modell nichts Neues bei, man nimmt ihm einfach die Lust zu verweigern.
Und es funktioniert laut ihren eigenen Zahlen: Von 81 englischen Anfragen, die das Original allesamt ablehnte, lehnt die Version ohne Filter keine mehr ab. Dasselbe auf Russisch, von 91 Ablehnungen bei 100 auf null. Für den Alltag interessanter ist, dass das Original bei 250 völlig harmlosen, aber schlecht klingenden Fragen (der Sorte „wie man einen Python-Prozess beendet“, was ein zu vorsichtiges Modell als Bedrohung auffasst) 10 ablehnte, die neue Version null. Erinnerst du dich an den weiter oben eingeräumten Mangel, dieses bei psychischer Gesundheit überängstliche Modell? Genau solche Blockaden räumen diese Versionen aus dem Weg.
Das hat einen Preis, und AtomicChat ist ehrlich genug, ihn aufzuschreiben. Bei einem Test des Allgemeinwissens mit 2.000 Fragen (MMLU) verliert das Modell eineinhalb Punkte, von 80,65 % auf 79,15 % richtiger Antworten. Und bei zwei ihrer eigenen Qualitätskriterien schreiben sie schwarz auf weiß, dass sie das Ziel verfehlt haben: Die ersten Wörter der Antworten auf banale Fragen haben sich stärker verändert, als ihnen lieb gewesen wäre. Selten sieht man ein Team, das seine eigenen Fehlschläge veröffentlicht, das verdient Anerkennung.
Die wirklich gute Nachricht für kleine Konfigurationen ist die Größe. AtomicChat bietet drei komprimierte Versionen an, und die kleinste kommt auf 8,67 GB.
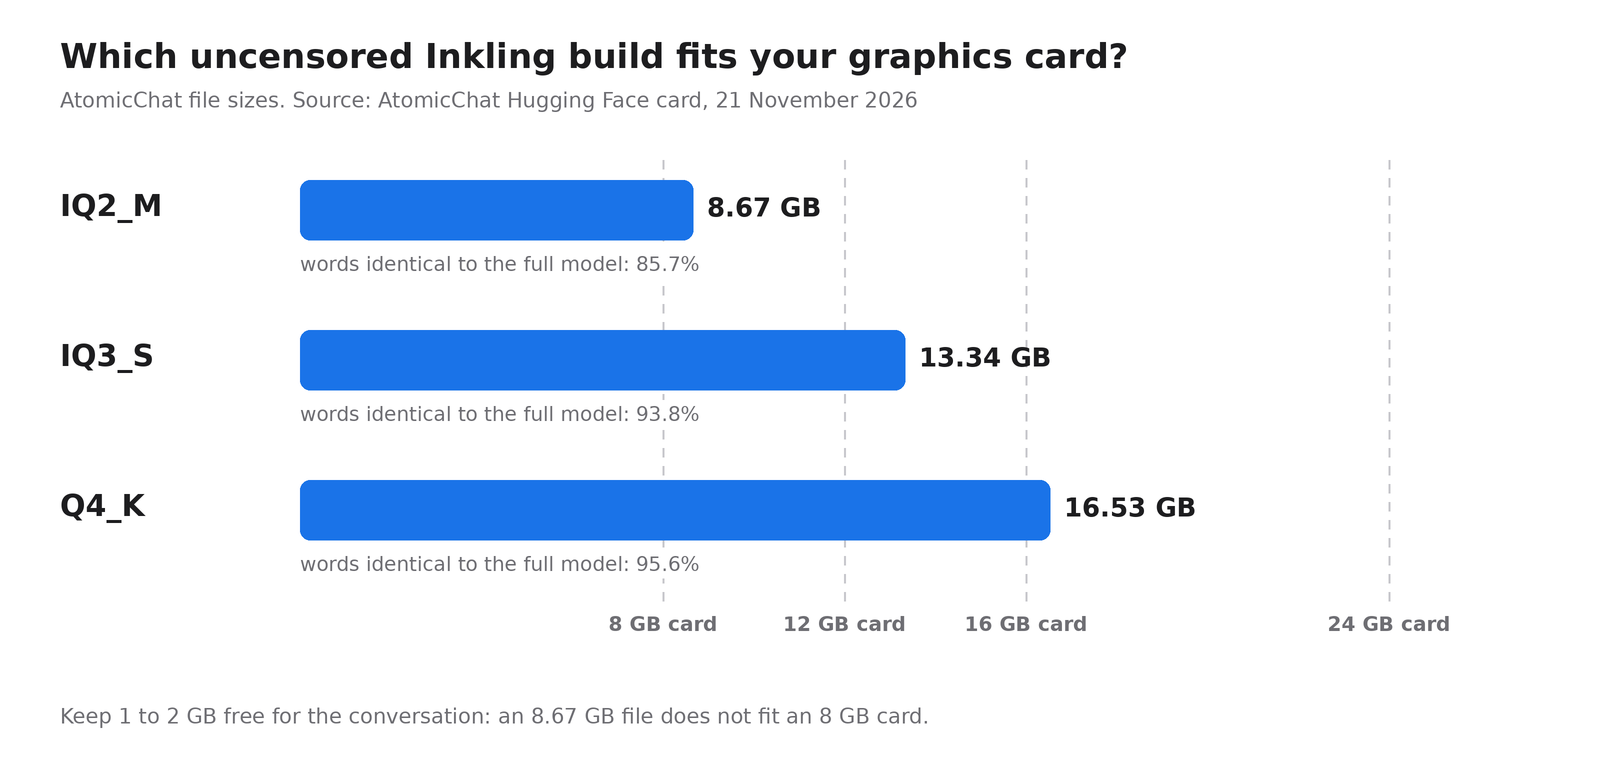
Die IQ2_M-Version verpasst die 8-GB-Karte um Haaresbreite. Es musste ja einen Haken geben.
Zur Einordnung: Eine komprimierte Version ist das Modell, bei dem man alle Zahlen gerundet hat, als würde man 3,1 statt 3,14159 schreiben. Sie verliert etwas an Feinheit und viel Gewicht. Die Zahl unter jedem Balken sagt, wie oft die komprimierte Version auf 100 Wörter dasselbe Wort wie das vollständige Modell wählt: 96-mal bei der größten, 86-mal bei der kleinsten. Anders gesagt, die 8,67-GB-Version wählt im Vergleich zum Original in einem von sieben Fällen das falsche Wort, das merkt man.
Klar wollte ich sie durch dieselbe Mühle drehen wie das Original. In ihrem Datenblatt wird Ollama als kompatible Software genannt, also habe ich die beiden kleinsten Versionen mit der allerneuesten Ollama-Version (0.40.17) auf einer dafür gemieteten Karte gestartet. Klare Absage, noch vor der ersten Frage: Ollama erkennt die Architektur „inkling2_loop“ nicht. Genau dieselbe Mauer wie bei der Unsloth-Version etwas weiter oben. Zwei Cent Miete, um zu lernen, dass man der Liste der kompatiblen Software nicht immer glauben sollte.
Die eigentliche Voraussetzung steht etwas weiter unten im Datenblatt: llama.cpp, die Engine, die Ollama unter der Haube einbindet, in einer Version, die mindestens so aktuell ist wie b12600 und Inkling-Schleifen ausführen kann. Ollama hat sie noch nicht integriert. Im Moment muss man also direkt über llama.cpp gehen, mit dem von AtomicChat angegebenen Befehl:
llama serve -hf AtomicChat/Inkling-2-Mini-Uncensored-GGUF:IQ2_MDie IQ2_M-Version braucht eine 12-GB-Karte. Mit 16 GB nimm lieber IQ3_S. Und wenn Ollama dir „unknown model architecture“ antwortet, liegt es nicht an deiner Karte: Ollama ist einfach noch nicht zu llama.cpp aufgeschlossen.
Meine unverblümte Meinung: Eine KI, die nichts mehr ablehnt, ist an sich nicht illegal, und sie hilft wirklich, wenn ein Modell eine Frage von einer Apothekerin, einem Romanautor oder einem Informatiker für eine Bedrohung hält. Aber das Gesetz ändert sich nicht, und AtomicChat schreibt es unverblümt in sein Datenblatt: „Dieses Modell wird auf Anfragen antworten, die das Original ablehnt, du bist für die Nutzung verantwortlich, die du davon machst“. Und vergiss nicht, dass ein ungefiltertes Modell alle anderen Fehler des Originals behält, angefangen bei dem, sich mit perfekter Selbstsicherheit zu irren. Ohne Leitplanke bist du die Leitplanke.
Artikel mit Hilfe von Claude Code geschrieben, von mir gegengelesen und korrigiert.
Treten Sie der Unterhaltung bei
Sie müssen ein Konto haben, um diesen Artikel zu kommentieren. Die Erstellung ist kostenlos und dauert weniger als eine Minute.
Keine Kommentare im Moment.