IA : comment interdire aux IA d'apprendre avec ton site, en une seule ligne ?
Tu as un blog, une boutique en ligne, un site de photos ? Si tu ne veux pas que les IA apprennent avec ce que tu y publies, il faut aujourd'hui dresser une liste. GPTBot pour OpenAI, Google-Extended pour Google, ClaudeBot pour Anthropic, CCBot, Bytespider, et il en arrive un nouveau tous les trois mois. Le 30 octobre, OpenAI, Google, Microsoft et Anthropic ont annoncé qu'ils allaient tous respecter une seule et même ligne.
Une ligne pour les quatre, enfin ! Sauf que ce n'est pas un verrou, et que personne ne démarre le même jour.
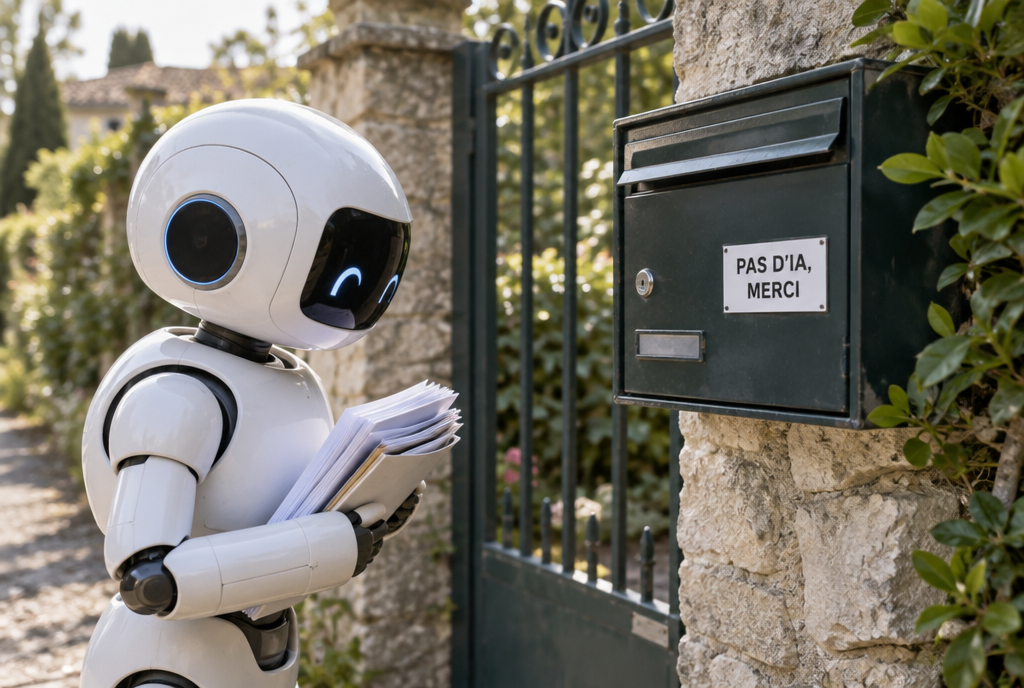
Le même principe que l'autocollant « Stop pub », mais pour les robots des IA
Le panneau à l'entrée de ton site
Tout se passe dans un petit fichier qui existe depuis 1994 : le robots.txt. C'est un simple texte posé à la racine d'un site, que les robots des moteurs de recherche lisent avant d'entrer. Il dit qui a le droit de visiter quoi. Exactement comme l'autocollant « Stop pub » sur ta boîte aux lettres : il ne bloque rien physiquement, il demande. Les distributeurs sérieux le respectent, les autres s'en fichent.
Le problème, c'est que chaque entreprise d'IA envoie ses propres robots, avec leurs propres noms. Pour dire non à l'entraînement, il faut donc les citer un par un, et revenir mettre la liste à jour à chaque nouveau venu. Autant coller un autocollant par marque de pizzeria.
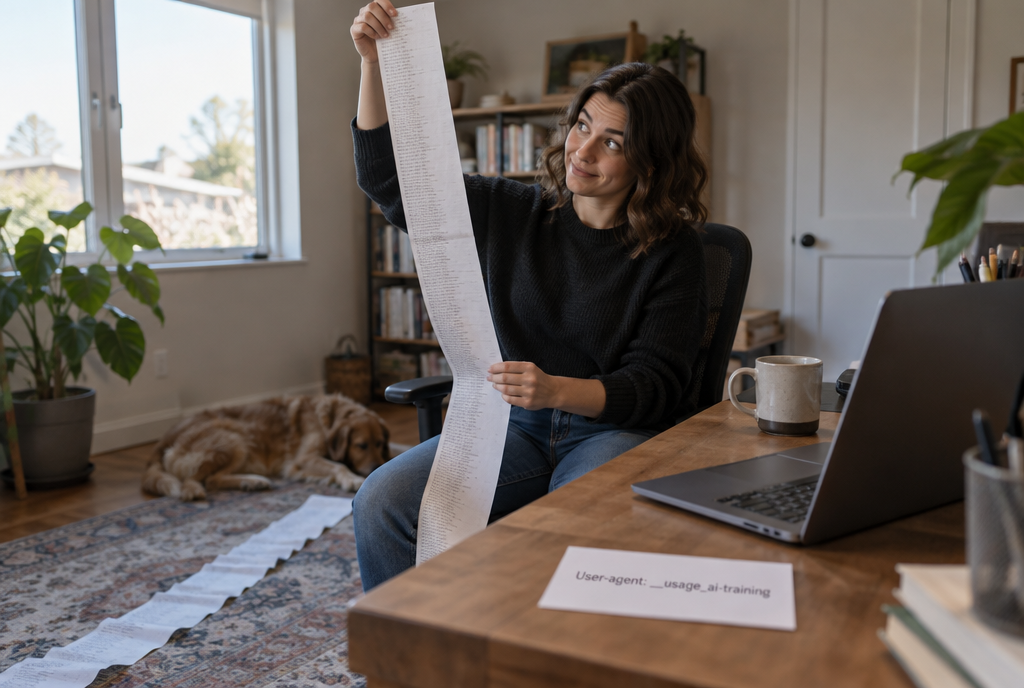
La liste d'aujourd'hui, et la fiche promise pour demain
La nouvelle ligne, telle qu'elle s'écrit
Le signal s'appelle __usage_ai-training. Oui, le nom a été choisi par des ingénieurs, ça se voit : personne ne le retiendra du premier coup, copie-le. Il ne désigne pas un robot en particulier, il désigne un usage : l'entraînement d'une IA générative, c'est-à-dire le moment où ton texte ou tes photos servent à fabriquer le modèle lui-même. Pour dire non partout sur ton site, ça donne ça :
User-agent: __usage_ai-training
Disallow: /
Et si tu veux laisser une partie ouverte, tes articles par exemple, tu ajoutes une exception :
User-agent: __usage_ai-training
Disallow: /
Allow: /blog/
Attention à un piège : la règle générale User-agent: * que beaucoup de sites ont déjà ne compte pas. Le signal ne vaut que s'il est écrit en toutes lettres.
L'idée vient d'Anthropic. Kevin Kelley, de chez Anthropic, l'a déposée le 30 octobre sous forme de brouillon à l'IETF, l'organisme qui écrit les règles techniques d'Internet. Précision qui compte : c'est un brouillon personnel, pas encore une norme, et il expire le 3 mai 2027 s'il n'avance pas.
Qui le respectera, et à partir de quand
C'est là que l'enthousiasme retombe un peu. Personne ne démarre le même jour :
- Anthropic, qui a écrit le brouillon, soutient le signal, mais je n'ai pas trouvé de date officielle de mise en service ;
- OpenAI parle des « prochains mois », sans date ;
- Microsoft commencera à le lire le 1er février 2027 ;
- Google, « en 2027 », le traitera comme si tu avais fermé la porte à Google-Extended, son robot réservé à l'IA ;
- Meta « soutient l'idée », mais ne s'est engagé à rien.
Bref, si tu ajoutes la ligne ce soir, elle ne servira à presque rien avant l'année prochaine. Ça ne coûte rien de la mettre quand même.
Ce que ça apporte vraiment
La bonne nouvelle, et elle n'est pas petite : dire non à l'entraînement ne te fait pas disparaître de Google ni de Bing. Google précise que son réglage pour l'IA ne touche ni à l'inscription dans ses résultats ni au classement, et Microsoft écrit que ces préférences ne changent rien à la présence dans Bing. Jusqu'ici, beaucoup de gens n'osaient pas bloquer, de peur de se tirer une balle dans le pied côté référencement.
Et visiblement, c'est ce que les gens attendaient. Mi-septembre, Cloudflare, qui protège une bonne partie des sites du monde, comptait déjà 17 % de propriétaires de sites qui limitaient l'entraînement des IA, presque un sur six, contre moins de 1 % qui bloquaient les moteurs de recherche, moins d'un sur cent. Les gens veulent être trouvés. Ils ne veulent pas forcément servir de matière première gratuite.
Ce que ça ne fait pas
Trois limites, et elles comptent.
D'abord, ça ne concerne que l'entraînement. Quand tu poses une question à Copilot ou à ChatGPT et qu'il va lire ta page en direct pour te répondre, ce n'est pas de l'entraînement, c'est ce que Microsoft appelle le « grounding » : l'IA consulte ta page comme toi tu consultes un dictionnaire, sans l'apprendre par cœur. Microsoft prépare un réglage à part pour ça, page par page, et prévient sans détour que fermer cette porte-là te rendra moins visible dans les réponses des IA.
Ensuite, ça ne vaut que pour l'avenir. Ce qui a déjà été aspiré l'année dernière est déjà dans les modèles, et aucune ligne de robots.txt ne le fera ressortir.
L'étiquette est bien collée, les biscuits sont déjà mangés
Enfin, c'est une demande polie, pas un verrou. Le signal repose sur la bonne volonté de ceux qui envoient les robots. Les quatre gros ont promis. Les centaines de petits aspirateurs anonymes, eux, n'ont rien promis du tout. Et personne ne parle d'argent : le signal dit « non », il ne permet pas de dire « oui, mais tu paies ».
Alors, tu la mets ou pas ?
Ça dépend de ce que tu vends. Un photographe, un illustrateur ou un auteur qui vit de ses créations a toutes les raisons de dire non à l'entraînement. Une boutique ou un artisan, au contraire, a peut-être intérêt à ce que les IA connaissent bien ses produits. Je racontais le mois dernier que les agents IA se perdent déjà sur les sites mal faits : le jour où ton client demande à son assistant où acheter, mieux vaut que ton site soit lisible pour lui.
Pour moi, c'est une vraie bonne nouvelle, la première fois que les quatre plus gros s'accordent sur un truc aussi simple. Ça ne règle pas tout, loin de là, mais c'est un autocollant clair sur la boîte aux lettres, et ça vaut mieux qu'une liste de vingt noms à tenir à jour tout seul. Et à Meta, qui « soutient l'idée » sans rien promettre : on attend que tu colles l'autocollant toi aussi !
Sources
- SiliconANGLE, 30 octobre 2026 : Google, Anthropic et d'autres soutiendront un nouveau signal de refus
- IETF : le brouillon « Machine-Readable Training Preference Signal » de Kevin Kelley
- Microsoft Bing, octobre 2026 : les réglages d'entraînement et de grounding, et leurs dates
- Digidai, 31 octobre 2026 : ce que le signal change, et ne change pas, pour les éditeurs
- Cloudflare, 15 septembre 2026 : la part des sites qui limitent l'entraînement des IA
Article écrit avec l'aide de Claude Code, relu et corrigé par moi.
Rejoignez la conversation
Vous devez avoir un compte pour commenter cet article. La création est gratuite et prend moins d'une minute.
Aucun commentaire pour le moment.