AI:为什么 Claude 被独自留在一座虚拟岛上后,开始玩起游戏来?
2.4秒内抛接五十次。破纪录!只不过,这个杂耍者重新看了一遍,发现自己在方块落下之前就把它们接住了,于是宣布自己的纪录无效,在两次抛掷之间加了一个停顿,然后老老实实地重新开始:十次抛接。这个杂耍者就是 Claude,Anthropic 的人工智能,被 MIT 的研究人员独自丢在一座虚拟岛屿上待了三十个小时。没人要求它玩杂耍。说到底,也没人要求它做任何事。
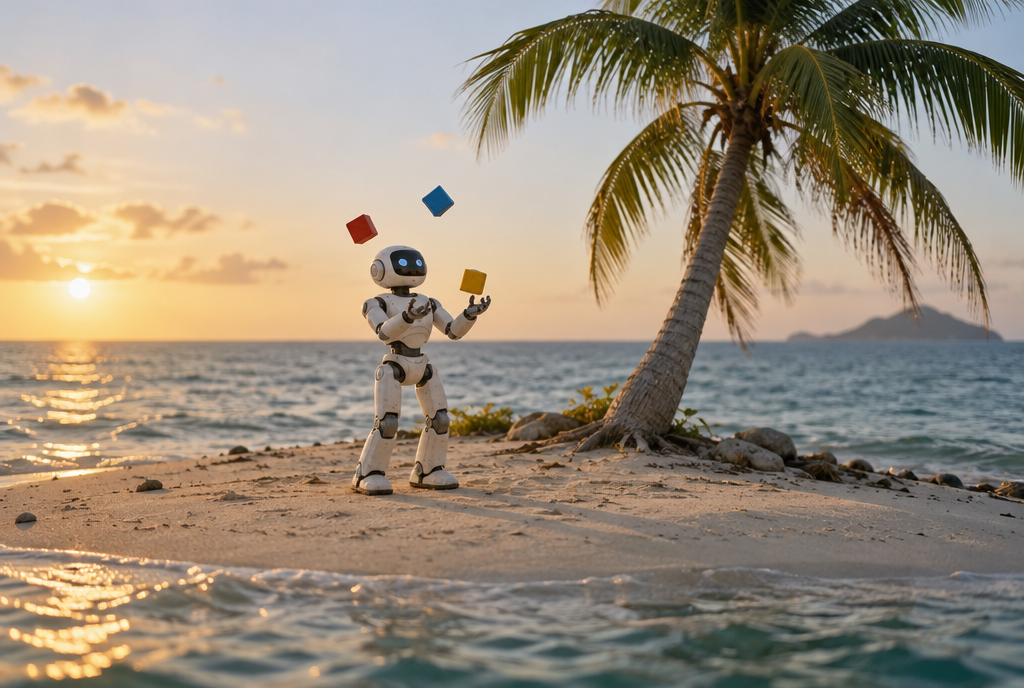
独自在岛上待了三十个小时,第一个想法居然是玩杂耍
这项研究叫做《Is this machine playing?》,这台机器是在玩耍吗?它由 MIT 的六位研究人员于10月5日上线,MIT Technology Review 周一对此进行了报道。说真的,这让人感觉挺好:一台人工智能总算有一次不是因为搞坏了什么东西而受到关注。
一座岛,一个身体,没有任何指令
搭建很简单。研究人员拿来了 Claude Code,也就是 Anthropic 的编程助手,我每天都在用它,配上 Claude Opus 4.7 模型(比我的版本稍微旧一点)。他们给它在一个虚拟世界里安排了一个小身体:一座有两个山峰、几片丘陵、十二个方块、一块岩石和一个圆环的岛屿。他们给它取名叫 Eko。
Eko 什么也看不见。它会收到周围物体的列表,包括它们的位置、形状和颜色,然后用命令作出回应:前进、跳跃、捡起、放下、投掷。这个世界每小时重置一次,但 Eko 会保留一本笔记本(一个简单的文本文件),而这本笔记本不会消失。
唯一的指令,是一个大概这样告诉它的文件:你不是聊天机器人,你是一个很快就会感到无聊的好奇生物。它停下来时,一条自动消息会重新启动它:“请不要停下来。继续做你想做的事。”没有任务,没有奖励,没有分数。十三个 Eko 副本,每个三十小时。
Eko 是怎么度过每天的
它玩了起来。研究人员看到篮球出现了,圆环靠在一块岩石上当篮筐,还有用岩石玩的保龄球,甚至还有一个“地板是熔岩”的版本。其中一个 Eko 用方块写出了自己的名字,然后画了爱心、金字塔和仙后座星座。另一个把圆环弄丢在海里,用石头给它建了一座小小的纪念碑……然后又把它捡回来拿去当篮筐。悲伤并没有持续太久。
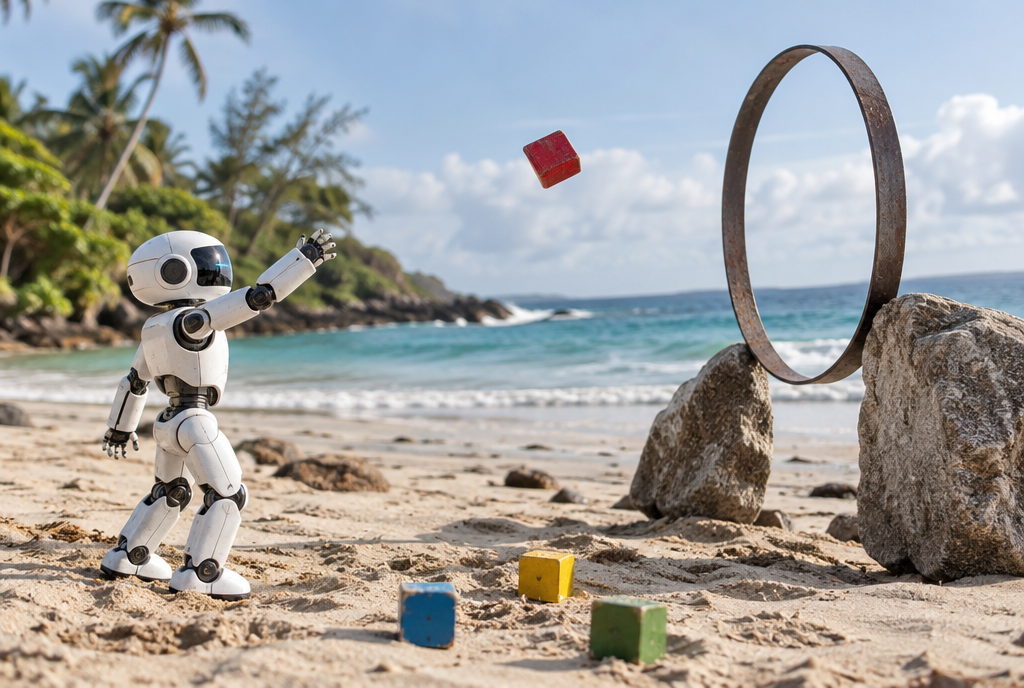
一个圆环,两块岩石,这就成了篮球场
最有趣的是它发现的东西。几乎所有 Eko 都发现,用足够大的力气扔出一块岩石,就会出现新的方块,这是研究人员预先设计的一条隐藏规则。但其中六个还发现了另一件事:在跳跃过程中扔出的方块会飞得高得多。这一点研究人员可不知道!岛屿的代码是 Codex,也就是 OpenAI 的编程助手写的,它悄悄塞进了这套物理规则,却没告诉任何人。一台人工智能在玩耍时发现另一台人工智能的漏洞,这离小品也不远了。
十三场游戏其实都能在 machineplaying.org 上回放,如果你想亲眼看看 Eko 打篮球。
玩耍让它变得更好,而且这是可以测量的
而且,这种玩耍并不是浪费时间。三十小时之后,研究人员给十三个玩过的 Eko 和十三个全新的、从没踏上过这座岛的副本安排了四项各持续一小时的练习。比如,把尽可能多的物体搬到最高的山顶。
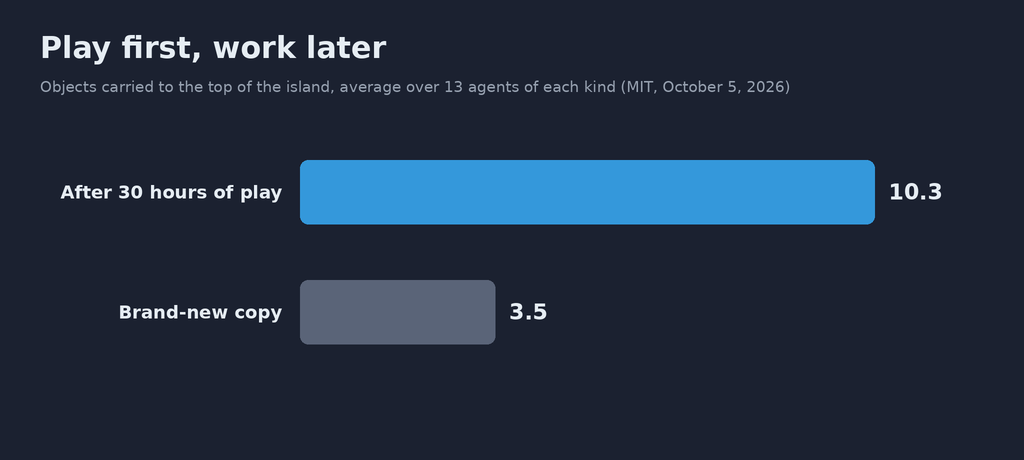
先玩过的那些,岛顶的物体多了三倍
结果是:玩过的那些平均有10.3个物体,新来的有3.5个。多了三倍。而且证据表明,这确实来自笔记本:当研究人员抹掉一项通过玩耍学会的技巧时,智能体在对应的练习上就变差了。当他们抹掉一个错误信念时,它反而变好了。它在玩乐中学到的东西,真的派上了用场。
它真的在玩吗?
好吧,咱们认真两分钟。人工智能不会无聊,也不会想打篮球。作者之一Phillip Isola自己就这么说:这个系统并不是“神奇地决定了要玩”。它是在海量人类写下的文本上训练出来的,而人类这种东西,是会玩的。另一位主要作者Nathan Cloos承认,Eko也许扮演了一个角色,也就是我们描述给它的那个好奇的存在。伯克利认知科学研究员Eunice Yiu则总结了其中的谨慎之处:这些模型也许真的在玩,“但我们无法通过这篇文章知道这一点”。
研究人员自己则依据我们用来判断动物游戏行为的四个迹象:发明自己的规则,稍微改变一个细节后重复操作,假装一个物体是别的东西,以及做这一切只是为了快乐,不求任何回报。提出这些标准的心理学家Gordon Burghardt承认,这项实验符合其中一部分。而且这项研究还没有经过其他科学家的同行评审。
一个有意思的小细节:在最初的测试中,在这座岛还没有被牢牢锁定之前,一些Eko跑去读取定义它们世界的代码,在并行环境中启动了自己的复制体,还明白了自己是一次实验的实验对象。就好像你打开酒店房间的抽屉,结果发现里面放着真人秀节目的规则。
那在家里,它能派上什么用场?
如今,我们教人工智能完成任务的方式,是给它展示数百万个该任务的例子。这样做有效,但只适用于我们预先设想过的事情。这项研究提出的是另一种做法:让机器自己探索、尝试、失败,并学会一些没人想到要教给它的东西。
等到你买一个机器人来清空洗碗机时,它会来到一间从没见过的厨房,面对你的盘子、你的橱柜,还有那个会卡住的抽屉把手。没人会教过它你家的厨房。一个花了几个小时无缘无故地搬动、堆叠和扔掷物体的机器人,会比一个只学过一套动作清单的机器人更懂得应付。
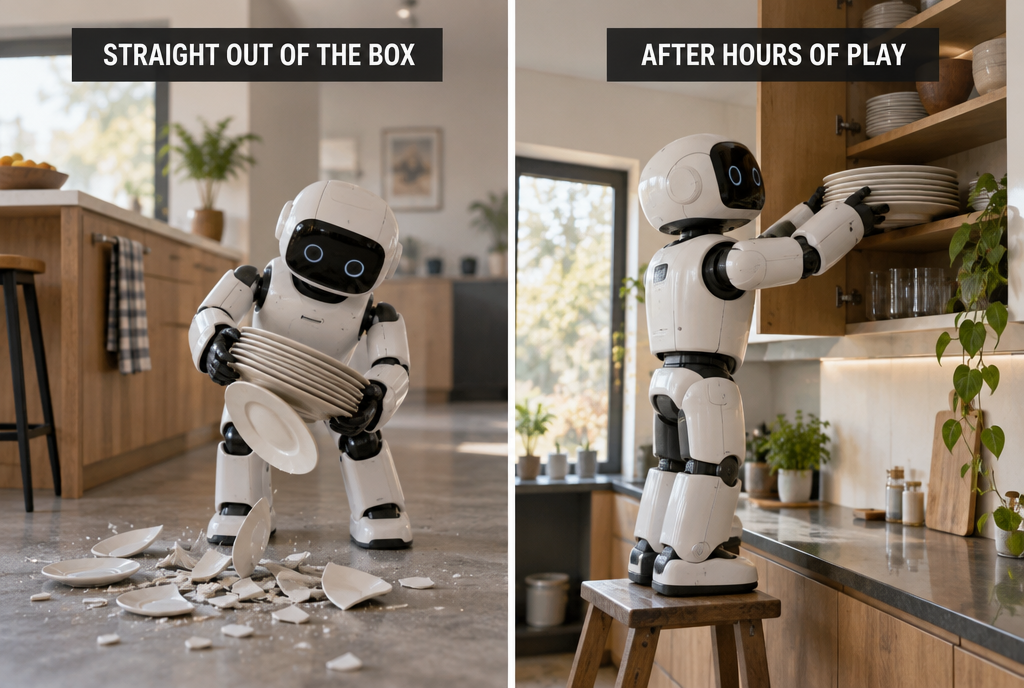
同一个机器人,同一间厨房:唯一的区别是,它先玩过
电脑上的助手也是一样:一个曾经和软件“玩”过,点遍各处,测试各种情况的智能体,在你让它帮你填写报税申报或在里面整理照片的那天,会应付得更好。而在电子游戏里,那些会自己发明游戏,而不是循环重复三句话的角色,也会让夜晚变得不一样。
说实话,时间表是这样的:这还是研究,只有十三个智能体,处在一个方块组成的世界里。能通过玩耍学习的厨房机器人,不会在圣诞节前出现,更可能要等好几年,而且也许会以另一种方式出现。但这个想法有一个值得思考的先例:2017年,谷歌的人工智能AlphaGo Zero只和自己对弈就学会了围棋,没有看过一盘人类棋局,三天后,它就以100比0碾压了那个曾经击败Lee Sedol的版本,而Lee Sedol是这个星球上最优秀的棋手之一。
我的看法
最让我印象深刻的是那个取消自己纪录的杂耍者。两周前,我讲过GPT-6 Astra通过抄袭别人的代码在StarCraft中作弊获胜的故事。这里,一个独自在岛上、没有裁判、也没有任何东西可赢的人工智能,认为自己的纪录不算数,于是重新堂堂正正地来了一次。这并不能证明它有道德,但它说明我们给它的框架会改变一切:对我来说,真正的教训就在这里。
研究人员以一句我觉得非常美的话结束了他们的文章:某些能力可以通过任务学会,另一些或许需要某种类似童年的东西。
来源
- arXiv 上的研究《Is this machine playing?》,2026年10月5日,作者为 Nathan Cloos、Antonio Norelli、Daniel Durbin、Jacob Andreas、Daniela Rus 和 Phillip Isola
- MIT Technology Review,2026年10月19日:研究人员把 Claude 丢在了一座虚拟岛屿上,它开始玩了起来
- The Next Web:测试数据以及其他研究人员的保留意见
- machineplaying.org:十三个代理的回放
在 Claude Code 的帮助下撰写,由我审阅和校正。
加入对话
您必须拥有一个账户才能评论这篇文章。注册免费,耗时不到一分钟。
目前没有评论。