IA à la maison : NVIDIA sort un modèle de 4 Go, qu'est-ce qu'on peut en faire ?
Quatre gigaoctets. Le poids d'un film, ou de huit cents photos de vacances. C'est aussi, depuis mercredi, la taille d'un assistant IA complet que NVIDIA met en téléchargement libre et qui tourne sur une machine posée chez toi. Pas sur un serveur en Virginie que tu paies au mois : chez toi, sur ton bureau, sans abonnement, sans compte, et sans qu'une seule de tes phrases ne sorte de la maison.
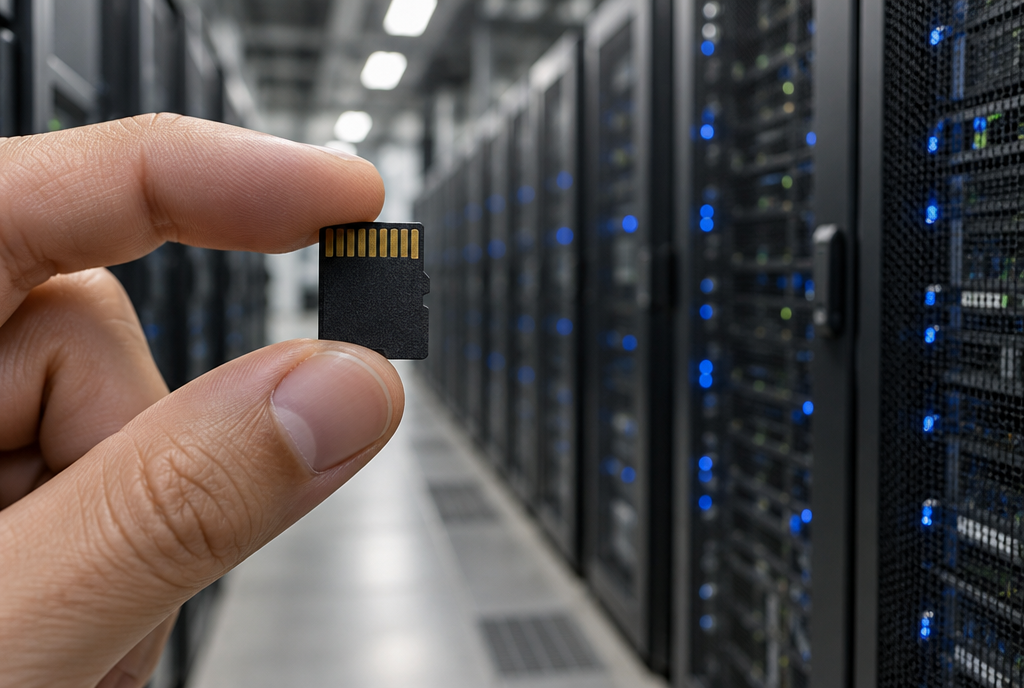
Devant, le modèle. Derrière, le centre de données qu'il remplace. Presque
Trois modèles, trois tailles, une seule idée
NVIDIA a publié mercredi trois nouveaux modèles de sa famille Nemotron, et pour une fois on ne les classe pas par puissance mais par la place qu'ils prennent dans la mémoire. Un peu comme des valises : cabine, soute, déménagement.
Le gros s'appelle Super VL. Il compte 120 milliards de paramètres, ces petits réglages internes où est rangé tout ce qu'il sait, mais il n'en réveille que 12 milliards pour écrire chaque mot. C'est le principe du cabinet médical : on ne convoque pas les quarante médecins pour une angine. Il lit du texte, des images, des documents et de la vidéo, et il peut se souvenir d'un million de mots d'un coup, soit une dizaine de romans.
Le moyen s'appelle Bolt 74B. Son argument n'est pas sa taille mais le fait qu'il tient dans 24 gigaoctets de mémoire, celle d'une bonne carte graphique de joueur ou des nouveaux portables à IA. J'en parlais justement la semaine dernière à propos des machines RTX Spark, qui sont arrivées en boutique jeudi.
Et le petit, c'est Bolt E4B, celui de 4 gigaoctets, attendu le 23 octobre. Il vise les assistants vocaux, les petites cartes électroniques de bricoleur et tout ce qui doit répondre vite sans courir demander la réponse à Internet.
Le tour de passe-passe des 2 bits
Comment on fait rentrer 74 milliards de réglages dans 24 gigaoctets ? En écrivant chaque réglage de façon très grossière. C'est ce qu'on appelle la quantification, et l'image qui marche le mieux, c'est celle d'une photo.
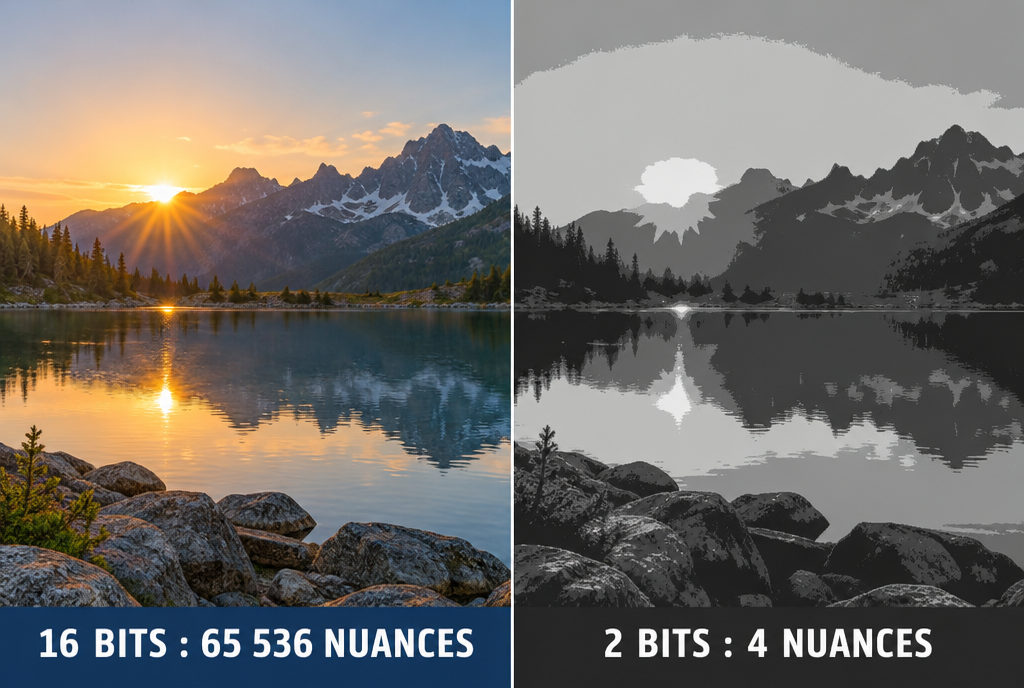
À droite, on reconnaît encore le lac. C'est tout ce qu'on demande
Une photo normale garde des dizaines de milliers de nuances par pixel. Si tu n'en gardes que quatre, le fichier devient minuscule et l'image devient moche, mais on reconnaît toujours le paysage. NVIDIA a fait pareil avec les réglages de son modèle : quatre valeurs possibles au lieu de dizaines de milliers. La nouveauté, c'est que le modèle a été entraîné comme ça depuis le début, au lieu d'être écrasé après coup comme on le fait d'habitude. Ça change tout : c'est la différence entre une photo prise en basse définition et une photo massacrée par une compression.
Il sait faire quoi, au juste ?
Ces modèles-là sont taillés pour ce qu'on appelle les agents : des programmes à qui on donne une tâche et qui se débrouillent, en cliquant dans un navigateur, en lançant des commandes, en lisant des fichiers. Remplir un formulaire, trier trois cents factures, tester un bout de code, surveiller un dossier et prévenir quand quelque chose bouge.
Le stagiaire idéal : il ne se plaint pas, il ne part pas à midi, et il tient dans une clé USB
Maintenant, soyons honnêtes sur le niveau, parce que c'est là que les communiqués deviennent flous. Sur la fiche technique publiée par NVIDIA elle-même, le gros modèle bat son concurrent chinois Qwen sur la plupart des tests d'agent, mais il reste derrière GLM et DeepSeek dès qu'il s'agit d'écrire du code ou de naviguer sur le web. Et face à ce que j'utilise tous les jours, Claude Code ou ChatGPT, il n'y a pas match : ces deux-là restent très loin devant sur un vrai chantier de développement.
Mais ce n'est pas la bonne comparaison. Claude et ChatGPT tournent dans des hangars à cartes graphiques et facturent à l'usage. Ces modèles-ci tournent sur ta machine, gratuitement, pour toujours, et ne racontent rien à personne. Le match, c'est « un peu moins bon mais chez moi » contre « meilleur mais chez eux ». Selon ce que tu fais, la réponse n'est pas la même.
Concrètement, tu peux l'installer ?
Oui, et c'est le point que je trouve le plus intéressant. Les poids, c'est-à-dire les fichiers du modèle, sont publiés sur Hugging Face, le grand entrepôt public des modèles d'IA. NVIDIA y met aussi les jeux de données et les recettes d'entraînement, ce qui est beaucoup plus rare que la simple mise à disposition d'un fichier.
La licence s'appelle OpenMDW et elle est permissive : tu peux l'utiliser, le modifier, t'en servir au boulot, à condition de garder les mentions d'origine. Ce n'est pas du logiciel libre au sens strict, quelques puristes le font remarquer, mais pour un particulier ou une petite boîte c'est oui, sans astérisque.
Côté pratique, ça s'utilise avec les outils habituels de l'IA à la maison, ceux qui savent faire tourner un modèle sur une carte graphique ordinaire. Si tu as déjà essayé de faire tourner un modèle chez toi, tu connais la chanson, et j'avais raconté l'expérience cet été avec le modèle libre de Meta. La vraie contrainte reste la mémoire de ta carte graphique : 24 gigaoctets, c'est une carte à 1 500 euros, et là tu peux faire tourner le modèle moyen. Avec 4 gigaoctets, c'est-à-dire à peu près n'importe quel ordinateur portable récent, tu as le petit.
Mon avis
Ce qui m'intéresse ici, ce n'est pas le modèle de 120 milliards de paramètres, c'est celui de 4 gigaoctets. Parce que la course aux gros modèles, elle se joue entre cinq entreprises qui ont les moyens de construire des centrales électriques, et on sait déjà comment elle finit.
Alors que le petit modèle qui tient sur une carte à 80 euros, lui, il change la vie de quelqu'un qui veut un assistant vocal dans sa maison sans envoyer sa voix à l'autre bout du monde. Et ça, c'est un truc que je peux bricoler ce week-end !
Sources
- AIwire, 15 octobre 2026 : NVIDIA élargit la famille Nemotron avec Super VL et les modèles Bolt
- MarkTechPost, 15 octobre 2026 : le détail technique de Nemotron 3.5 Super VL
- Hugging Face : les poids, les jeux de données et les recettes publiés par NVIDIA
Article écrit avec l'aide de Claude Code, relu et corrigé par moi.
Rejoignez la conversation
Vous devez avoir un compte pour commenter cet article. La création est gratuite et prend moins d'une minute.
Aucun commentaire pour le moment.