Jev:让人工智能做出决策而不是写句子的模型
Diogo Almeida 曾参与打造让 ChatGPT 变得可用的方法,也就是那个著名的阶段,让人类给模型的回答打分,教它学会规矩。9月15日,他宣布推出自己的模型,Jev,由 TypeSafe AI 发布,这是他刚刚融资4000万美元的公司。而且他做了一件这个圈子里没人料到的事:他的模型不会写作。
不是“它写得不好”。它完全不会写。你给它一个情境,它给你一个决定。不是一句话,不是一段话,也不是“当然,以下是我的看法”:而是从你自己设定的列表中选出的一个勾选项,旁边还附着一个置信度百分比。
你可能会说这是倒退。我们认真两分钟:这也许是本周这个领域里推出的最有意思的东西,原因非常简单,我会尽量把它讲明白。
Jev 到底返回什么
传统语言模型靠说话工作。你让它把一张发票归入正确的类别,它会写一句漂亮的话来完成这件事:“根据现有信息,这张发票似乎属于办公用品类别。”三十个词,每个词两百毫秒,传达四个词的信息。这有点像你问修车工你的轮胎是不是瘪了,结果收到一封求职信。
Jev 不这么做。它的输出是一组带类型的值,也就是说,这些东西的类型事先就是已知的:一个介于0和1之间的数字,一个从列表中选出的类别,一个真或假。它的列表最多可以接受255个可能的回答,超过一百个之后,它会把决定拆成两个评分阶段,以免自己搞混。
创始人用一句我觉得说得非常漂亮的话概括了这件事:“一个拥有尖端智能的函数调用。”一团杂乱的输入,一个整齐的输出。没有别的。
为什么它快两百倍
一个会写作的模型会逐词前进。在完成第一句话之前,它无法开始第二句话,因为每个生成的词都会成为下一个词的输入。这是一条链,而一条链的速度取决于它最慢的那一环。
一个决定不需要按顺序构建。TypeSafe 把这称为并行采样器:模型在同一轮计算中同时处理所有可能性,然后一起输出分数。不需要等待第二个词,所以根本不存在等待。
一个窗口逐份处理材料,或者三十个窗口同时开放
公布的数字符合这个逻辑。延迟在70到500毫秒之间,而市场上最重型的模型需要3到329秒。329秒并不是夸张:这是一个大型模型输出一段很长的推理所需的时间,也是 TypeSafe 用来和竞争对手比较的数字。
至于价格,那就简直残酷了。在 TypeSafe,输入一百万个令牌的费用是0.042美元。输出免费:他们的页面白纸黑字地写着,“便宜到无法衡量”。根据他们自己的测试,他们声称速度比文本模型快193.6倍,价格低444.6倍,在适合他们的任务上最高可以达到200倍。
数字,以及随之而来的陷阱
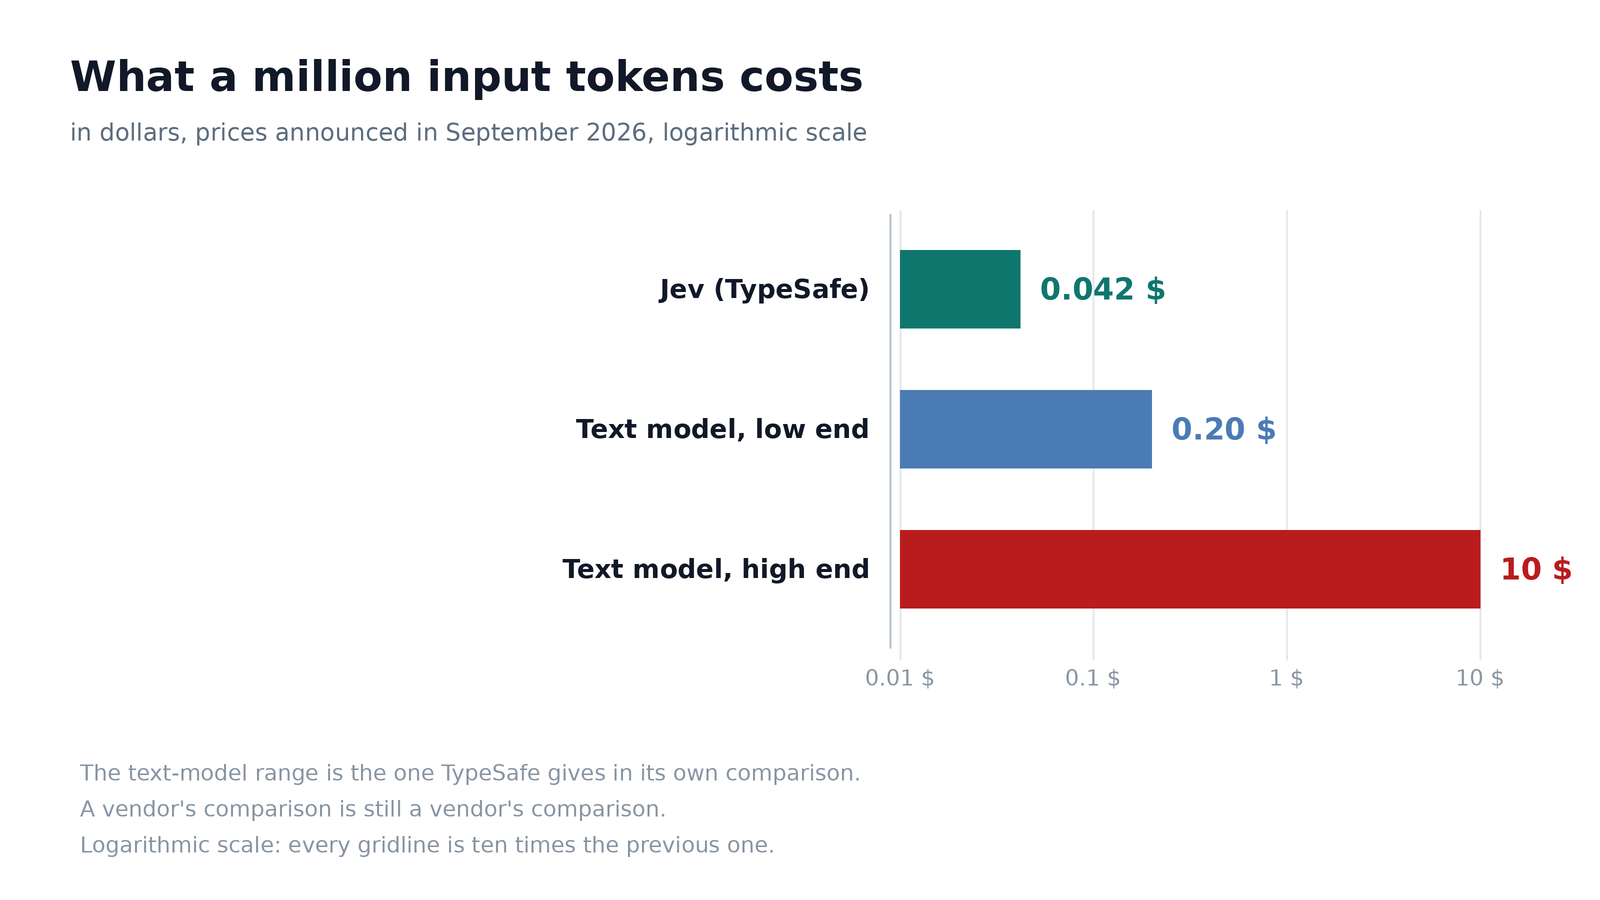
一百万个令牌的输入价格,以及卖家自己给出的文本模型价格范围
你得读一下那行小字,而且那行字是 TypeSafe 自己写的:这193.6和444.6来自他们自己的测试,这些测试由他们的团队搭建,而他们拿来比较的基准是他们自己选的两个模型的平均值。他们没有等别人要求就把这点写了出来,这一点确实值得称赞,但这仍然是卖家进行的比较。外部人士做的测量结果更接近快5到25倍,这已经非常夸张,而且和200倍这个数完全不是一回事。
还有三个需要记住的细节,我更愿意现在就说出来。这一切背后没有任何科学论文,没有发表过任何可靠性曲线,尽管这套方法的核心恰恰是置信度校准的问题。没有点名任何客户,没有给出任何销售数字,访问需要排队等候。而当有人问创始人,他的模型归根结底是不是一个高级分类器时,他回答说“没错”,随后拒绝描述其架构。
这不一定可疑:一家刚成立两个月、刚从匿名状态走出来的公司,没什么东西可展示。但这意味着如今买到的是一份带价格的承诺,不是经过验证的产品。
它不会做什么,这一点必须说清楚
这是一种在提问之前就要先选定可能答案的模型。所以如果正确答案不在你的列表里,它就会选择最不坏的那个,并给这个错误配上一个漂亮的置信度百分比。你不能让它写一篇文章,也不能让它写一道菜谱,更不能让它总结一份文档。它无法编造模式中不存在的值,这让严格意义上的幻觉变得不可能,但这并不能阻止它选错格子。这一点很重要,因为这正是这家公司宣传中含糊带过的地方。
在他们自己针对真实任务进行的评估中,表格显示成功率为67.8%。相比之下,Opus 5为73.1%,Sol为74.1%。换句话说,在总体判断上,大型文本模型仍然领先。Jev赢的不是回答质量,而是获得回答所需的价格和时间。
具体来说,这对你有什么改变?
我们在家里让人工智能做的大多数事情,都不需要任何写作。照片里有脸还是风景?这封邮件是广告还是学校发来的消息?现在是不是该打开暖气?在这一类问题里,答案就是是或否。在这些情况下,完整的句子从来没有用过,只是因为没有别的办法,我们才为它付钱。
家庭照片分类:机器负责整理,没人阅读任何内容,账单缩减了二十倍
真正的影响,在于家庭规模下的价格和速度。一台在夜间整理手机照片的盒子,一台在你打开邮件之前就把它们分类的服务器,一款为每一小段声音决定它是语音还是音乐的字幕软件:这些任务过去都要花钱调用一台文学引擎来勾选选项。如果公布的价格能够长期维持,这些功能就会便宜到足以一直运行,而不再是让人犹豫要不要开启的设置。
不过,期限还不是明天早上。产品目前处于提前访问阶段,需要排队等候,没有公开客户。而对于0.042美元的价格,这家公司自己也承认无法证明它没有得到补贴。这是一家通过购买用户来推广自己的年轻企业所给出的引流价,还不是市场价格。我对令牌账单已经足够熟悉,知道启动价并不能说明两年后我们要支付的价格。
如果你是开发者
真正的关键就在这里,因为这个产品卖给的是程序,而不是人类。你描述输出模式,发送系统状态,就会直接收到一个可以使用的决定,后面不需要再做文本分析。
POST /v1/decisions
{
  "schema": { "categorie": ["facture", "devis", "publicite", "autre"] },
  "input": "<le texte ou l'etat du systeme>"
}
# reponse : categorie = "devis" (0.94)
节省的不只是成本:你不必再编写代码去解析自然语言回答。“模型回答了是,但它用了段落的形式,还得把值提取出来。”这种情况不会再有。输出本身已经是数据。
有两个开发者角度的保留意见,我没看到宣传中对此进行处理。模式需要设计,而一个设计糟糕的模式会以94%的置信度给你返回校准得无比精准的错误。而且公布的负载数据来自一个限制访问的服务:高峰流量下没有任何延迟保证,也没有任何可用性承诺。拿来自己折腾,完全没问题。至于那种需要在夜里大家都睡着时仍然响应的东西,我们还得等着看。
上个月,我在另一篇文章里解释过,下一代 Astra 不会响应得更快,而是会工作得更久。这就是当时的大趋势:模型花三十秒思考,以换取更高的质量。现在,家里的一位老将却恰恰朝着相反的方向走,接受在精细程度上有所牺牲,换来时间上的收益。这两种方式并不互相排斥,它们只是分担了工作:值得思考的事情交给长时间推理,其余一切则立即做出决定。
自从读到他们公布的数据,我一直在问自己一个问题,但我没有答案:如果我们让人工智能做的事情有一半从来都不需要它写东西,那我们还要按字付费购买这种本该按决策出售的东西多久?
加入对话
您必须拥有一个账户才能评论这篇文章。注册免费,耗时不到一分钟。
目前没有评论。