GPT-6 Astra 发布了:真的值得 2.5 倍的价格吗?
GPT-6 Astra 发布了:它真的值 2.5 倍的价格吗?
OpenAI 周三晚上放出了 GPT-6 Astra,从昨天开始,它就陆续进入 ChatGPT,供 Plus、Pro、Business 和 Enterprise 用户使用,开发者也可以把它接入自己的程序。
这个行业里引用最多的独立排名,也就是 Artificial Analysis,给它打了 61 分,满分 100。给 GPT-5.6 Sol,OpenAI 用来替代的那个模型,它打了……也是 61 分。而 Astra 的价格贵了两倍半。
好了,文章结束,我们被当成了冤大头,祝大家愉快。
但不是这样。这个 61 分已经说明不了多少问题,真正有意思的东西在别处,在一栏没人看的地方。
与此同时,过去两天里,另一张表格到处流传,里面有 98% 和 100%,所有人都在谈论有史以来最先进的模型。这两张图都是真的。得把这事理清楚。
考试分数一样,价格却是两倍半。这得给我解释一下。
首先,这个传说中的 61 到底是什么
Artificial Analysis 是一家独立公司,它让市场上的所有模型参加同样的考试,每次都在相同条件下进行,然后算出一个平均分。数学、科学推理、代码、常识。这是一张成绩单,页面底部用大号字写着总平均分。和所有成绩单一样,这个平均分掩盖了最重要的东西。
因为总有那么一刻,考试不再能给学生排名。当全班交上来的听写都没有一个错误时,这场听写就不再说明谁是最好的,它只说明这场听写太简单了。我们现在正好走到了这一步:模型一个接一个地把测试做到了饱和,而与此同时,它们正在一些测试测不到的东西上进步。
顺便说一句,还是马上说清楚吧,因为藏着不说也不会变好:在同一个排名里,最好的不是 OpenAI。Anthropic 的 Claude Fable 5.1 是 66 分,Meta 的 Muse Spark 1.3 是 62 分,Astra 是 61 分。这个被宣布为世界冠军的家伙,在独立裁判那里排第三。
那张 98.6% 的表格又值什么?
它是真的。这是 OpenAI 自己在发布页面上公布的成绩表,下面还有脚注和他们自制的考试。
所有人都指着看的那一行是第一行:ARC-AGI-3。Astra 98.6%,它替代的模型 7.8%,Anthropic 的 Claude Opus 5 是 30.2%。这么一看,这已经不是差了一代,而是一头大象..
ARC-AGI-3 不是常识问答。你把机器扔进一个它从没见过的小游戏里。没人告诉它规则,也没人告诉它目标,更没人告诉它按钮是干什么的。它得自己摸索,弄明白自己掉进了什么地方,自己设定一个目标,然后实现它。这东西就是故意做出来的,好让把整个互联网都吞下去这件事派不上用场:答案在任何地方都不存在,它得当场找出来。
而这就是真正厉害的地方。在这个测试中,在基础条件下,OpenAI 之前的模型当时最高只能达到 7.8%。Astra 在完全相同的条件下,升到了 62.7%。几个月里变好八倍,而且是在一个专门设计来抵抗的测试上。这个数字,谁也不能贬低。
等等。既然是 62.7,那表格为什么写着 98.6?
对,这正是整件事有意思的地方。同一个模型,两条路线,两套管道。第一条路线里,机器每走一步之间都会丢掉自己推理的线索:它只保留自己想到要写下来的那几条笔记。第二条路线里,它会保留脑子里原本的全部内容,并且一路把它们总结下去。同一个模型,同样的问题,同样的卡片。一边是 62.7,另一边是 98.6。
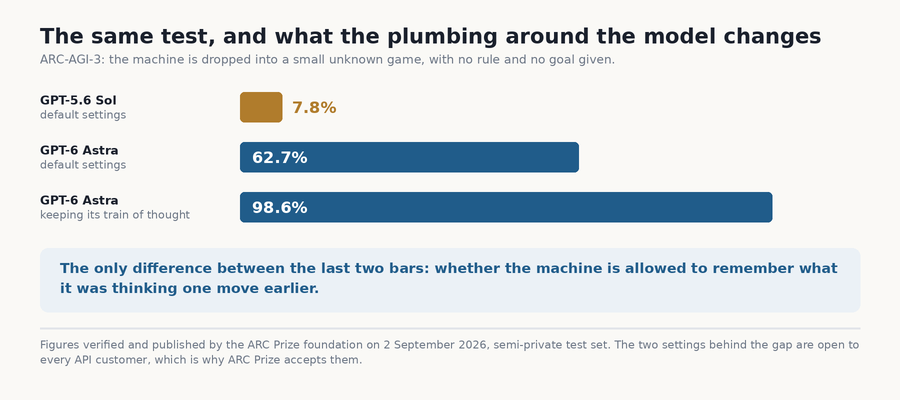
最后两根柱子之间,模型没有变。它的记忆变了。
我本来就是在这里等着找猫腻的,结果其实没有。问题中的两个设置不是临时搭出来的摆设:它们是对所有编程接口客户开放的普通选项,也正因为如此,负责这项测试的基金会 ARC Prize 接受了这个结果,还亲自核验过。OpenAI 的榜单可以被批评的地方,是它把自己的最佳成绩拿来对比其他人的基础成绩,却没有在同一个格子里说清楚。
有两件事值得记住,第二件比第一件更有用。首先,ARC Prize 在自己的报告里白纸黑字地写道,通过这项测试并不能证明具备通用智能,它也没有声称这就是通用智能。其次,如果你在捣鼓这些模型:保留模型在不同步骤之间的推理,让机器在同样的任务上快了 3.66 倍,并且少消耗了 49% 的令牌。关键不在模型里,关键在于你调用它的方式。
哦,还有一个让我抬起头来的细节:在 96% 的关卡中,Astra 用的步数比人类更少就走到了终点。平均少了一半。
所以,这是革命还是不是?
两个严肃的实验室在同一周测量了同一个模型,却得出了两个相反的结论。
Epoch AI 把它排在第一,而且遥遥领先,得分 169。Artificial Analysis 给它打了 61 分,和它的前代产品并列。两边都没有作弊。他们只是没有给同样的考试题加同样的权重:Epoch 加重了数学和谜题,而 Astra 在那里把所有人都甩在身后;Artificial Analysis 加重了代码,而 Claude Fable 5.1 在那里依然领先。
所以,只要这句话没有以“用来做什么”收尾,“这是不是一场革命”这个问题就没有答案。要是用来推理、探索、独自在陌生的东西里想办法,是的,这一步很大。要是用来整天写代码,不,这周什么都没变。
François Chollet 就是那个发明了这项测试、而且并不以热情著称的人,但他还是把自己的预测提前了。有人问他的 2030 年预期是否仍然成立。他的回答是:“更早,因为进展来得比我想的更快。”
我的看法,值多少就算多少:这不是一场革命,而是一级台阶。但这一级很高,而且它出现在一个我们多年来一直被反复告知这些机器永远爬不上去的地方,也就是一种没有人提前向它们描述过的情境。
它只说原来三分之一的话,就完成同样的工作
这就是没人看的那一列。
这些机器按令牌收费。一个令牌就是一小段单词:“anticonstitutionnellement”要占好几个,“le”占一个。你输入的所有内容都会被切成令牌,机器回答的所有内容也一样,而账单会把两边都算进去。Astra 的输入价格从每百万令牌 4 美元涨到了 10 美元,输出价格从每百万令牌 20 美元涨到了 50 美元。所以才会贵 2.5 倍。
现在来看这笔账的另一半。Artificial Analysis 有一项测试,模型不是回答一个问题,而是独自完成一个真正的代码项目,从头做到尾,就像一个开发者接到一个工单后被放任不管。在这项测试中,Astra 消耗的令牌大约只有它前代产品的三分之一就完成了工作。
令牌贵了两倍半,令牌却少了三倍。你自己算算。任务完成后的价格比以前还低一点,Artificial Analysis 还特别指出,在这个排名上,Astra 达到了 Claude Fable 5 的水平,花的钱更少。
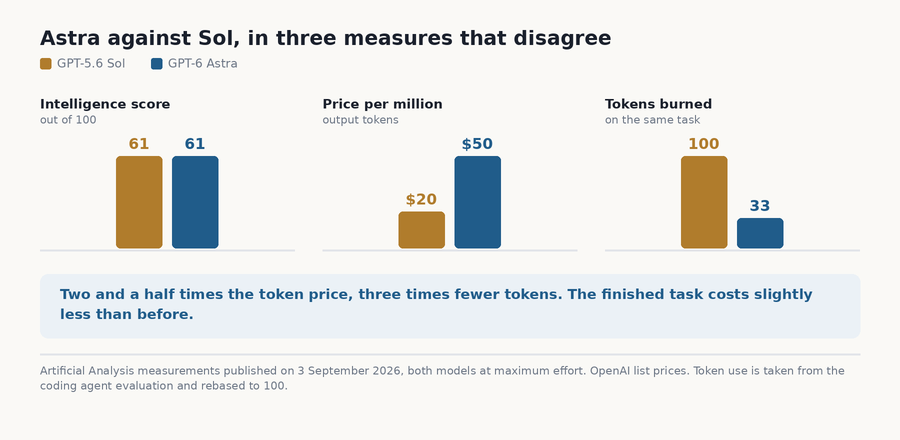
三列,三个不同的故事。猜猜 OpenAI 把哪一列放到了海报上。
这就像一辆每公里 2.50 欧元、认得路的出租车,对上一辆每公里 1 欧元、却要绕着街区转三圈才能找到你那条街的出租车。第一辆车的计价器在你上车时让人害怕。真正让你破产的是第二辆。
我来告诉你为什么这个数字对我来说比 61 更有说服力。用 Claude Code 的时候,我的屏幕底部一直显示着在重置前还剩多少百分比的额度。这个百分比不会因为模型聪明就下降,而是模型话多就下降。一个模型绕圈子转上二十分钟,把同一个文件来回读三遍,因为迷路了又从头开始推理,它让我花掉一大笔钱,却什么也没带给我。所以“消耗少三倍”,老实说,这是那份公告里我会读两遍的一句话。
而当它不知道时,它开始说出来
这是 Artificial Analysis 的另一项指标,也是我最喜欢的一项。他们提出一些有答案的问题,观察模型面对那些它掌握不了的问题时会怎么做,然后统计它有多少次会编造答案,而不是承认自己不知道。
GPT-5.6 Sol 有 92% 的情况会编造。Astra 降到了 51%。
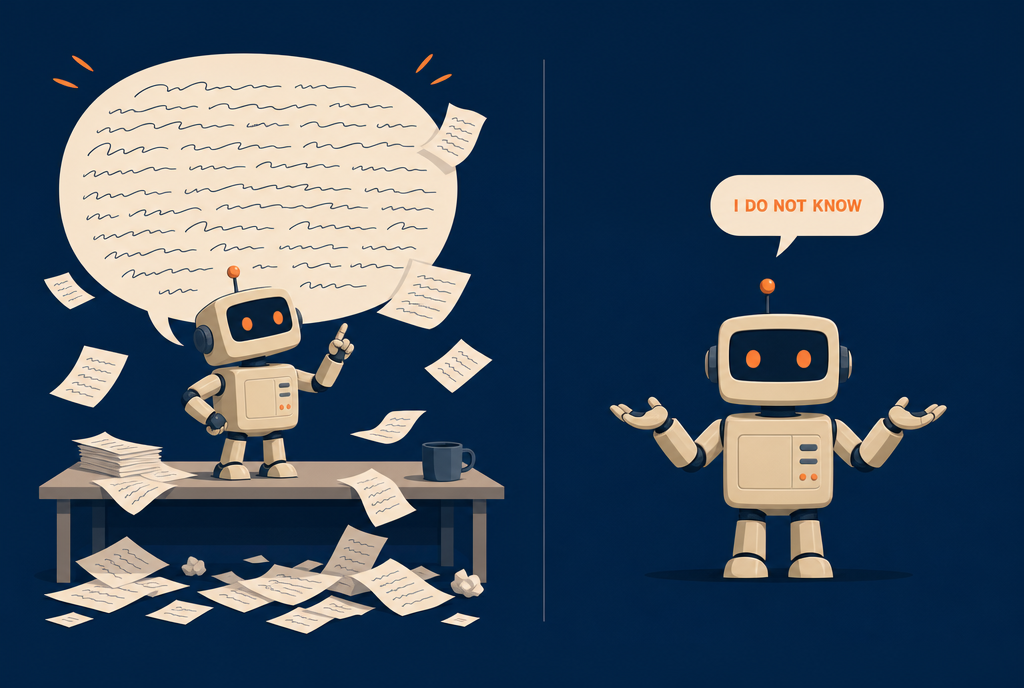
今年的进步,不是更出色的回答。而是耸了耸肩。
这非常了不起,而且这种进步不会出现在任何海报上,因为它实在不太好讲。一台会说“我不知道”的机器,在发布会上可演示不出什么漂亮的效果。但如果你曾经花一个晚上去核对某个模型信誓旦旦告诉你的参考资料,结果发现那东西根本不存在,你就完全知道这个数字值多少钱。
话虽如此,我们说的是一半的情况。比以前好了一倍,但仍然有一半的情况会这样。我们还没走到头。
而用来写代码,它能打败 Claude Code 吗?
这是所有人都在问的问题,诚实的回答是不。至少今天还不能。
在 OpenAI 的表格上,Astra 赢下了代码修复测试,也就是给它一个真实项目里的真实 bug,然后看机器能不能修好:74.1% 对 Claude Fable 5.1 的 67.4%。漂亮的胜利。
问题是,这项测试更像考试,而不是一天的工作。在那项更像一天工作的测试里,模型必须使用工具,在一段时间内完成整个项目,Claude Code 里的 Claude Fable 5.1 是 70,而 Codex 里的 Astra 是 67。差距很小,但方向就是这样。
实际用起来,分工相当明确:Astra 适合操控一台机器,连续调用各种工具,从头到尾完成一件事,以及所有和科学有关的事情;Claude 适合在一个大型代码库里待上几个小时而不迷失方向。我那些长期项目不会动它们。但这周我会把一个又老又脏的项目塞给它,看看它会是什么表情!
那如果你这辈子一行代码都没写过呢?
问得好,因为到目前为止我一直在跟你说令牌和排名,而这些东西可填不饱冰箱。
这一代真正的变化,是持续工作的时间。以前的模型会回答一个问题。这个模型就是为了长时间独自开始工作而设计的,它会连续完成各个步骤,使用工具,自己在浏览器里点击。它的工作记忆已经达到一百多万个令牌,也就是大约十本厚厚的小说,并且能在整个项目过程中从头到尾记在脑子里。
以前:一个每三分钟就得重新催一下的优秀短跑运动员。现在:一个早上出发,晚上带着完成的工作回来的家伙。
在你的生活里,它是什么样?是你交上材料、盯着系统看,而不是一格一格敲进去的报税表。是你深恶痛绝的互助保险资料,六张表格和三份附件,交给某个会替你点击的东西。是八十张要分类、重命名和整理的度假照片,谁也从来不做,因为这要花两个小时,而人生苦短。
什么时候?老实说,不是明天早上。这类任务在演示里能跑,一旦网站把一个按钮换了位置就会翻车。算上几年吧,才能可靠到可以不盯着它也让它自己做。记住,第一个会识别你声音的手机,花了十年才变成那个不会弄错就能替你设定计时器的助手。我们现在大概就在历史的同一个位置。
他们锁起来的那一块
Astra 有一部分你不会拿到,而这一次我觉得这样挺健康。
OpenAI 把这个模型列在其自身计算机安全风险等级的最高级别。说白了:它知道如何在保护严密的软件里找到漏洞,还能自己写出钻进漏洞的程序。你在 ChatGPT 里用到的版本会拒绝这类请求,而完整能力只对经过严格筛选的组织开放。我前天还说过这件事,当时三家大实验室在相隔几小时的同一天推出了自己的黑客模型。
这里新鲜的地方在于,这东西现在已经进入了面向大众的产品,里面还关着一扇门。它能撑多久就撑多久吧。
好吧,那我们到底要不要切换?
如果你在付费使用 ChatGPT,你没什么可决定的,它会自己到来,而且比你昨天用的更好。享受吧。
如果你在上面构建什么东西,而且按使用量付费,千万别只看显示出来的令牌价格,这就是这次发布的陷阱。真正测量一下完成一项任务会让你花多少钱,放到你自己的工作上测。在需要分类或提取的文本上,模型只做两行就闭嘴,Astra 只是平白贵了 2.5 倍,别碰它。在机器能自己干上一小时的长期任务上,情况正好相反。
今天早上还有一件事让我挺高兴。二十五天前,我就在这里写过,Astra 不会回答得更快,而是会工作更久,这才是真正的切换。本周的数据说的正是这件事:通用考试分数原地踏步,耐力和节制能力却猛增。我们正在改变衡量标准,却没人宣布这件事,而那些海报还在继续兜售智商分数。
那么我们还要互相传递百分制分数多久,同时假装那意味着什么?对我来说,如今唯一让我感兴趣的问题是:完成的工作要花多少钱,而且它公平吗?
来源
- ARC Prize : OpenAI's GPT-6 Astra on ARC-AGI-3,分析该测试背后的基金会、两个测试套件及其62.7%和98.6%的成绩、与人类的比较,以及关于通用智能的明确警告
- ARC Prize : GPT-6 Astra, ARC-AGI Results,2026年9月2日,逐项努力和逐个测试套件核验的分数表
- OpenAI : How enabling two settings tripled our scores on the ARC-AGI-3 benchmark,涉及的两个设置,由OpenAI亲自描述
- The Decoder : Benchmarks disagree on GPT-6 Astra,Epoch AI的169分与Artificial Analysis的61分,为什么两者存在差异,以及François Chollet提前作出的预测
- Artificial Analysis : Benchmarking GPT-6 Astra,2026年9月3日的独立测量、智能评分、代码工程测试、令牌消耗量和虚构回答率
- OpenAI : GPT-6 Astra, a new generation of intelligence,原始公告、价格、工作记忆大小和部署情况
- Requesty : GPT-6 Astra scores 61 on the independent index, the same as Sol, at 2.5x the price,发布时的宣传与独立测量结果的比较
- Tech Startups : Top tech news today, September 4, 2026,在ChatGPT和各家托管服务商处的部署时间表
加入对话
您必须拥有一个账户才能评论这篇文章。注册免费,耗时不到一分钟。
目前没有评论。