GPT-6 Sol et Luna:便宜一半,评分却没变
两天三条公告,最后只剩一个问题:谁来买单。9月21日,xAI把 Grok 4.7 的输入价格降到每百万 tokens 两美元。22日,Anthropic发布 Opus 5.5。九十分钟后,OpenAI放出 GPT-6 Sol 和 GPT-6 Luna,而 Sol 的输入价格恰好和 Grok 一样。当三家实验室间隔九十分钟互相回应时,这就不再是产品发布,而是一场反向竞价。
给那些从没付过 API 账单的人简单解释一下,API 是程序不用经过聊天窗口就能向模型提问的那扇门。一个 token,就是一个词的一小块。按法语计算,可以把它当成四分之三个词。这样一百万 tokens 大约就是 750,000 个词,相当于七本厚厚的书。当价格从每百万 4 美元降到 2 美元时,这不是超市促销,而是账单凭空蒸发了一半。
OpenAI 宣布了什么,价格又是多少
两个模型,Sol 和 Luna,替代 GPT-5.6 Sol 和 GPT-5.6 Luna。Sol 是大的那个,Luna 则是快而便宜的那个。
OpenAI 模型页面上的价格,我在9月23日看到的是:Sol 输入 2 美元,输出 10 美元,而它的前代分别是 4 美元和 20 美元。Luna 则是 10 美分和 50 美分,而前代是 20 美分和 1.20 美元。价格干净利落地减半,官方说这是永久价格,不是发布促销。
其实,价格战并不是这周才开始的。上周,一个中国模型 Fugu Ultra v2 就已经吹嘘自己不用费劲便能击败 GPT-6 Astra,而且价格只有一半。
好吧,这里有一个没人会看的“但是”。一次可以发送给模型的内容,也就是所谓的上下文,在这里增加到了 1.05 million tokens。只是超过 272,000 之后,输入会重新按全价计算,输出则变成原价的 1.5 倍。而当一个程序把同一个问题重复问一百次时,供应商不会再次收取已经读过的内容:重读便宜 90%。这是为循环运行的程序量身定做的价格,不是为周日聊天准备的。
这会怎样反映在账单上
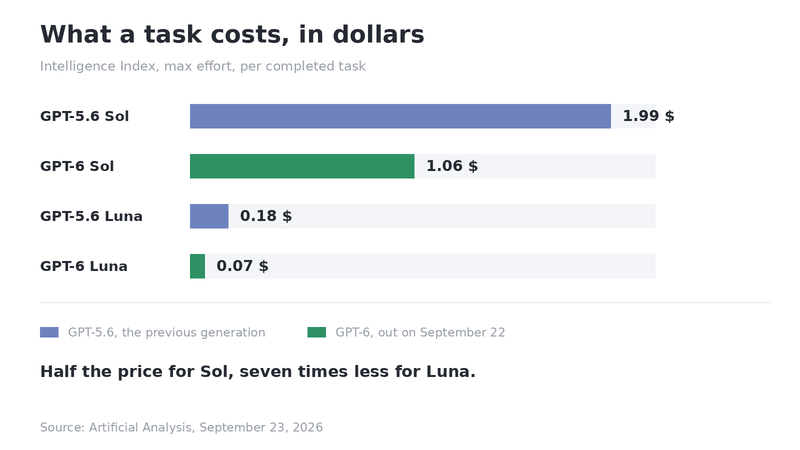
同一项任务,同一场测试,相隔两代
每百万 tokens 的价格,没人看得懂。Artificial Analysis 是一家独立机构,它让模型在相同测试中运行,并发布带有测试日期的记录,它测量的是另一件事:完成一项任务的成本。而在9月23日,结果是这样的。
Sol 全力运行:每项任务 1.06 美元,而 GPT-5.6 Sol 是 1.99 美元。Luna:7 美分,而另一边是 18 美分。对于一整晚连续执行任务的脚本来说,差距根本不用争。
注意这个会改变图表解读的细节。这两个模型写得比以前更多。Sol 的输出是 31,000 tokens,而不是 29,000,Luna 是 51,000,而不是 41,000。下降来自价格,而不是模型变得节省。它思考的时间更长,说得更多,只是每个词的价格更低了。这不是细节,而是故事的一半。
不断上升的分数,以及两个倒退的分数
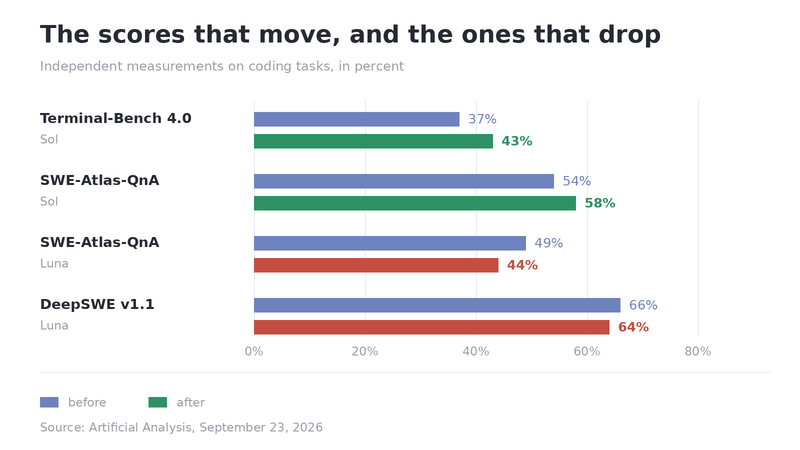
在相同测试中,Sol 前进,Luna 后退
在代码测试中,Sol 有所进步。Terminal-Bench 4.0,也就是要在终端里完成任务的测试(安装、修复、重新运行,直到它能正常工作),从 37% 上升到 43%。关于真实代码的提问测试 SWE-Atlas-QnA,从 54% 上升到 58%。这家机构的代码指数把所有内容混在一起计算,也增加了两分。
只是 Luna 走上了相反的路。同一个指数丢了两分,提问从 49% 降到 44%,修复 bug 从 66% 降到 64%。小的那个在大的那个前进时倒退了。这家机构的结论很诚实,也有点平淡:两者仍然处于 GPT-5.6 的水平,在一些地方有所进步,在另一些地方有所倒退。
还有一个地方,两者都明显退步了。在 GDPval 这项由专业人士比较模型产出成果的测试中,Sol 大约掉了一百个 Elo 分,Luna 掉了七十五分。Elo 是国际象棋棋手排名的单位:分数越低,落后得越远。原因比跌幅更有意思:呈现上没那么用心了,成果也会漏掉一些顺手要求的元素。模型写得更好,却交出了一份更潦草的答卷,这正是没人想要的那种进步。
这正是该重新拿出我在 GPT-6 Astra 发布时提出的那个问题的时候:性能真的值得两倍半的价格吗。OpenAI 给出的答案正好相反。不是性能上涨来证明价格合理,而是价格下降了。
幻觉率的陷阱
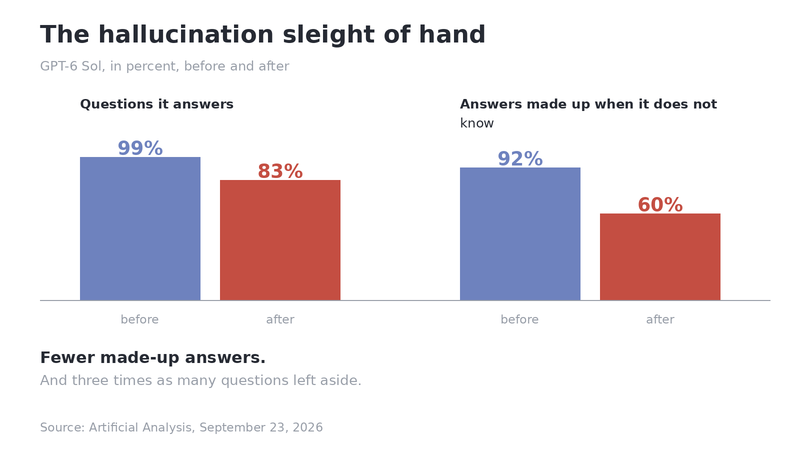
两根柱子都下降了,但只有一根是好消息
这是本周所有人都在转发的数字:在同一家机构的专业知识测试中,Sol 编造答案的倾向从 92% 暴跌到 60%,Luna 则从 93% 降到 77%。这样呈现出来,确实很惊人。
看看图里的第二根柱子。同一份记录显示,它现在只会在 83% 的问题上尝试回答,而之前是 99%,并且在全部问题中,正确答案的比例从 59% 降到了 54%。所以它每六个问题就放弃一个,最终给出的正确答案总数比以前还少。
这确实更好了,明显更好了,这家机构也这么说:在它的综合知识评分中,Sol 从 22 分升到了 27 分。但这不是那个醒目数字单独宣布的进步。一个模型因为少尝试,所以少编造,这叫字典。对于一个连续执行任务、背后却没有人盯着的程序来说,这个缺口意味着一个任务执行到一半就停了。
具体来说,这对你有什么改变
你从来不会在厨房里调用 OpenAI 的接口。不过你每天都在使用运行于其上的各种东西,事情就发生在这里。
三个你能感同身受的例子。浏览器里的自动翻译,那个让你点一下就能把德语网页变成法语的功能:每翻译一个页面,某个地方就会产生一笔账单,而把这笔账单除以二,才能让这个功能继续免费。然后是所有这些已经开始替你回答的助手(你银行的聊天机器人、会议摘要、手机的语音备忘录):它们都按同一个 token 计费,而价格除以二,就意味着服务商在同一个订阅里可以提供两倍这样的功能。如果你还会捣鼓代码,哪怕只是写些整理照片的脚本,降低的也是你自己的账单。
不过,不要指望你的订阅价格也会下降。这几乎从来不会发生。token 的价格下降了,功能增加了,而你银行账单上的那一行纹丝不动。移动数据就是这样:十五年前,一个千兆字节要花一顿饭钱,如今它被淹没在一个十五欧元的套餐里,再也没人去计算它了。
我的看法
最后还有一件事,这件事发生在屏幕的我这一侧。我同时在三个项目上运行三个 Claude Code 会话,有时候我会在配额重置前查看计数器,就像查看油箱表一样。在这个场景里,一个 token 的价格不是抽象的数字:它决定了我能不能让一台机器在我睡觉的时候继续工作。
对我来说,这是本周最好的消息,而且原因不是大家以为的那个。我不需要这个月的模型比上个月的模型更聪明。我需要它用便宜一半的价格完成同样的工作,因为这决定了某个东西能不能一直运行,还是只有我按下按钮时才运行。
不过 Luna 退步了,Sol 交出的答卷也更潦草了。两者都大了一岁,账单却轻了一点,只是里面的用心也少了一点。这个交换我愿意拿来换我的脚本,但不是所有东西都这样换。
总之,谢谢你把价格除以二,我们收下了。也祝 Grok 和 Opus 好运,它们当了九十分钟的价格冠军。
加入对话
您必须拥有一个账户才能评论这篇文章。注册免费,耗时不到一分钟。
目前没有评论。