为什么人工智能生成的文本带有隐形标记
如果你从8月2日开始让AI助手翻译合同、总结报告,或者帮你重写一封信,那么你收到的文本就带着一个标记,不是印章,不是页脚的一行字,也不是用好的文本编辑器就能删掉的隐藏字符:这是一个藏在措辞选择里的隐形标记,你读不出来。
这不是Anthropic或OpenAI的主意,这是2026年8月2日开始生效的一项欧洲义务,针对的是所有在欧洲销售的AI供应商,即使在欧洲连一个办公室都没有。
我来告诉你法律到底要求什么,这个标记是怎么生成的,尤其是它能证明什么,以及它不能证明什么,因为大家正是在这里搞错,包括一些非常严肃的人。
法律要求四件事,其中两件和你有关
《AI法案》第50条,也就是欧洲人工智能条例,提出了四项义务,一个会和你聊天的助手必须告诉你正在和一台机器说话,除非这一点显而易见,一个识别情绪或给人分类的系统必须提醒它所检查的人,一段伪造内容,比如那些让什么都没说过的人说出任何胡话的视频,必须被标记为伪造,而一个生成文本、声音、图像或视频的系统必须在其中插入机器可读的标记。
后两项会落到你头上,因为它们针对的不再只是制造商,也包括发布者,但有一个能让你脱身的例外,而且很重要:如果确实有人工审阅并对发布负责,就不再强制要求标签,换句话说,法律不是要求你说有AI参与,而是要求你在没有人核查时说明这一点。
对于8月2日之前已经上线的系统,有一个期限:它们最迟要在2026年12月2日前合规,而且没有任何追溯效力,这个日期之前生成的文本不需要加标签。
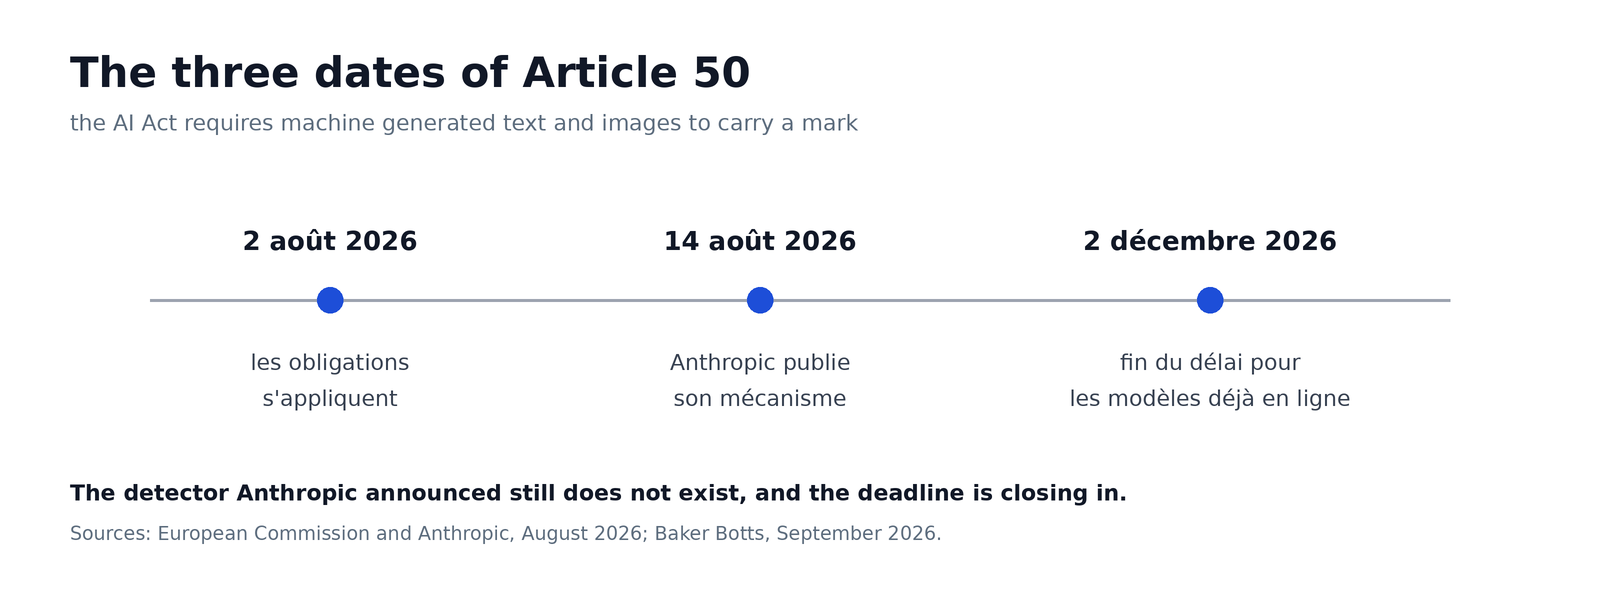
三个日期:8月2日开始履行义务,14日Anthropic作出解释,12月2日让已经上线的系统补上合规,前两个日期之间相隔十二天,这就是决定要不要说出来的时间
最后,AI法案在2024年规定的罚款最高可达1500万欧元或全球营业额的3%,两者取较高者,一想到哪怕自己叫OpenAI也得面对这种金额,就足以让人好好想想,这就是为什么一家美国实验室当天就开始给自己的输出加标记,而且是在全世界范围内这么做,而不是只在欧洲做,当账单是按营业额的百分比来算时,就没必要争论地理范围了,直接采用到处都有效的版本。
如何把隐形标记放进一句话里
所有人想象的都是这样一种水印,在两个词之间塞进一个不可见字符,或者在文件属性里藏一行字,但完全不是这么回事,而这对后面非常关键,因为它会彻底改变我们能拿它做什么。
Anthropic使用的方法来自Google在2024年发表于《Nature》杂志的一项研究,它有一个名字:SynthID-Text,其原理可以归结为一个简单的想法,当模型写东西时,它一直在几个都合适的词之间犹豫:重要、关键、核心、必要,而有了这个标记,就会由一把秘密钥匙逐词决定这些候选词中的哪一个,但从来不会强迫它使用一个它自己原本没考虑过的词。
词汇并没有被一分为二,文本还是原来的文本,但这一连串细小的选择带着一道只有这把钥匙才能识别的签名,一个词什么也证明不了,Anthropic说,需要500到1,000个词,拥有这把钥匙的检测器才能看出这个模式逐渐成形,而Anthropic在8月14日把一切都解释清楚了,也就是在开始悄悄加标记十二天之后。
这个标记能证明什么,以及它不能证明什么
大多数文章都在这里搞错了,所以我慢慢说,这个标记说明文本经过了Claude,它没有说明是谁写的。
你的求职信,你完全可以自己花三个晚上手写出来,然后让Claude改错字,最后它还是会带标记,法律恰恰把语法纠正和经典编辑功能排除在外,但Anthropic解释说,它无法区分一整篇文本经过机器和只有一个逗号经过机器,所以无论哪种情况它都会加标记,这对它来说是最谨慎的选择,对你来说却是最没用的选择。
而且根本不存在任何检测器。Anthropic 承诺过一个免费的检测工具,向其他软件开放,但它到现在还没出现:截至9月23日,Anthropic 之外没有任何人能读取这个标记。一个拿到密钥的老师可以说某段文字经过了机器处理。你用浏览器什么都无法验证。这种失衡正是让人皱眉的地方,很难说它没有道理。
一位老师,一支红笔和一摞作业。没有密钥,他什么也读不出来;有了密钥,他也只能读出某段文字经过了机器处理,永远不知道是谁想出的
为什么有人把它叫作间谍标记
9月21日发布在 Brand.io 网站上的一篇文章,后来被整个技术媒体圈转载,提出了一个不同于水印的词:spymark,间谍标记。这个说法可以用一句话概括。水印是看得见的,公开声明的,也是静止不动的,一个你看见了却不理会的标记。间谍标记看不见,能抵抗格式变化,而且只有你没有选择的那些人才能读取。
这个词汇背后的技术要点比词汇本身更有意思。在图像中,照片版 SynthID 会存放一个足够长的序列号,用来指向数据库中的一条记录。图像不只是说它由机器生成,还可以说是通过哪条提示词、在什么时间、从哪个账户生成的。对于文本,Anthropic 描述的是同一种机制,只是换了一种形式:密钥在它那里,也在它愿意交给密钥的人那里。剩下的只是给这份名单命名:监管机构、警察、编辑部、验证公司。你不在其中,这多少就是问题所在。
最麻烦的情况甚至不是从这里来的。Microsoft 会在 Paint 生成的图像中编码一个标识符,包括那些本应在本地完成计算的 Copilot+ 设备,而附在文件上的技术信息,那份通常会描述照片包含哪些隐藏信息的说明,却没有提到它。是一名研究人员通过分析程序找到了这个东西,不是 Microsoft 把它写进文档的。细节在软件里,却永远不在说明书里,这也是一种沟通方式。
具体来说,这对你有什么改变
三件事,而且这周至少有一件你已经遇上了。
你用手机拍的那张餐盘照片从来没有经过图像生成器。等到有人想把照片分成两堆的那一天,这个细节就会派上用场
先说你家孩子的作业。今天什么都不会改变,因为没有人能读取这个标记,你不能,他的老师也不能。那些声称能揪出人工智能文本的工具,还是和昨天一样,只是在猜。等到一所学校拿到密钥,情况就会反过来:标记会说某段文字经过了机器处理,却不会说是谁想出的。那个让人工智能帮忙改错的学生,会和让人工智能写完整份作业的学生被归到同一类。
再说你的工作。如果你写信、写报告或写文章,你会越来越频繁地借助助手,哪怕只是帮你校对一下,而这些文本都会带上标记。这不会改变它们的质量,今天也没人会因此责怪你。但等到某个客户、出版商或招聘部门决定按这个标准筛选时,它会使用一个你拿不到密钥的工具。
最后还得老实说说截止时间:今天,这对你什么都没改变,我也无法告诉你什么时候会改变。检测器可能几个月后出现,也可能根本不会出现。这就是整个故事的局限,我们提出了一项义务,而让它变得可验证的工具还不存在。
什么会抹掉标记,什么会保留标记
Anthropic 公布了哪些东西会损害它自己的标记,这一点倒是挺诚实。短文本没有足够多的选择,无法撑住标记。一段非常客观的文字、一张购物清单或代码,给模型留下的自由太少,签名无法附着上去。大幅改写、经过另一个模型处理,或彻底重写,都会让它消失。带标记文本的截图也会把它洗掉,因为那已经不是文本了。
而且还有一个涉及全世界所有博客的细节,包括我的博客:图片的元数据,也就是那些存放在文件里而不在图片里的信息,会在第一次格式转换或第一次经过社交网络时蒸发。正因为如此,给文本打标比我们之前捣鼓出来的一切都要扎实得多。没有什么需要擦掉的,也没有什么需要藏起来的,只有换一种方式挑选出来的词。
剩下的就是那个没人公布、却比其他一切都更重要的数字:错误率。多少人写的文本会被错误标记,多少机器写的文本会漏过去?没有这个数字,我们谈的就是一种在这个具体问题上从未被测量过的证明工具。等到有一天某所学校想拿这个来处分一个学生时,这将是他们首先要求查看的文件。
我的问题是,而我没有答案,那就是,对于一份没人能反驳的证据,因为没人能读懂它,我们该怎么办。至于这个博客,一切都合规:每一行都有一个人重新读过并签字,法律白纸黑字写着这一点。我就是没法证明给你看。
加入对话
您必须拥有一个账户才能评论这篇文章。注册免费,耗时不到一分钟。
目前没有评论。