什么是模型工厂,为什么它值60亿美元?
Nvidia 花了60亿美元买下一台它既摸不到,也拍不了照,更不能装上卡车的机器。更妙的是,卖给它这台机器的公司还在每天安安静静地用着它,仿佛什么都没发生。
它叫 Model Factory。模型工厂。它属于 Poolside,一家专门制造代码领域人工智能模型的公司,而这笔交易本身只有三句话:Nvidia 支付60亿美元,获得使用它的权利,雇用109名知道如何让它运转的人,顺带再向公司注资10亿美元。Poolside 保留自己的模型、客户和三位创始人。好了。就这么定了。
不过,这笔交易其实没那么重要。真正值得坐下来花五分钟琢磨的,是这台机器。因为我们整天都在谈这些模型,却从来不问一个模型到底是怎么造出来的,而答案比我们想象的具体得多,也脏得多,还好笑得多。
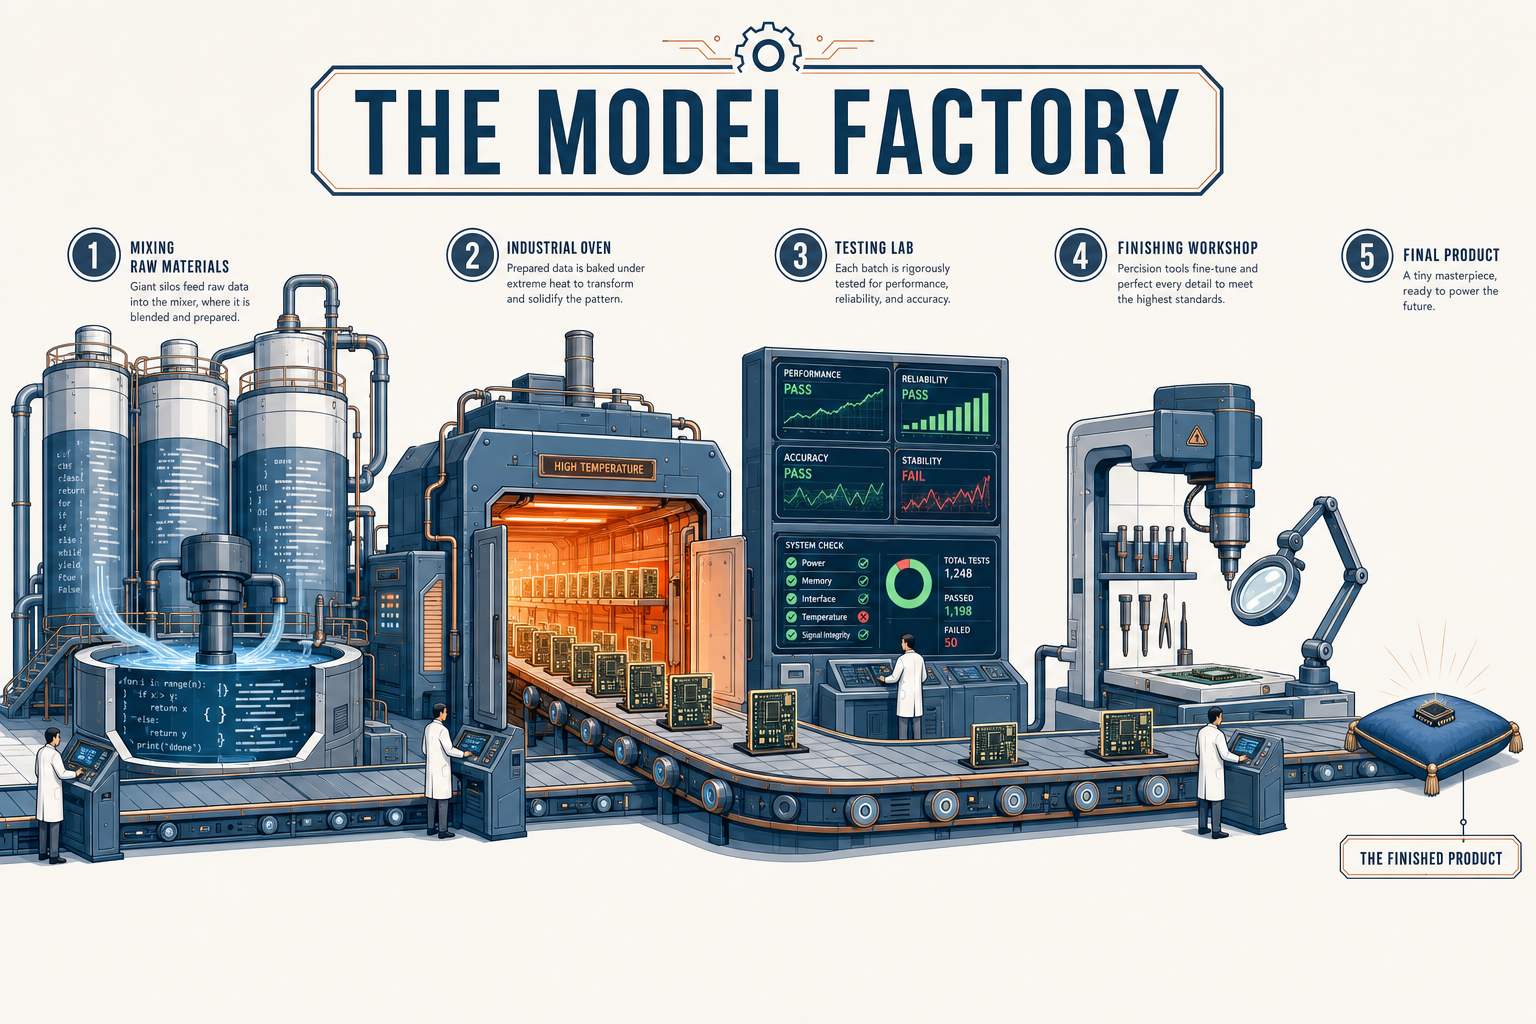
五个工位,一条传送带,而在最尽头,是一个文件。折腾这么多破铜烂铁,最后弄出来的东西却能装在一根 USB 闪存盘上。
首先,它是软件还是真正的机器?
这个问题得马上问,因为“工厂”这个词会让所有人都联想到一个错误的画面。不,它不是像 ASML 那样用来蚀刻芯片的机器,那些家伙要拆成零件装进好几架货运飞机运来,然后还得在现场花上几个月重新组装。
它是软件。几十个彼此交谈的程序。
但如果你就此打住,那你就完全没抓住重点,因为这种软件什么也不能自己完成。它操控着一个机房。一个真正的机房,里面有数万张显卡,几公里长的线缆,一台吼个不停的空调,还有一张以兆瓦计算的电费账单。工厂就是软件加机房加上知道自己在做什么的人。三个缺一个,什么都不剩。
而要理解它为什么这么贵,就得看看一个模型制造出来的时候,机房里到底发生了什么。
两个月里每三个小时就出一次故障
这次我运气不错,因为有一份公开而且具体的资料可供参考:Meta 发布大型模型 Llama 3 时,他们发表了一份技术报告,坦诚地讲述了训练过程是怎么进行的。读完很有启发。
这个模型使用16,384张显卡连续训练了54天。在这段时间里,他们总共记录了466次工作中断。其中47次是计划内的维护。剩下的419次不是。这意味着两个月里不分昼夜,每三个小时就出一次故障。
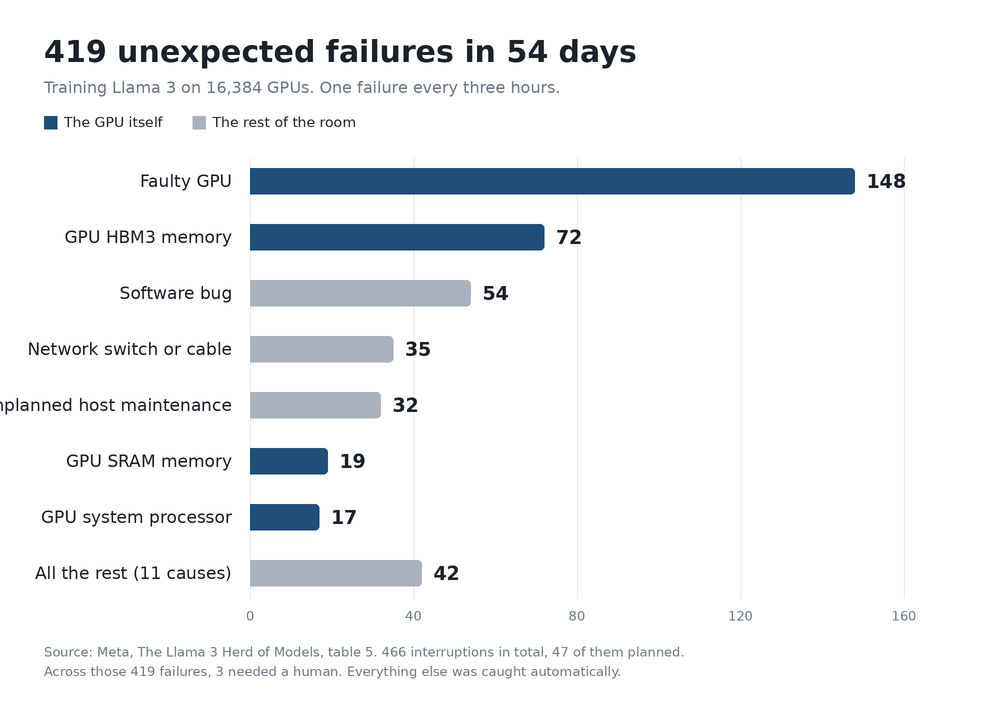
显卡毫无疑问是最容易坏掉的部件。这倒也挺合适,毕竟那里有整整一万六千张。
最糟的还不是这个。最糟的是,这种训练是同步的:一万六千张显卡整齐划一地一起向前推进,而 Meta 白纸黑字地写道,只要有一张显卡坏掉,就可能被迫重新开始全部工作。一万六千张里坏一张。每三个小时一次。
如果你曾经启动过一个要跑六小时的任务,结果在五个半小时的时候崩了,那你肯定很清楚我在说什么。现在,把这件事乘以两个月,再乘以一个由一万六千张显卡组成的机房,而这些显卡在这段时间里一直耗着电。
所以,这就是我从一开始就想给你看的那个数字,而它回答了“这台机器是干什么用的”这个问题。在这419次故障中,有多少次需要人类认真介入?
三次。
三个。其余所有问题都被自动检测、诊断、绕过并补救了,没有吵醒任何人。这就是所谓的模型工厂。正是它让一个在不断损坏的硬件上进行、原本要花两个月的项目,最终还是完成了。没有它,你手里就只有一万六千块非常昂贵的显卡,以及一支整夜重跑脚本的团队。
同一份报告里还有一个额外的彩蛋,因为它实在太妙了:他们发现,机房的产出在一天中段会下降1%到2%,原因非常简单,就是天气更热了,显卡会自动降频。而当数万块显卡同时开始等待时,整栋楼的功耗会一下子跃升几十兆瓦,这会,我引用原文,让当地电网处于极限。这里离软件可远了。
现在,我们打开引擎盖
Poolside在这个行业里做了一件相当罕见的事:他们公开逐个岗位讲述了自己的工厂是怎么构成的。在自己的网站上发布了一系列技术文章。所以接下来的内容不是我重构出来的,这是他们的蓝图。
这条流水线有五个岗位。
岗位1,原材料。 我们从各处收集文本和代码:开放数据集,抓取的网页,按质量和许可证分类的代码仓库,还有专门生成的文本。然后我们进行清理,我两分钟后会再讲这个,因为这是整个工厂里最被低估的岗位。所有这些内容都会由他们称为Blender的自研系统提供给机器,Blender就是混合器,它会实时决定什么东西以什么比例进入这台绞肉机。
岗位2,烹饪。 这个程序会同时把计算分配到所有显卡上,而且还得在我刚才讲的那些事情中幸存下来。他们给它取名叫Titan,在他们自己的文章标题里,他们称它为“工厂的烤炉”。这个比喻不是我编的,是他们的,而且非常准确。
岗位3,试验台。 一个真正执行模型所编写代码的平台。这个值得单独讲一节,马上就到。
岗位4,收尾。 这是把一个原始模型变成可用模型的地方。同样会有专门的一节,因为这正是所有人都在问、却不敢说出来的问题。
岗位5,输出。 一个文件。一个很大的数字文件,但就是一个文件。就为了这个,整座工厂。
为什么一家好的工厂能产出更好的模型
这才是真正的问题,而答案就在Poolside写在自己网站上的一句话里:以前需要花几周编程的实验,现在不到一小时就能跑完。
你得掂量一下这意味着什么。
如今没有人能提前算出什么会造就一个好模型。没有人。我们有直觉、习惯、过去的结果,但确切的配方,代码相对于文本的比例,模型相对于数据量的大小,组织训练的方式,所有这些东西都得靠尝试找到。不是靠思考:靠尝试、测量,然后重新开始。
所以,那个能在邻居尝试三个想法的同时测试一百个想法的人,并不是因为他更聪明才会赢。他会赢,是因为他试了一百件事。这是一场学习速度的竞赛,而工厂决定的就是这个速度。
这也正是为什么我一直觉得追逐最大模型有点蠢,以及我十三天前写过一篇文章,讲的是一个拥有十万亿参数的中国模型,当时我说参数数量是这件事里最不值得关注的数字。参数数量就是排量。你尝试一个新想法的速度,才是车手。
第一次清理:数据
这个岗位最吃力不讨好,但也是回报最大的岗位。
当你抓取网页来喂给模型时,你收集到的不是一座图书馆。你收集到的是一座垃圾场。广告、导航菜单、Cookie横幅、辱骂、整页整页自动生成却毫无意义的内容、损坏的代码、被复制了十五遍的代码、你无权碰的受许可证保护的代码。Poolside在文章里说得非常客气:现有数据集包含数量极其庞大的内容,而这些内容根本没有任何用处,比如广告。
所以他们会分好几轮进行过滤。首先是粗筛,用砍刀来做:辱骂、仇恨、广告。接下来是更细的筛选,根据文档的特征进行。然后,事情开始变得有意思了,他们会自动按主题将文档分组,如果模型明显很难从某些文档中学到任何东西,他们就会把整批整批的文档扔掉。
公布的结果:测试平均提升约 5%,某些测试最高提升 150%。
百分之一百五十。无需动模型,无需增加一张显卡,无需改动算法中的一行代码。只是把交给它阅读的东西清理干净。
这就是那种每个开发者在另一个领域都背得滚瓜烂熟的道理。你可以花三天优化代码,如果你的数据库里塞满了糟糕的重复数据,你就是在浪费时间。输入糟糕,输出糟糕。这条规则从打孔卡时代起就没变过,只是现在忽视它的代价高得多了。
我觉得整个工厂里最聪明的工位
Poolside 做的是代码模型。而对于代码模型来说,有一个其他领域没有的裁判:机器。
模型写诗的时候,没人能客观地说它写得好不好。它写函数的时候,可以。你运行它。它要么编译成功,要么编译失败。测试要么通过,要么不通过。没有争论,没有意见,没有主观评分:它能工作,或者不能工作。
所以他们搭建了一个规模非常大的平台,做的正是这件事。模型提出代码,机器真的执行代码,测试做出裁决,结果以分数的形式返回给模型。做得好,你再来一次。失败了,你就改。
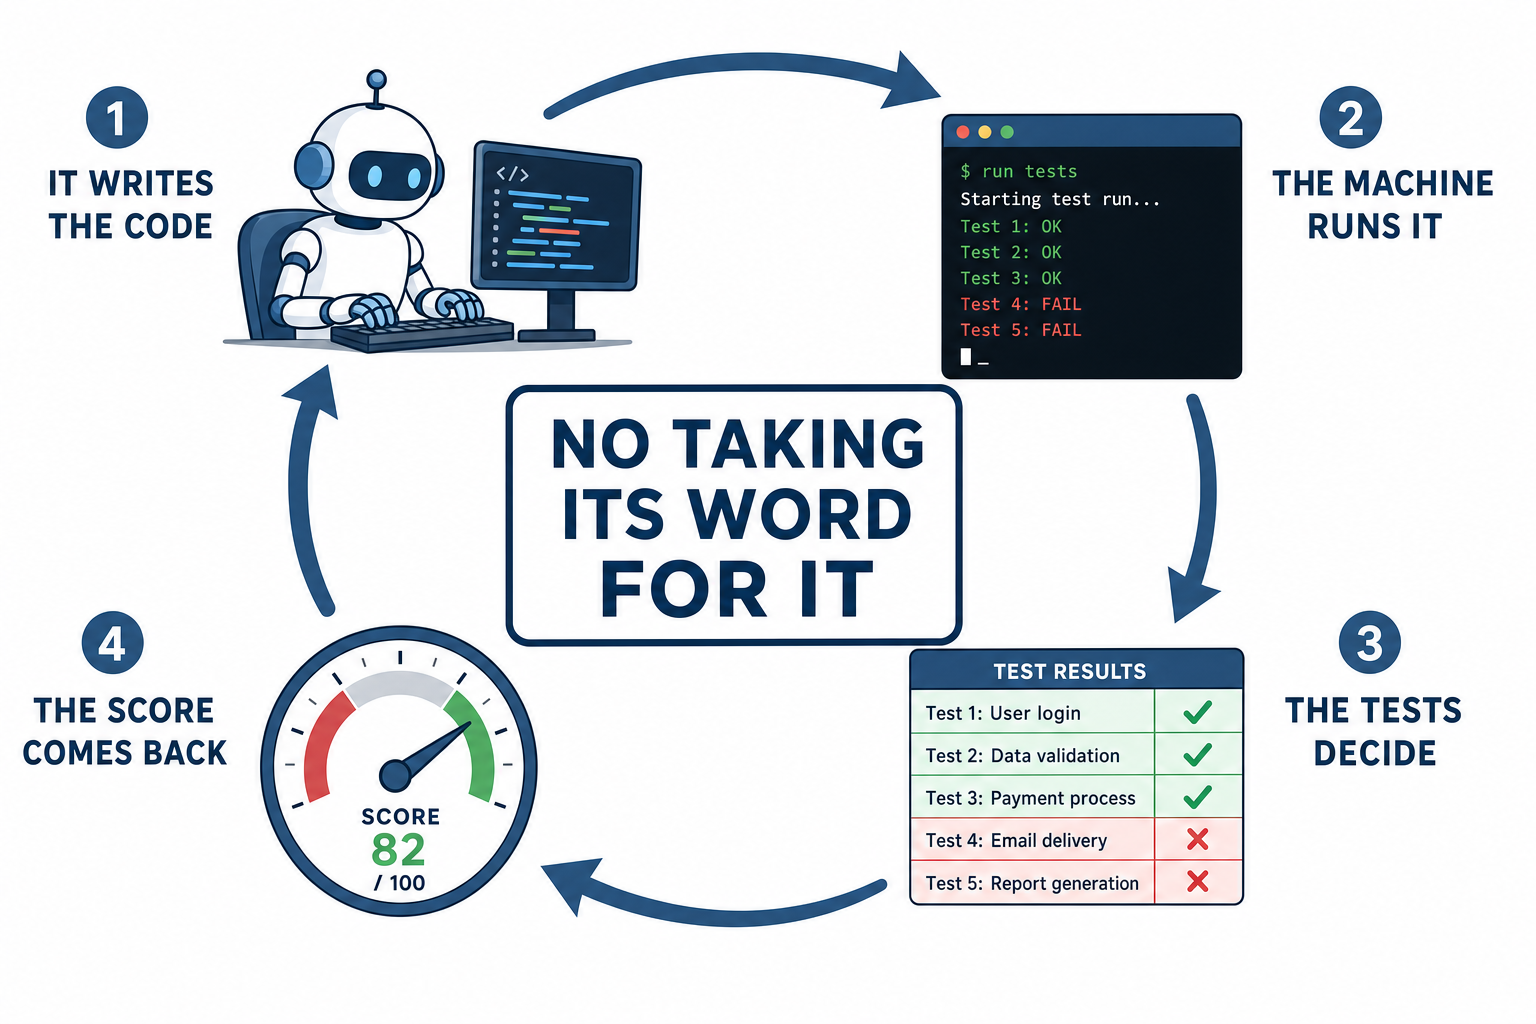
唯一不容争辩的分数。编译器可不会客气。
这个循环一直不停地运行着,从来不会停下来。模型学到的不是写出看起来正确的代码,而是写出能通过的代码。这个区别非常巨大,而恰恰正是在这里,一个能给你弄出某种看似合理东西的助手,和一个能给你弄出真正能运行的东西的助手之间的差别就产生了。
要构建这个系统,就得能够持续并行地执行未知的、可能有危险的代码,同时不能让它把你的基础设施烧起来。这可不是什么小工程。甚至在我看来,这是整套东西里最值钱的部分。
第二次清理:模型本身
我们很少问的第二个问题:为什么一定要把模型做完才能发布?它已经训练好了,什么都读过了,应该能工作了吧?
不。解释几乎滑稽得可笑。
刚出炉的东西,也就是我们所说的基础模型,知道多得惊人,却什么都不会做。Poolside 说得非常好:基础模型博学,但不擅长解决问题。因为教给它的并不是如何回答。而是如何继续下去。
于是你给它写“怎么给一个列表排序?”,它非常认真地回答你“怎么给一个数组排序?怎么给一个文件排序?怎么给……”。它不是在嘲笑你。它看过数十亿个网页,明白现实生活中一个问题后面往往还会跟着其他问题,而它做的正是训练它时要求它做的事:接着往下写。
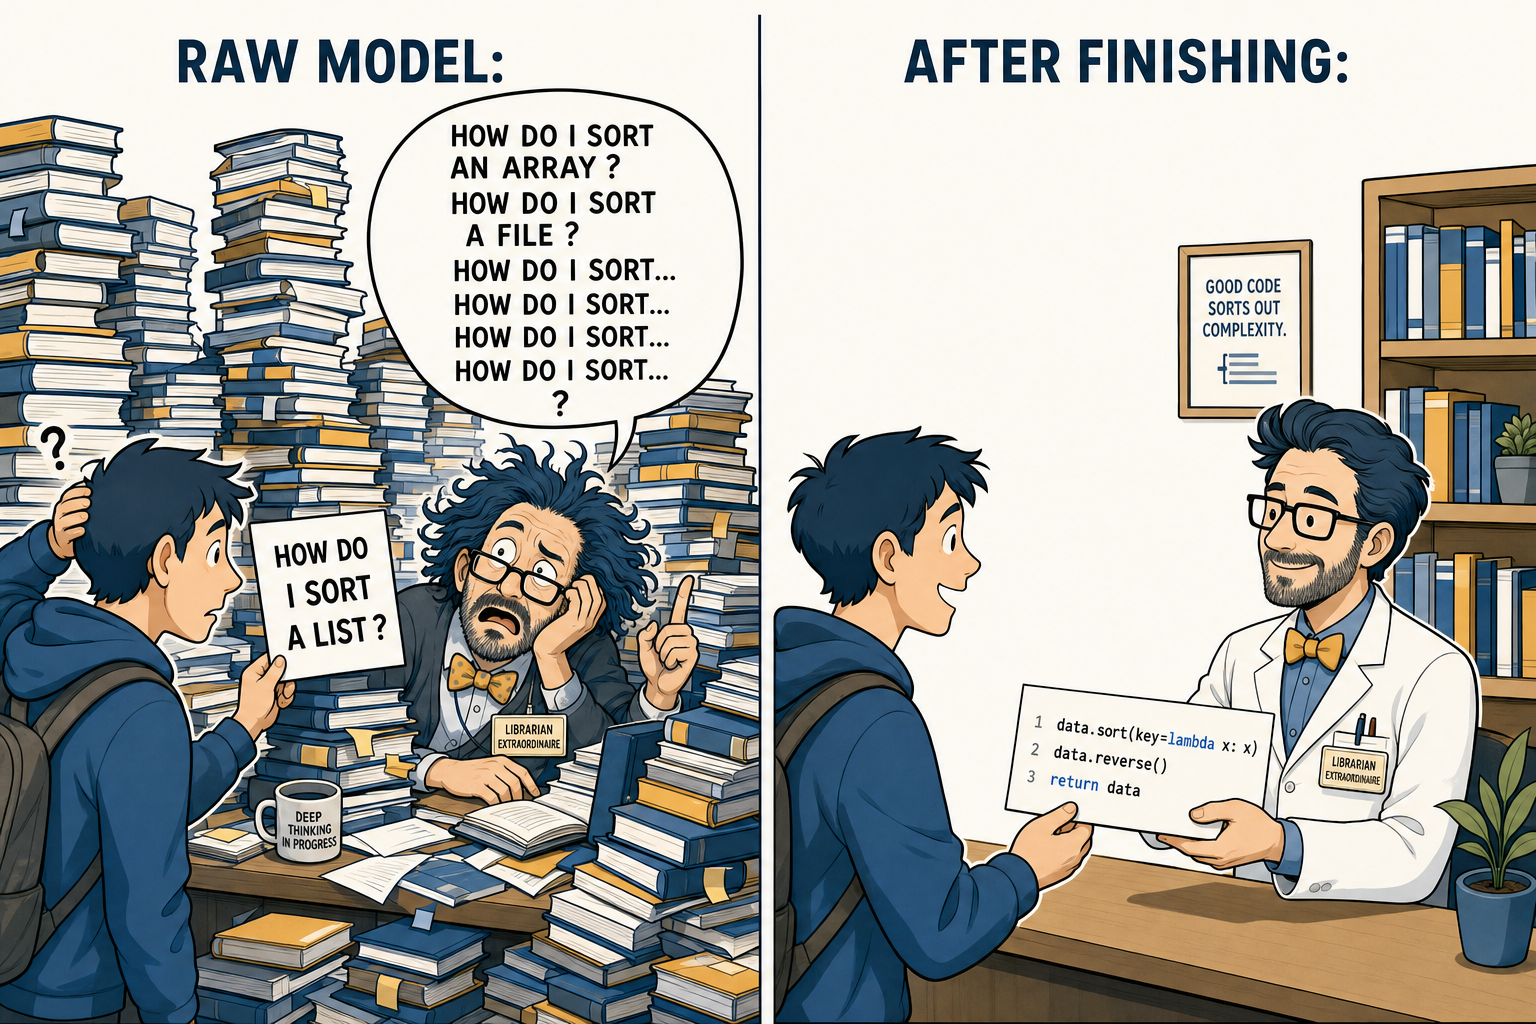
左边那个什么都读过。真的什么都读过。它只是没法为你做任何事。
收尾工位就是干这个的。首先给它看成千上万个正确行为的例子:有人提出问题,有人给出答案,然后停下。这就是让它拥有可预测行为的东西,顺带也是人们所谓的性格。然后就轮到重炮上场了,也就是 3 号工位的循环,那个负责执行和评分的循环,用来教它坚持进行长篇推理,不要在复杂问题做到一半时放弃。
第一遍是给第二遍做热启动。先手动粗略处理一遍,然后在执行时再细化。最后,你得到的是一件可以交给人类,而不至于让他用奇怪眼神看你的东西。
那为什么是 Nvidia?他们在准备自己的模型吗?
这是自然会冒出来的问题,答案可能会让你有点意外:他们不是在准备,而是已经在推出了。
Nvidia 已经发布一个叫 Nemotron 的开放模型家族有一段时间了,一共有三种规模,而且他们不只是给出最终文件:还会发布用来制造它的数据集和方法。他们甚至还和其他参与者组建了一个联盟,公开构建高水平模型。所以,“Nvidia 会不会做自己的模型”这个争论,早就已经有结论了。他们缺的不是意愿,而是速度。
还有一个更实际的原因。Nvidia 卖的是显卡。几乎所有显卡。一套真正知道如何利用这些显卡的工具链,让它们全速运行而不是闲着等待,自己处理故障,这会机械性地提高每张售出显卡的价值。他们把自己的数据中心称作 AI 工厂,已经叫了好多年。他们刚刚买了一座工厂。这很合乎逻辑,这一点得承认。
第三点更不显眼。这既不是收购,也不是挖人,写给投资者的信特意把这一点白纸黑字地写了出来,因为收购要经过竞争监管机构的审查,可能在那里卡上几个月,而许可证加招聘就快得多。这既不新鲜,也不违法,只是已经变成这个行业大型交易的惯常形式。
故事的另一面,明显没那么光彩
因为你可能会问,一家刚刚造出一台价值六十亿美元的机器的公司,为什么会同意把它授权出去,还让制造并运行这台机器的团队离开。
答案很残酷,而且是他们的联合创始人亲口说的。他们有六周时间筹集二十亿美元,用来支付一组 40,000 张显卡,这组显卡原定于一月启动。他们没能及时完成融资。他们失去了这整组显卡。
就是这样。他们有配方,有团队,有工厂,却没有烤箱了。
同一位联合创始人还补充说,当下的限制不只是钱,还有数据中心里的物理空间,以及已经预留的算力。换句话说:就算支票到手,也得有人已经把大楼建好。他还说明,构建这个模型的人不到 70 个,把全部工程和研究人员算在内也不到 115 个。
仔细看看这个数字,再看看 Nvidia 招聘的 109 个人。这几乎就是整个团队。这印证了我一开始说的话:没有那些知道如何运行这座工厂的人,这座工厂就不存在。买不到一本手册,能买到的是一种活在一百多个脑袋里的能力。
好,那你呢?
得诚实一点:今天,什么都没有。你永远看不到这台机器,也永远不会使用它,它不会改变你明天的生活。
但这里有两个非常实际的后果,第一个算是个好消息。
你可以下载并在家里运行的免费模型,正是从这种工厂里出来的。Poolside 的代码模型采用开放权重,也就是说,最终文件是公开的,可以安装到你的机器上。Meta 十一天前也做了同样的事,发布了一个可以在玩家显卡上运行的模型。这些制造链条的每一次进步,都会在几个月后变成一个文件,你可以把它放到自己的硬盘上,不需要账号,不需要订阅,也不用把你工作中的一行代码发给任何人。对于合同代码,或者只是你不想让它离开自己手里的代码来说,这可不是小事。
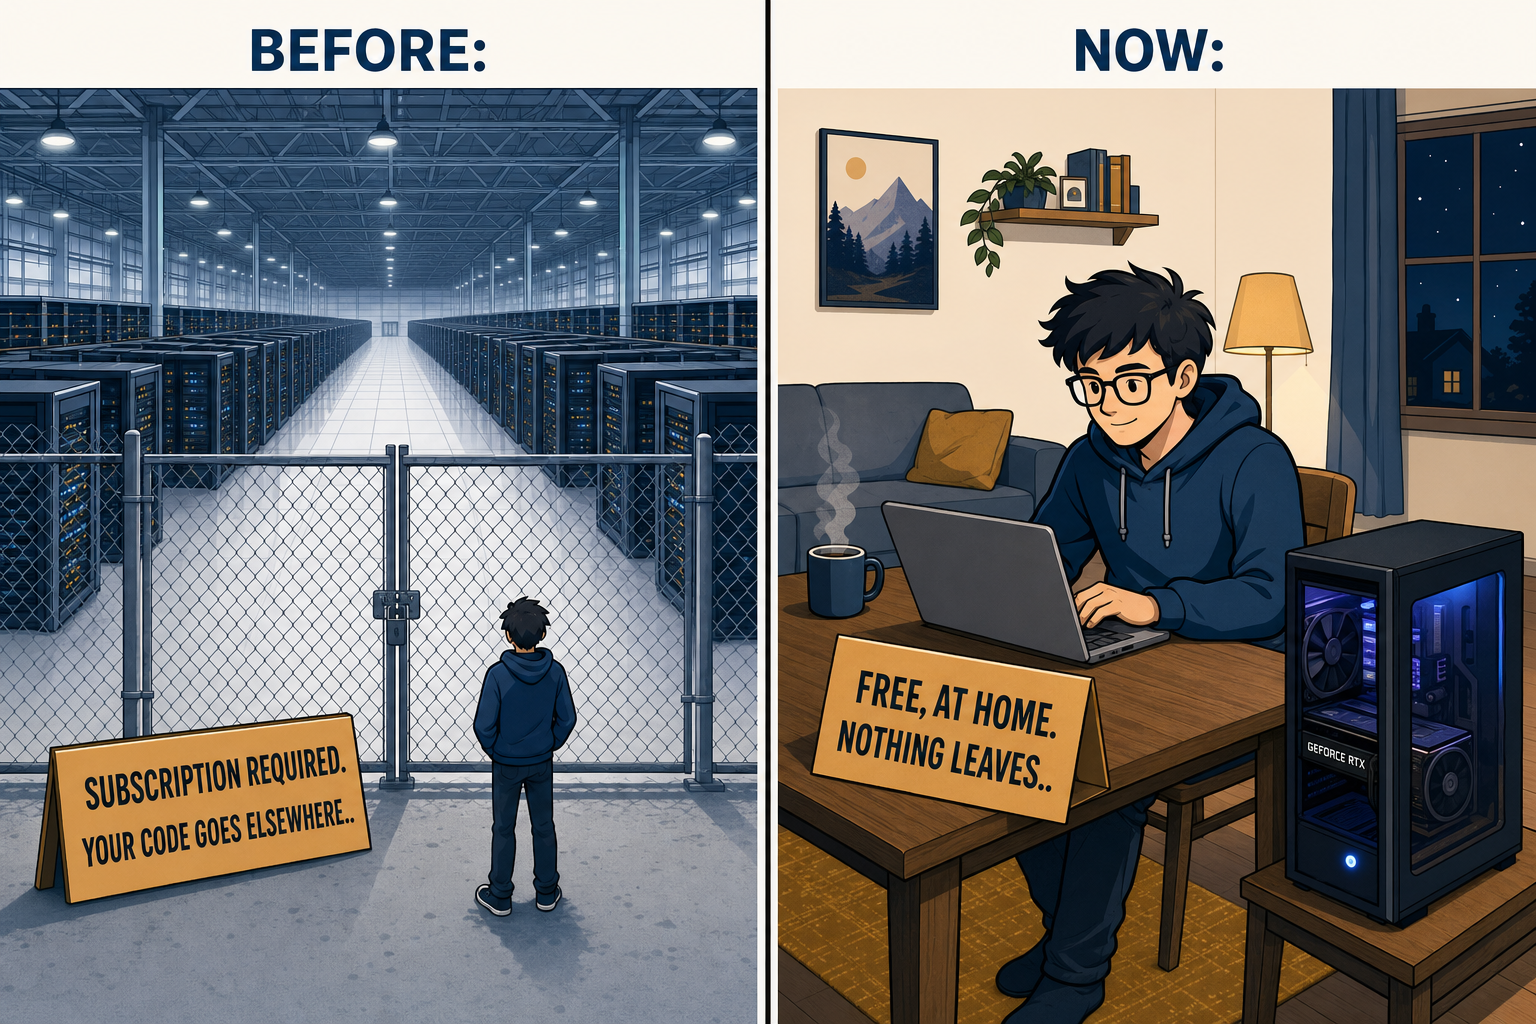
机棚要花二十亿美元。里面出来的东西最后会出现在你的桌面上,而且是免费的。找找看问题出在哪儿。
第二个后果就没那么令人高兴了。如果价值如今在工厂里,而一座工厂要价六十亿美元,那么很快,能容纳一座工厂的公司就屈指可数了。Poolside拥有可能最好的团队,却因为银行日程问题被淘汰了。这就说明了入场券有多贵。
至于这一切什么时候会体现在你的日常生活里:其实已经是这样了。那个帮你补全句子的助手,那个替你整理照片的助手,那个你打电话给客服时回答你的助手,它们全都出自这样的一条生产线。你只是从来没见过车间。
需要谨慎看待的地方
这些金额来自Newcomer通讯披露的一封投资者信,而不是提交给监管机构的文件。Bloomberg、The Next Web和The Decoder都确认了六十亿美元这个数字,但一篇转载的报道曾说是六亿美元:我采用三个来源相互印证的数字,也告诉你这个数字是从哪里来的。
其次,没有人公布过这份许可证确切涵盖的内容清单。Poolside公开介绍过自己的工厂,这已经很不寻常了,但一篇技术博客文章和一份合同清单之间还有很大的距离。我们知道Nvidia支付了什么。我们不知道它究竟得到了什么。
最后,我给你展示的故障数字来自Meta,涉及的是Llama 3的训练,不是Poolside的训练。这些是这个行业的大致数量级,不是这座工厂本身的测量结果。Poolside没有公布自己的数字。
我的看法
我喜欢这个故事的地方,在于它把事情重新摆回了正确的位置。三年来,人们一直像卖汽车那样卖模型,有排名,有响亮的名字,还有不断上升的曲线。而事实证明,真正的价值在后面,在车间里,在凌晨三点因为一块卡挂掉而重启任务的脚本里,在丢掉广告的过滤器里,在执行代码而不是盲目相信代码的平台里。
这是每个开发者最终都会吃亏学到的一课。一个项目的价值从来不在交付物里,而在于重新做出它的能力。丢掉你的编译链,你就什么都没有了,即使二进制文件还握在手里。
还有一件事我觉得确实挺美的。这么铺张的资源,这个仓库那么大的房间,这一万六千张每三小时就会有卡故障的卡,这些过滤器,这些测试,这数百万次执行,最后全都只是为了得到一个文件,然后有人会免费下载它,在自己客厅里亲手组装的那台塔式机上运行它。
所以,如果你属于那种下载这些模型并在家里运行的人,要知道你是这条价值二十亿美元的链条末端。好好享受吧,也偶尔想想那三个半夜爬起来的人!
来源
- Poolside : The Model Factory,作者对平台的介绍
- Poolside : Gathering and processing raw materials for the Model Factory,数据清理和测得的收益
- Poolside : The finishing touches,后训练所做的事情
- Meta : The Llama 3 Herd of Models,第3.3.4节和表5,466次中断和3次人工干预
- Newcomer : Poolside Strikes 6 Billion Licensing Deal with Nvidia,投资者信,2026年8月21日
- The Decoder : Nvidia is acquiring Poolside's Model Factory and 109 employees
- Latent Space,Eiso Kant关于丢失的集群和团队规模的说法
- Nvidia : Nemotron Labs, How Open Models Give Enterprises and Nations AI They Can Trust
Join the conversation
You need an account to comment on this article. Creating one is free and takes under a minute.
No comments yet.