7500亿个参数免费下载,但你需要十六张显卡
7月31日,LG AI Research在Hugging Face上发布了一个拥有7500亿个参数的模型,采用Apache 2.0许可证。说白了,任何人都可以下载、使用、修改和出售它,不需要获得许可。
没错,是LG。那个生产冰箱和电视的厂商。在我们看向别处的时候,这家集团的研究部门发布了有史以来上线的最大规模开放模型之一。还有一个很有意思的小细节:你没法让它跑起来。
盒子里有什么
它的完整名称是K-EXAONE 2.0。我们先从参数说起,因为所有人都在数参数,却从来没人解释它们是什么。参数就是模型内部的设置,也就是它在训练过程中学到的数值。参数越多,它能记住的东西就越多。让它运行起来也就越贵。
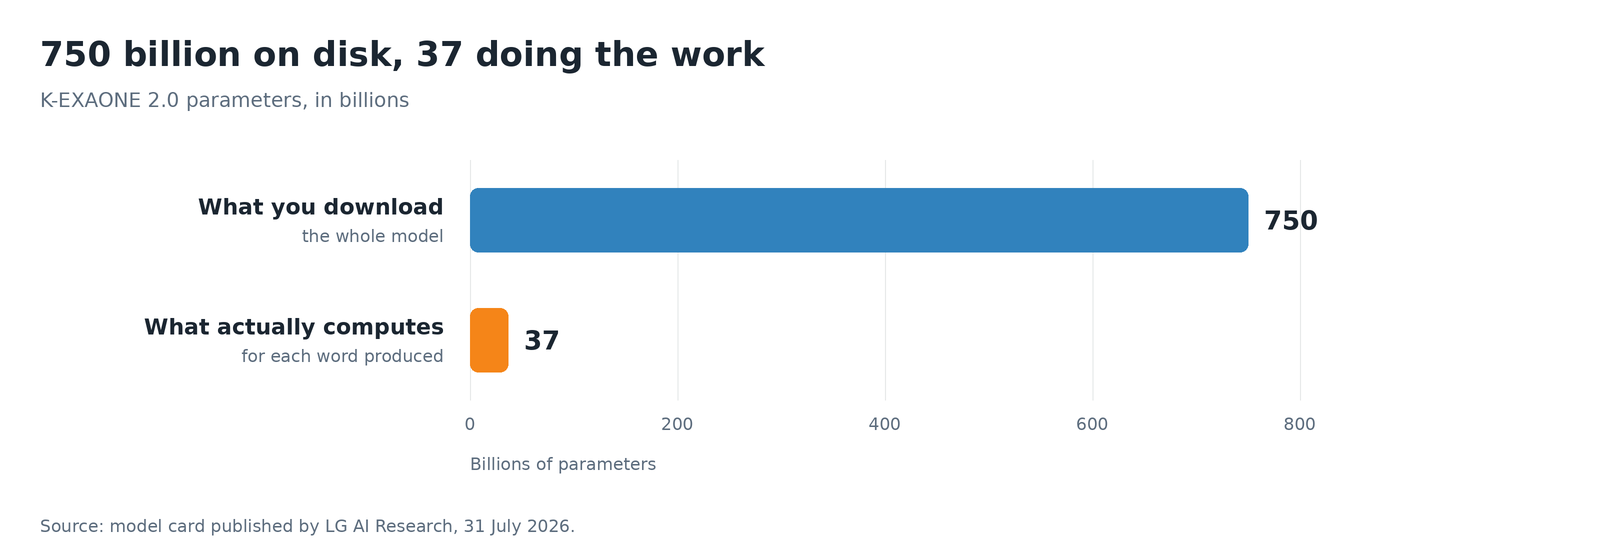
你下载的是整座图书馆。每个词只打开两个书架。
有意思的地方就在这里。在这7500亿个参数中,每生成一个词时,只有370亿个在工作。模型包含256个专家,以及一个始终处于活动状态的通才。对于每一段文本,它只会调用八个专家。这就叫专家架构。这个系统可以让一个巨型模型不必每时每刻都使用全部算力,从而限制运行成本。
想深入了解这个话题,在搜索引擎里要输入的准确术语是expert。它指的是专家混合,英语是mixture of experts,缩写为MoE。在这篇文章里,我使用“专员”这个词,因为它更容易理解。但在技术说明中,它确实叫作专家。
注意这个容易混淆的词,很多人都会搞错:专家不是智能体。它是模型内部的一部分,是众多设置中的一组。它什么都不会决定,不会调用任何工具,也不知道自己的存在。你永远看不到它。对于每个词,一个分流器会选择八个被激活的专家。它们的作用到此为止。
智能体运行在另一个层面。它是一个完整的模型,被赋予一个目标和一些工具。然后它可以自行连续执行操作来实现这个目标:打开文件、运行命令或发送消息。专家留在模型内部,不会对任何东西采取行动。智能体则在外部,也就是你的电脑上采取行动。一个拥有256个专家的模型完全可以作为智能体的引擎,但这是两个不同的层级。
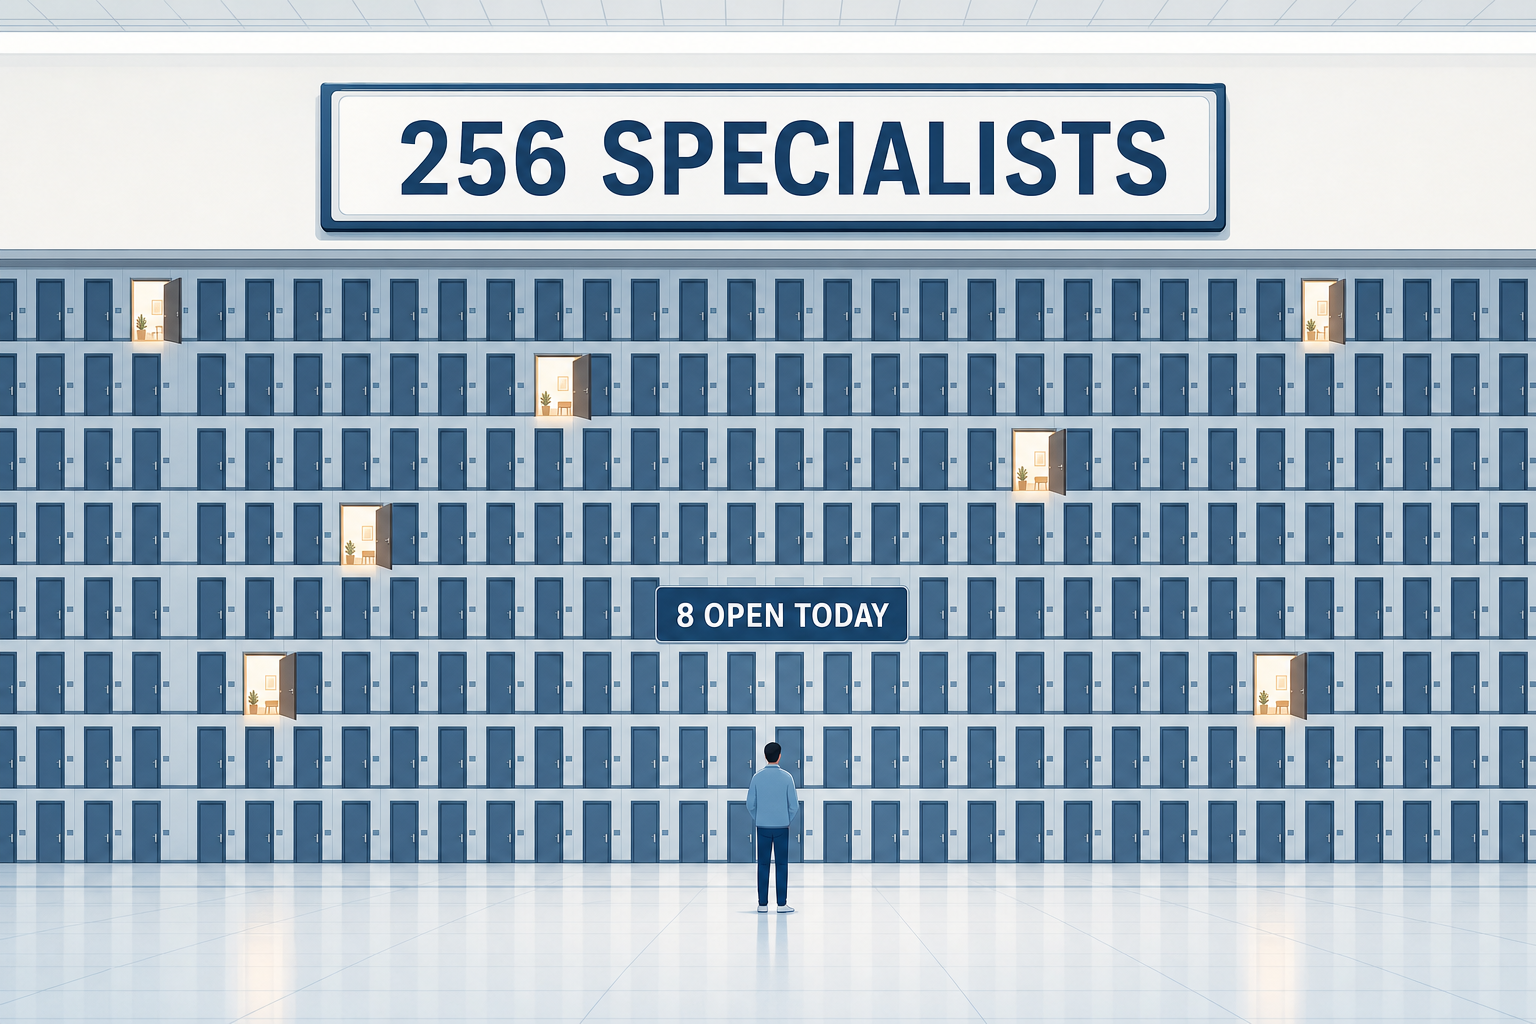
两百五十六名签约专员,八名值班。医院做梦都想要这样的安排。
除此之外,K-EXAONE 2.0支持262 144个上下文标记。标记就是模型处理的那些小段文本。在这里,这意味着它可以一口气吞下整整一本大书。官方支持十种语言,其中包括法语。这种模型并不经常支持这么多语言。
分数,以及它们真正说明了什么
LG宣布,它在测试中的平均分是70,1,而上一版是63,3。具体来说,模型在MMLU-Pro上得到83,5分,这是一个测试常识和推理能力的测试,在AIME 2026的数学题上得到92,3分,在一项长时记忆测试上得到94,4分。这些成绩非常好。这一点没什么可争的。
真正让开发者感兴趣的测试叫作SWE-bench Verified。我们给模型一个真实项目中的真实漏洞,同时提供一张由人类撰写的工单。然后检查它生成的修复是否能通过测试。没有选择题。没有客客气气的猜谜。
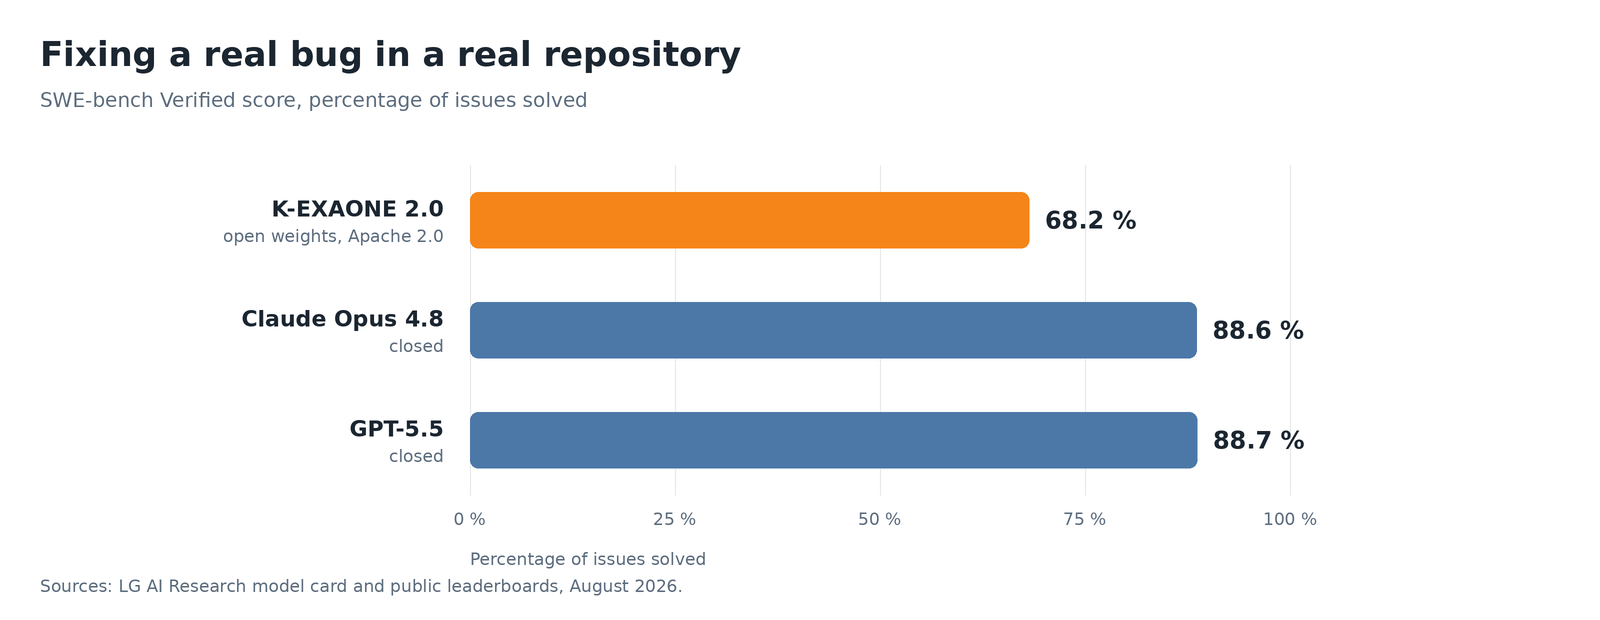
相差二十分。目前最大的开放模型不是最好的,但这没关系。
结果是:68,2%。这个成绩还算体面,但比最好的闭源模型低二十分,后者大约在88分左右。一百个漏洞里,K-EXAONE 2.0因此会少修好大约二十个。如果你想找市场上最好的代码助手,那不是它。
这个测试也开始难以区分最好的模型了。它们全都集中在88分左右。研究人员已经在使用更难的测试来区分它们。当所有人的表现几乎一样好时,这个基准测试就测不出什么东西了。
问题在于包裹的重量
这就是自由软件的承诺遇上你客厅现实的时刻。
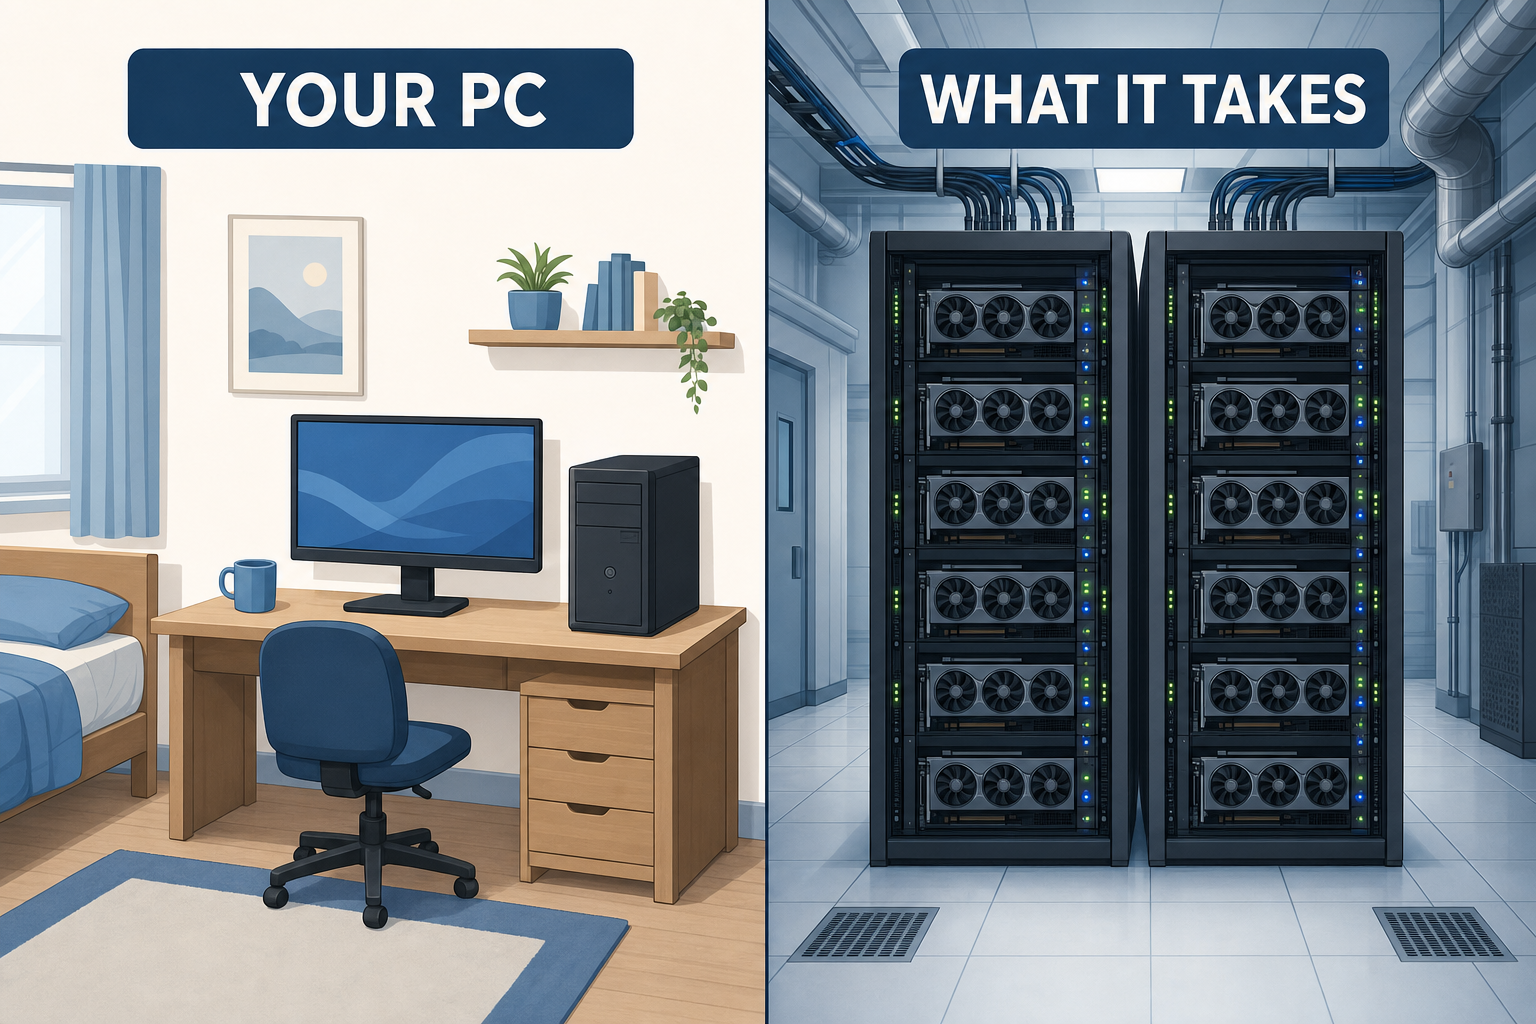
左边,是你拥有的东西。右边,是你需要的东西。差价大概相当于一栋房子的价格。
官方资料建议使用两个节点,每个节点配备八张 NVIDIA H200。这就是十六张专业显卡和大约2.2 TB的视频内存,全部放在一间装有空调的房间里。光是下载就要大约1.5 TB的文件。每个参数占两个字节,而这个模型有7500亿个参数。
拿它来比较,面向玩家的高端显卡内存是以几十GB计算的,不是几千GB。光是希望把模型加载进去,就得需要几十张显卡。而且这些显卡也无法像推荐的硬件那样协同工作。我们已经不属于“我有一台不错的电脑”这个类别了。我们属于“我有一间服务器机房”这个类别。
那么,如果你无法在家里安装模型,发布自由模型又有什么用呢?恰恰是有很多用处。但它不能把你的书房变成AI实验室。
Apache 2.0,真正的关键就在这里
Apache 2.0许可证非常宽松。它不禁止商业用途。它没有规定用户数量上限,超过这个上限就得去找销售人员。它也不会强迫你公开用这个模型构建的东西。你拿去,用起来,卖掉。
很多被称为“开放”的模型都没有走到这一步。有些禁止竞争。另一些规定,超过一定用户数量后就必须使用付费许可证。还有一些把使用权限制在研究领域。这里,这些限制全都没有。
文件一旦发布并被下载,就没人能收回已经被下载的副本。人们严重低估了这一特性。三天前,我还在解释OpenAI如何断开了它某个语音模型的旧版本。顺带一提,这家公司还弄坏了那些依赖这个版本的人的代码。有了开放权重,这种情况就不存在了。供应商可以破产,可以改变主意,也可以把价格提高三倍。你的文件还在你的硬盘上,十年后仍然可以完全以同样的方式继续运行。
还有一个说明一切进展有多快的迹象:一个同等规模的第二个模型,名为 A.X K2,在这个模型发布仅仅两天后就宣布了。48小时内出现了两个开放的巨兽。
具体来说,这对你有什么改变
你永远不会下载这个文件。你家里也没人会这么做。然而,有三个非常具体的理由值得为这个消息高兴。
1. 它真的会把价格往下拉
当一个免费且没有商业限制的模型达到一定水平时,想要靠提供同样的东西收取高价就变得很难了。付费模型必须靠自己做得更好来证明价格合理,而不是靠它们单纯存在来证明。上周我们就看到了这一点,OpenAI在它的小模型发布三周后,把价格降到了原来的五分之一。每当一个自由模型提升一个档次,某个地方就会有一行账单降下来。
2. 它能让AI在你的数据必须留在原地的地方工作
医院、律师事务所、政府部门或会计部门并不总能把自己的文件发送给外国服务商。使用封闭模型时,讨论可能就到此为止了。有了开放权重,这些组织就可以在自己的地方安装这台机器。数据不会离开这栋楼。这样一来,你的病历就真的有机会由这种模型在医院地下室里处理,而不是完全得不到处理。
3. 这正是Linux的故事
你家里没人曾经在某个周日下午编译过Linux内核。然而,Linux驱动着你的网络盒子、电视机、如果你使用Android的话还包括你的手机,以及你访问的绝大多数网站。自由软件从来不需要落到你的桌面上才能改变你的生活。它只需要在背后到处工作。
开放模型也在走同一条路。两年后,很可能会有一个开放模型在你的银行应用、市政府服务终端或运营商客服服务背后运行。这个词永远不会出现在屏幕上。老实说:你根本看不出来。而这恰恰会是它运行良好的标志。
我的看法
让我感到震撼的,不是模型的规模。而是发布它的公司。我们花了两年时间盯着三家美国实验室和两家中国实验室。结果,首尔那个卖洗衣机的厂商把7500亿个参数免费放到了桌面上,采用Apache 2.0许可证。
这个模型不是最好的,它也没说自己是最好的。但一个开源模型不需要取胜。它只需要足够好,好到让第一名的价格显得不体面。这正是数据库、Web 服务器和操作系统所发生的事情。我看不出有什么理由能让 AI 逃脱这种规律。
就我个人而言,这次发布中最让我高兴的,是三个字符:2.0。我说的不是版本,而是许可证。Apache 2.0,这是这次发布中唯一没人能收回的部分。
Join the conversation
You need an account to comment on this article. Creating one is free and takes under a minute.
No comments yet.