OpenAI 推出两个新的转录模型:真的有必要迁移吗?
七月底,OpenAI 给开发者发了一封邮件,宣布推出两个新的转录模型,也就是两个把语音转换成文字的引擎。gpt-transcribe处理已经录好的文件。gpt-live-transcribe负责实时转录。配合公告发布的演示着实够大胆:在介绍视频里,一个人一边弹吉他一边唱歌,文字却正确地显示在屏幕上。他自己的吉他在他耳边大吼,机器居然还是跟上了。
如果你已经在项目里使用whisper-1,真正的问题就不是演示是否令人印象深刻。你想知道的是自己是否应该迁移。我看了性能、价格,尤其是迁移过程中会消失的功能。奇怪的是,邮件对这一部分说得少得多。
两个模型,因为有两种工作
人们经常把文件转录和实时对话转录混为一谈。不过,它们并不是同一种用途。
gpt-transcribe处理的是已经结束的文件。你把一段录音发给它,它把文字返回给你。这种模式适合播客、会议记录、语音备忘录或需要加字幕的视频。它处理音频的速度大约是实际速度的34倍。一小时的录音因此不到两分钟就能转录完。
gpt-live-transcribe的工作方式不同。它会保持连接打开,随着说话者开口逐块返回文字。这就是为实时字幕或语音助手准备的模型。你还可以通过五档设置在速度和准确度之间进行选择,从minimal到xhigh。你等得越久,模型掌握的上下文就越多,出错也就越少。
这是两个端点,也就是 API 中两个不同的访问点。第二个的价格是第一个的四倍。所以,不,我们不会为了以防万一就选择实时模式。
数字,以及它们没有告诉你的东西
OpenAI 在自己的测试基准上公布结果,这个基准名为 Real World Audio Benchmark。使用的指标是词错误率。换句话说,就是机器错误写出的词所占的百分比。
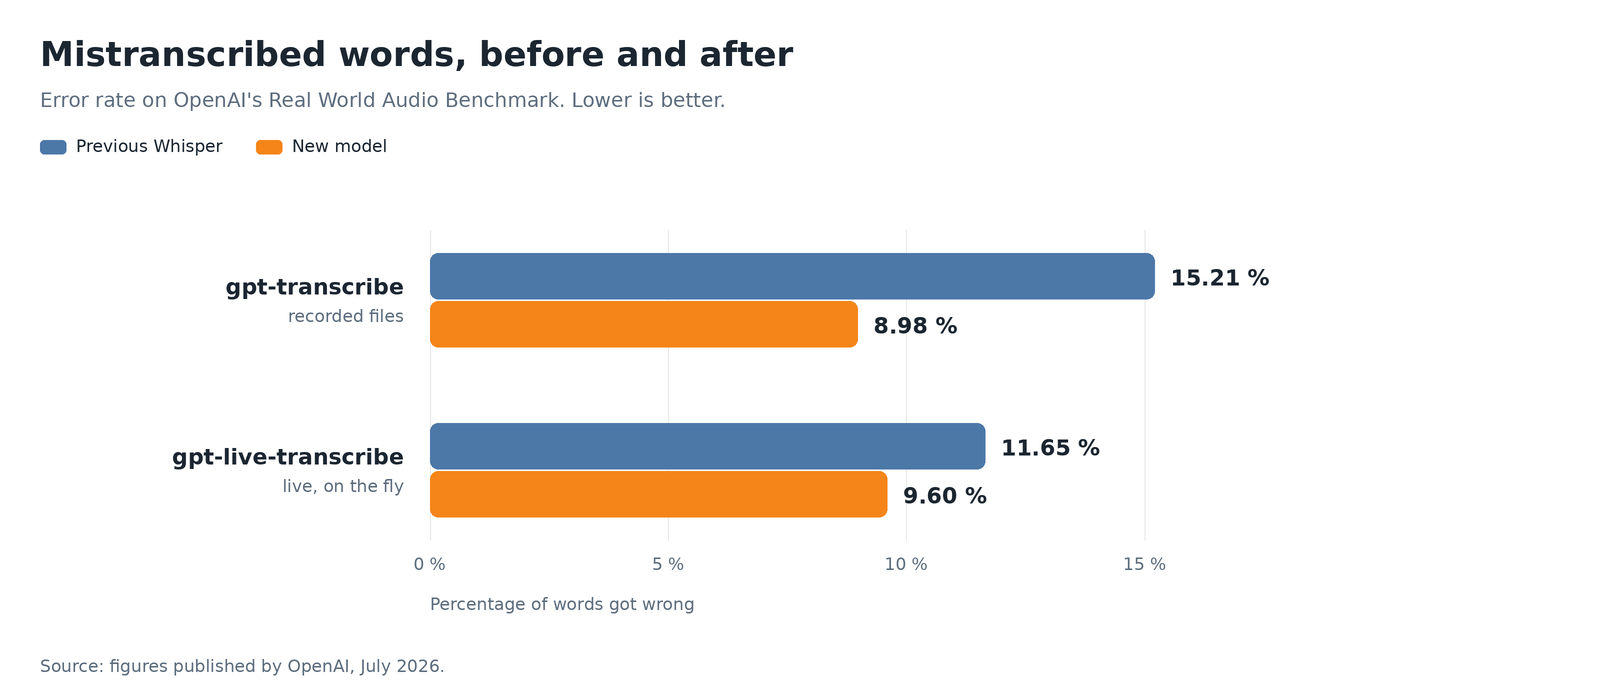
文件模式的错误几乎少了一半。至于实时模式,它主要赢得了一个可以说自己进步了的资格。
在另一个基于 Common Voice 的22种语言语音的测试基准上,差距更加明显。旧版 Whisper 会把40.37%的词弄错。新版降到了19.27%。所以,在完全相同的音频上,它犯的错误还不到原来的一半。
现在来点冷水。只会重复卖家数字的文章毫无用处。在 The Decoder 转述的一项独立排名中,gpt-transcribe 排名第四。它的错误率达到 3.31%,而 ElevenLabs 的 Scribe v2 为 2.3%,Gemini 3 Pro 为 2.9%,Mistral 的 Voxtral Small 为 3.0%。OpenAI 有进步。OpenAI 没有赢。
最后一个注意事项,也是最有用的一个:这些百分比是在干净音频上得到的平均值。遇到真正困难的企业录音,比如多人电话会议,错误率最高可能达到 43.8%。没有哪个模型能救回糟糕的麦克风。一个 60 欧元的好麦克风,总是比更换模型更能改善你的转录效果。
价格,这是个好消息
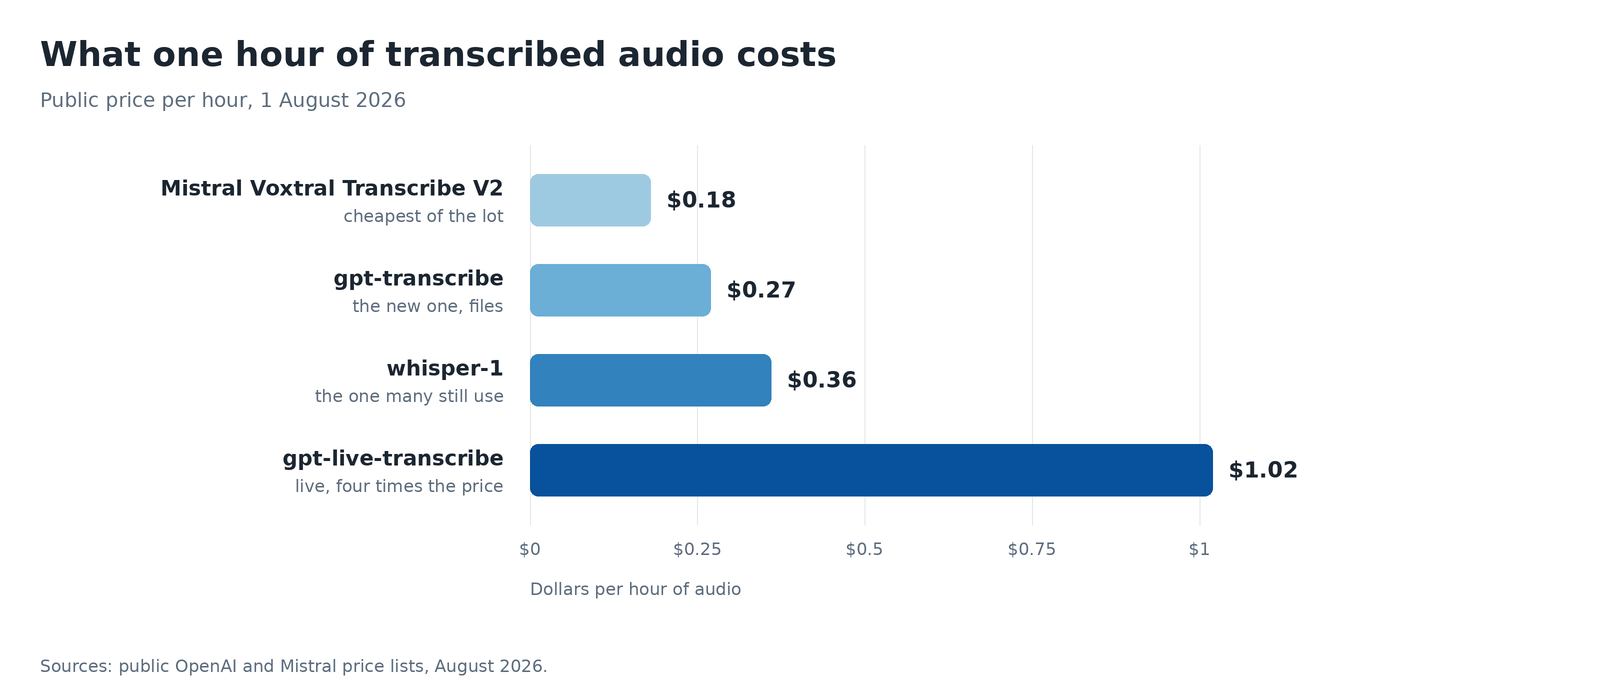
这一次,更新的东西也更便宜。好好利用吧,这种事可不是每天都有。
用 whisper-1 转录一小时音频需要 36 美分,而新模型只需 27 美分。这便宜了 25%,效果却明显更好,在这个行业里依然相当少见。实时模式每小时要 1.02 美元,几乎是文件模式价格的四倍。这个价格下,一场两小时的实时字幕会议,价格相当于一杯咖啡。
你真正得到的东西:终于可以给模型做简报了
价格下降当然不错,但主要变化在别处。现在,在模型听录音之前,你可以先给它提供上下文。
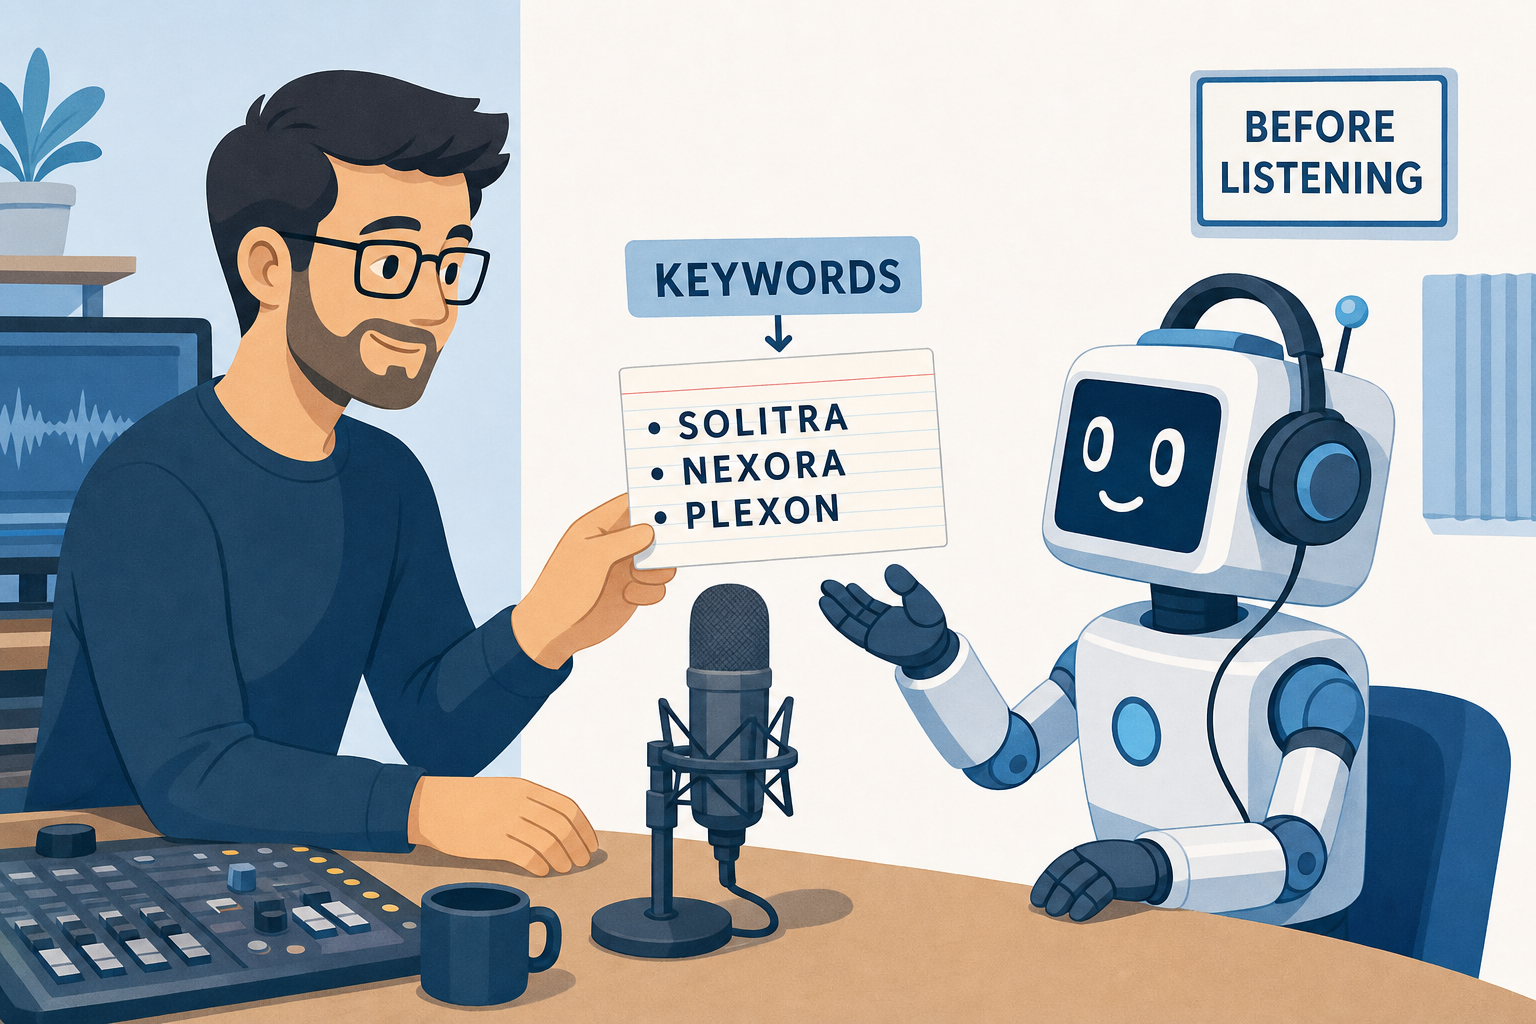
模型从来没听过你的产品名称。现在,你可以提前告诉它,而不是事后全部修改。
三个参数可以用来引导它。prompt 用一句自由描述来说明情境。keywords 包含机器无法自行猜出的词:专有名称、产品编号、缩略词或行业术语。languages 指明预期使用的语言。这样可以避免一句英语插入法语会议中间后,场面彻底失控。
from openai import OpenAI
client = OpenAI()

with open("reunion.mp3", "rb") as audio:
    result = client.audio.transcriptions.create(
        model="gpt-transcribe",
        file=audio,
        response_format="json",
        prompt="Reunion technique sur un logiciel de facturation.",
        extra_body={
            "keywords": ["Digital3D", "AC-42", "PostgreSQL"],
            "languages": ["fr", "en"],
        },
    )
print(result.text)
如果你已经花了好几个晚上去纠正同一个专有名词,而它每次出现都会被 Whisper 糟蹋一遍,你就明白为什么这一段是整篇文章最重要的部分了。还有两个细节需要知道。每个关键词都必须占据单独一行,并且不能包含字符 < 和 >。也不能同时发送旧的单数参数 language 和新的复数参数 languages。
离开 whisper-1 后你会失去什么
这就是 OpenAI 的邮件小心翼翼地忘记提到的部分了。可偏偏这一点可能决定你要不要迁移。
- 逐词时间戳会消失。如果你的项目会高亮正在朗读的词,或者点击某个词时重新定位音频,这个功能就不再起作用了。
- 字幕格式
SRT和VTT也会消失。新模型返回的是文本,不是可以直接加载到视频播放器里的字幕文件。 - 翻译成英语不再以同样的方式提供。旧的翻译 endpoint 不兼容。接下来必须使用真正的翻译模型。
- 说话人识别可以告诉你谁在说话,以及是在什么时候说的。它仍然存在,但要使用第三个模型:
gpt-4o-transcribe-diarize。
换句话说,whisper-1 并没有变得毫无用处。它变得更专门了。在 OpenAI 这里,它仍然是唯一提供所有这些功能的模型。
我们顺便来终结一个传言:不,whisper-1 并没有被判死刑。我查过官方弃用页面,因为到处都有人说相反的话。2026 年 7 月 20 日的公告计划在 2027 年 1 月 20 日弃用几个音频模型,但从来没有提到 whisper-1。所以没必要急着逃跑。迁移可能是件有意思的事,但这和被迫逃跑完全不是一回事。
下载下来的免费 Whisper,它到底怎么样?
有人问过我这个问题,而它值得拥有自己的章节。很多人不知道这个版本的存在。没错,Whisper 可以免费使用。从 2022 年 9 月开始,OpenAI 以自由许可证发布模型代码和权重,也就是让它能够运行的学习数据。你把整套东西下载下来,在自己的机器上运行,不用付给任何人一分钱。不用订阅,不按分钟收费,也不用创建账号。
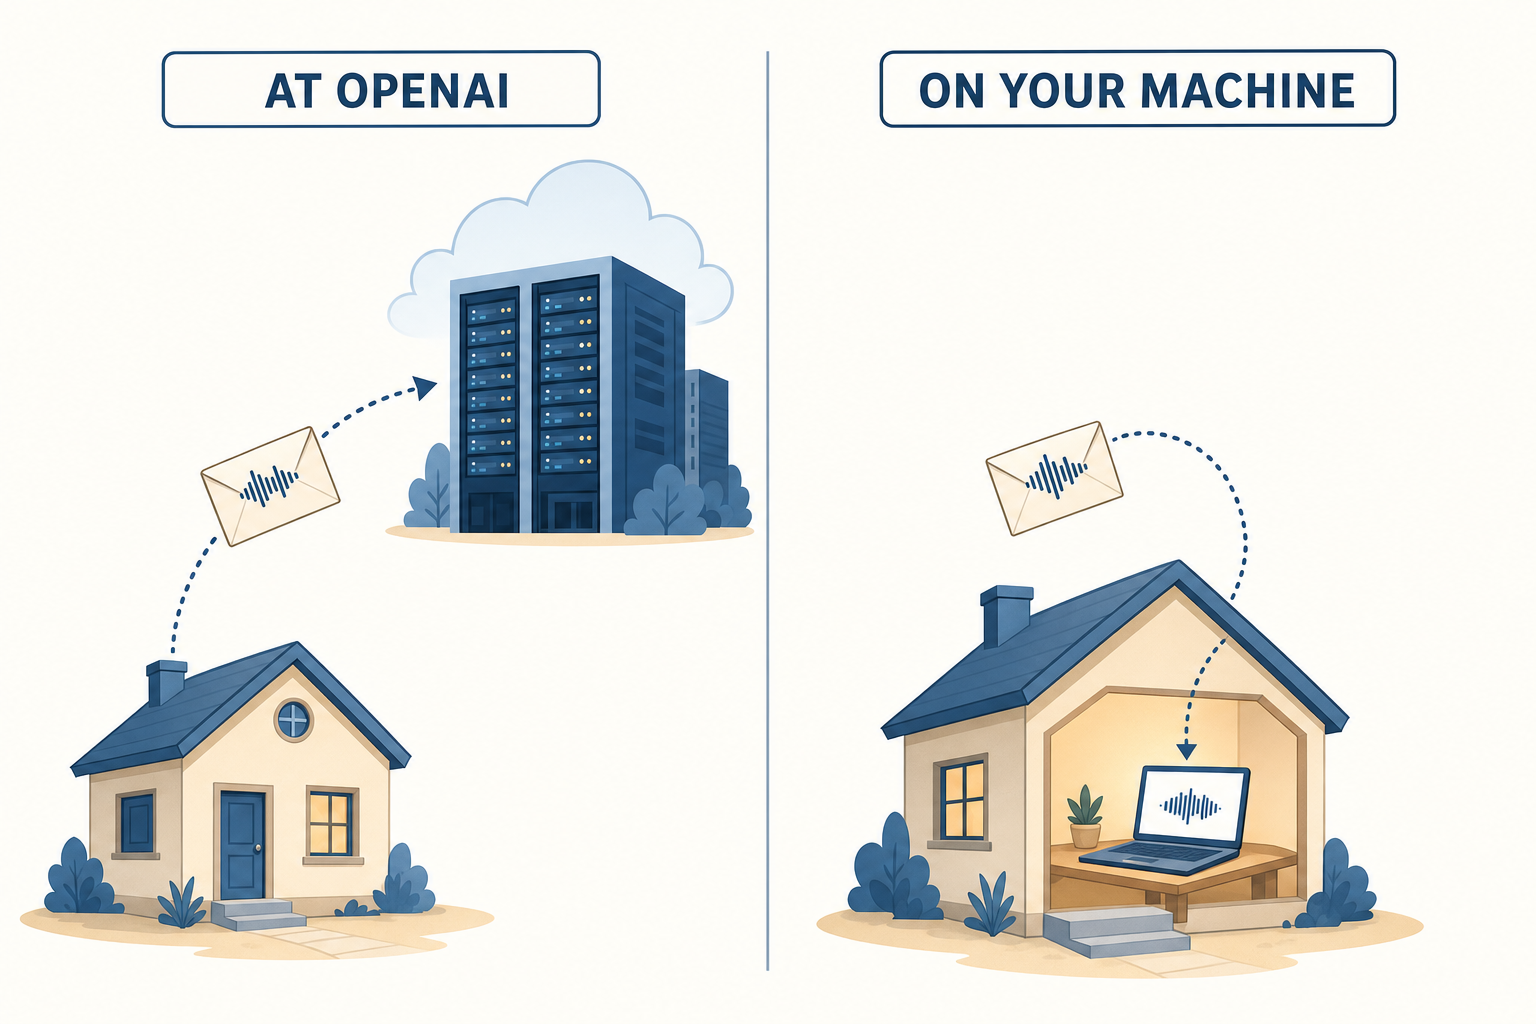
唯一真正重要的论据。左边,你的音频出去了。右边,它留在你这里。
它和 whisper-1 的区别,而且这个区别会让你大吃一惊
这里是反直觉的部分。whisper-1,API 提供的付费模型,内部使用的是 large-v2 版本。最新的免费版本是 large-v3。据 OpenAI 称,它比 large-v2 少出错 10% 至 20%。
对,你没看错。你下载的免费版本更新,也比那个每小时收费 36 美分的版本更准确。人们经常读到相反的说法。这是错的。
本地模型还会逐词生成时间戳、创建字幕,以及把内容翻译成英语。这正是你在 gpt-transcribe 中失去的三个功能。它不限制文件大小,而 API 会拒绝超过 25 MB 的文件。
这对你的机器有什么要求
代价在硬件上。这个大模型包含 15.5 亿个参数,也就是训练期间学到的数值。它在硬盘上占用大约 3 GB,并且需要大约 10 GB 的显存,也就是显卡的内存,才能舒适地运行。说白了,你需要一块真正的显卡。厨房里的笔记本电脑可能会咳嗽。
不过,也有一个为性能较弱的机器设计的版本。它于 2024 年 10 月发布,名为 large-v3-turbo。它使用 4 个解码器层,也就是负责生成文本的部分,而不是 32 个。结果,它的速度大约快 8 倍,并且只需要 6 GB 显存,而不是 10 GB。它的错误率只增加 0.3 至 0.7 个百分点。这是我在这个领域见过的最佳折中方案之一。唯一的让步是,它不再会翻译。
说到实际速度,有两款软件在争夺这块地盘。whisper.cpp 用 C 编写,并利用 Mac 的图形处理器。在较新的 Apple 机器上,它处理音频的速度大约是实际时长的 10 倍。所以一小时的录音需要六分钟。faster-whisper 则更面向 NVIDIA 显卡和处理器,在经济模式下的速度大约是实时速度的 3 倍。在 Mac 上,whisper.cpp 完胜。
那到底为什么要付费
算一算就能打破一个小幻觉。按每小时音频 27 美分计算,要花掉相当于 300 美元的金额,需要转写超过 1,100 小时。1,100 小时,就是一个半月多的音频,而且中间完全不停。买一块像样的显卡更贵。而且它不会自己处理更新、驱动和故障。真是缺乏主动性。
所以,除了工业级用量,本地处理并不能靠价格来证明合理性。它真正的理由在别处,而且硬得多。
- 你的文件不会离开你的机器。对于医疗数据、法律文件、机密访谈,或者仅仅是你家人的语音消息,这个理由通常就足以结束争论。
- 模型不需要互联网,在火车上、飞机上或工地上都能运行。
- 你没有大小限制,没有配额,也不会因为供应商决定清理一番,就有某个模型突然被砍掉。
- 不会按使用量向你收取任何费用。每小时 0 欧元仍然是每小时 0 欧元,即使你的服务运行得比预期更好。
还有一个限制,而且很简单:本文介绍的两个新模型无法下载。gpt-transcribe 和 gpt-live-transcribe 仍然归 OpenAI 所有。关键词、8.98% 的错误率以及吉他演示,不会出现在你的硬盘上。免费版本给你的是上一代 Whisper,但版本更新,也比付费 Whisper 更准确。而且不用付费。这已经相当不错了。
那么,要不要迁移
对于文件模式,调用地址不变。你仍然使用 POST /v1/audio/transcriptions。修改模型名称,就搞定了。OpenAI 提供转写指南和迁移配方,直奔主题。下面是简短回答,按照需要提出的问题顺序排列:
- 你转录文件,只想拿到文本:别犹豫,迁移吧。更便宜,更准确,而且调用方式不变。
- 你需要时间戳、字幕或翻译:继续用旧模型。没有直接的替代方案。你会失去一个功能,换来另一个功能。
- 你想要实时转录:这是一项工程,不是简单迁移。你需要另一个 endpoint、一个永久连接、24,000 Hz 的
PCM音频,以及高出四倍的预算。只有在实时转录确实是产品核心时才这么做。 - 你的录音属于机密,或者你想让账单保持为零:看看上面的本地免费 Whisper。你会失去关键词功能,但能换来一点,那就是任何东西都不会离开你的设备。
- 你的音频质量很差,而且充满术语:先测试,再做选择。新模型恰恰可能在这种情况下拉开最大差距,这要归功于关键词。
不管怎样,都要在代码里留一条退路。模型名称应该放在配置文件里,而不是夹在调用中间。眼下,模型变化的速度比使用它们的项目还快。
那语音合成又是怎么回事
如果你的应用也使用 gpt-4o-mini-tts,这个把文本转换成语音的模型,那么这一方面没有变化。没有宣布任何新消息。价格仍然在每生成一分钟约 0.015 美元。
不过,有一个阴险的坑值得花三十秒检查一下。如果你选择的是模型的某个带日期版本,而不是它的通用名称,那么 gpt-4o-mini-tts-2025-03-20 版本已于 2026 年 7 月 23 日下线。它被 gpt-4o-mini-tts-2025-12-15 替代了。仔细看看你的配置里到底写了什么。因为这个原因导致调用在周日晚上于生产环境失败,这种夜晚可是让人一辈子忘不了。
具体来说,这对你有什么改变
你不写代码,前面那些内容让你觉得完全看不懂?下面就是这些变化可能给你的生活带来的影响,而且你不需要配置任何东西。
一段需要费力辨认的文字,和一段可以直接阅读的文字之间的区别。就这样,但区别大得惊人。
1. 语音消息变得读得懂了
你知道那条两分钟的语音消息吧,你在火车上,没法听。你的手机已经会把它转录下来,但做得很差。人名被弄得面目全非,数字是凭空编出来的,最后你还是不得不把消息听一遍。从 15% 的错误词语降到 9%,不是一项抽象的统计数据。这是一段需要费力辨认的文字,和一段你可以直接阅读的文字之间的区别。
2. 给那些没人咬字清楚的视频加字幕
自动字幕在演播室里说话清楚的主持人身上表现很好。遇到一个表亲在吵闹的厨房里解释某件事的视频,带着口音,说话还经常没说完,它们就崩了。新模型正是针对这类音频。吉他演示就是用来展示这一点的。对听力不好的人来说,这不是舒适度问题。这是能否获得信息的问题。
3. 去看医生
很多医生会在看诊后口述诊疗报告。药名转录错误,可能带来实实在在的后果。这不只是一个小错字。在转录之前把药名和行业词汇提供给模型,正好可以减少这个问题。这不是这次发布中最引人注目的部分。它可能是最有用的部分。
说实话:这一切都不会在明天早上出现。这些是应用可以在未来几个月里集成的组件,它们未必会大张旗鼓地告诉你。你也许看不到任何公告。你只会在某一天注意到,转录语音消息已经没那么让你恼火了。
我的看法
真正的新意不在错误率,而在关键词。多年来,转录一直像个黑箱:你发送声音,收到文字。如果你公司的名字出来时被拼得面目全非,你能做的也只有启动一次查找替换。能够告诉模型它将听到什么,只需一行代码,就解决了转录中最让人抓狂的问题之一。
至于其他方面,我们还是保持清醒吧。OpenAI 在准确性排名中位列第四,Mistral 依然更便宜,而 OpenAI 主要只是刚刚追上了落后的进度。吉他演示很成功,但这是卖家挑选并拍摄的。真正重要的唯一指标是你自己的指标。拿出你最糟糕的一段录音,带上口音、噪音和那些不可能识别的专有名词,花十分钟把它交给两个模型处理。这花费不到一美分,却能让你学到比全世界所有基准测试都更多的东西。
Join the conversation
You need an account to comment on this article. Creating one is free and takes under a minute.
No comments yet.