Trois annonces en deux jours, et une seule question au bout : qui va payer la facture. Le 21 septembre, xAI descend son Grok 4.7 à deux dollars le million de tokens en entrée. Le 22, Anthropic sort Opus 5.5. Quatre-vingt-dix minutes plus tard, OpenAI lâche GPT-6 Sol et GPT-6 Luna, et Sol arrive exactement au même tarif d'entrée que Grok. Quand trois labos se répondent à quatre-vingt-dix minutes d'intervalle, ce n'est plus une sortie de produit, c'est une surenchère à l'envers.
Petit rappel pour ceux qui n'ont jamais payé une facture d'API, cette porte par laquelle un programme interroge un modèle sans passer par une fenêtre de discussion. Un token, c'est un morceau de mot. Comptez les trois quarts d'un mot en français. Un million de tokens, c'est donc à peu près 750 000 mots, l'équivalent de sept bons pavés. Quand un tarif passe de 4 à 2 dollars le million, ce n'est pas une promotion de supermarché, c'est la moitié de la facture qui s'évapore.
Ce qu'OpenAI annonce, et à quel prix
Deux modèles, Sol et Luna, qui remplacent GPT-5.6 Sol et GPT-5.6 Luna. Sol est le gros, Luna le rapide et le pas cher.
Les tarifs, sur la page des modèles d'OpenAI, lus le 23 septembre : 2 dollars en entrée et 10 en sortie pour Sol, contre 4 et 20 pour son prédécesseur. Pour Luna, 10 centimes et 50 centimes, contre 20 centimes et 1,20 dollar. Division par deux, proprement, annoncée comme permanente et pas comme une promotion de lancement.
La guerre des prix ne date pas de cette semaine, d'ailleurs. La semaine dernière, un modèle chinois, Fugu Ultra v2, se vantait déjà de battre GPT-6 Astra sans y toucher, pour moitié prix.
Bon, il y a un « mais » que personne ne lit. Ce qu'on peut envoyer à un modèle d'un seul coup, ce qu'on appelle son contexte, monte ici à 1,05 million de tokens. Sauf qu'au-delà de 272 000, l'entrée repasse à plein tarif et la sortie coûte une fois et demie son prix. Et quand un programme repose cent fois la même question, le fournisseur ne refacture pas ce qu'il a déjà lu : relire coûte 90 % de moins. C'est un tarif taillé pour des programmes qui tournent en boucle, pas pour la conversation du dimanche.
Ce que ça donne sur une facture
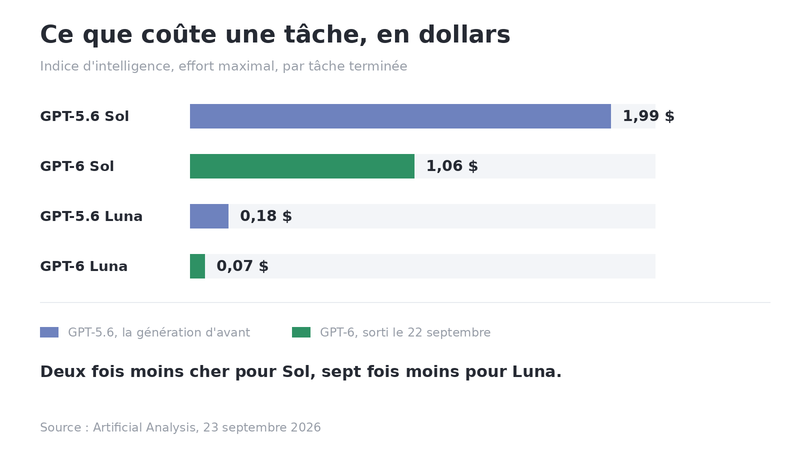
La même tâche, la même épreuve, deux générations d'écart
Un prix au million de tokens, ça ne parle à personne. Artificial Analysis, un cabinet indépendant qui fait tourner les modèles sur les mêmes épreuves et publie ses relevés avec leur date, mesure autre chose : le coût d'une tâche terminée. Et le 23 septembre, ça donnait ça.
Sol poussé à fond : 1,06 dollar la tâche, contre 1,99 pour GPT-5.6 Sol. Luna : 7 centimes, contre 18 centimes. Sur une nuit de scripts qui enchaînent les tâches, la différence ne se discute pas.
Attention au détail qui change la lecture du dessin. Les deux modèles écrivent PLUS qu'avant. 31 000 tokens de sortie pour Sol contre 29 000, et 51 000 pour Luna contre 41 000. La baisse vient du tarif, pas d'un modèle devenu économe. Il réfléchit plus longtemps, il parle plus, on paie juste moins cher le mot. Ce n'est pas un détail, c'est la moitié de l'histoire.
Les scores qui montent, et les deux qui reculent
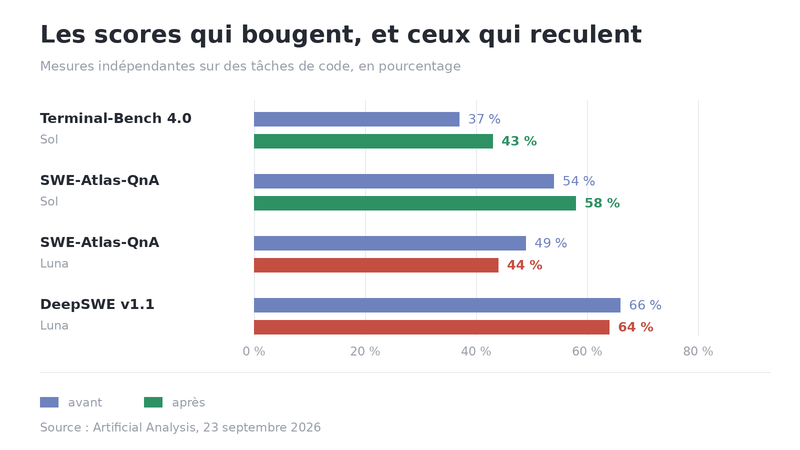
Sol avance, Luna recule, sur les mêmes épreuves
Sur les épreuves de code, Sol progresse. Terminal-Bench 4.0, des tâches à mener dans un terminal (installer, corriger, relancer jusqu'à ce que ça marche), passe de 37 à 43 %. L'épreuve de questions sur du vrai code, SWE-Atlas-QnA, de 54 à 58 %. L'indice de code du cabinet, qui mélange le tout, gagne deux points.
Sauf que Luna fait le chemin inverse. Deux points perdus sur le même indice, 49 à 44 % sur les questions, 66 à 64 % sur la réparation de bugs. Le petit a régressé pendant que le gros avançait. La conclusion du cabinet est honnête et un peu plate : les deux restent au niveau de GPT-5.6, avec des progrès ici et des reculs là.
Et il y a un endroit où les deux reculent franchement. Sur GDPval, une épreuve où des professionnels comparent des livrables produits par les modèles, Sol perd environ cent points Elo et Luna soixante-quinze. L'Elo, c'est l'unité du classement des joueurs d'échecs : plus on descend, plus on est loin derrière. L'explication est plus intéressante que la chute : moins de soin dans la présentation, des livrables qui oublient des éléments demandés au passage. Le modèle écrit mieux et rend une copie plus bâclée, ce qui est exactement le genre de progrès dont personne ne veut.
C'est le moment de ressortir une question que je posais à la sortie de GPT-6 Astra : est-ce que la performance valait vraiment deux fois et demie le prix. La réponse d'OpenAI arrive en sens inverse. Ce n'est pas la performance qui monte pour justifier le tarif, c'est le tarif qui descend.
Le piège du taux d'hallucination
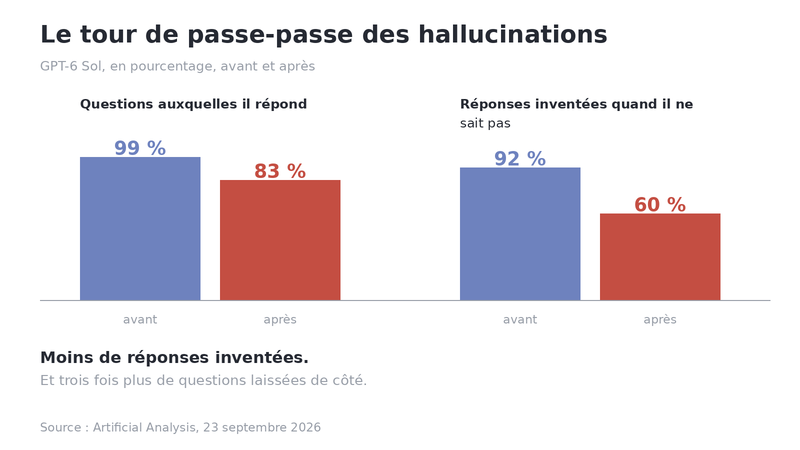
Deux barres qui baissent, et une seule qui est une bonne nouvelle
Voilà le chiffre que tout le monde a repris cette semaine : la tendance à inventer une réponse s'effondre, de 92 à 60 % pour Sol et de 93 à 77 % pour Luna, sur une épreuve de connaissances pointues du même cabinet. Présenté comme ça, c'est spectaculaire.
Regardez la deuxième barre du dessin. Le même relevé dit qu'il ne tente plus sa chance que sur 83 % des questions, contre 99 % avant, et que la part de bonnes réponses sur l'ensemble recule de 59 à 54 %. Il laisse donc tomber une question sur six, et il rapporte au total moins de bonnes réponses qu'avant.
C'est mieux, très clairement mieux, et le cabinet le dit aussi : sur sa note globale de connaissances, Sol passe de 22 à 27 points. Mais ce n'est pas le progrès que le chiffre vedette annonce tout seul. Un modèle qui invente moins parce qu'il tente moins, ça s'appelle un dictionnaire. Et ce trou, pour un programme qui enchaîne des tâches sans personne derrière, ça veut dire une tâche qui s'arrête en plein milieu.
Concrètement, ça change quoi pour toi
Tu n'appelles jamais l'interface d'OpenAI depuis ta cuisine. Sauf que tu utilises tous les jours des choses qui tournent dessus, et c'est là que ça se joue.
Trois exemples qui te parlent. La traduction automatique dans ton navigateur, celle qui te sort une page allemande en français d'un clic : chaque page traduite est une facture quelque part, et diviser cette facture par deux, c'est ce qui permet de garder la fonction gratuite. Ensuite, tous ces assistants qui se sont mis à répondre à ta place (le chat de ta banque, les résumés de réunion, les notes vocales de ton téléphone) : ils sont facturés au même token, et un tarif divisé par deux, c'est deux fois plus de ces fonctions qu'un éditeur peut offrir dans le même abonnement. Et si tu bricoles du code, même juste des scripts pour ranger tes photos, c'est ta facture à toi qui baisse.
Ce qu'il ne faut pas attendre, par contre : une baisse de ton abonnement. Ça n'arrive presque jamais. Le prix du token baisse, la fonction augmente, et la ligne sur ton relevé bancaire ne bouge pas. C'est exactement ce qui s'est passé avec les données mobiles : un gigaoctet coûtait le prix d'un repas il y a quinze ans, il est aujourd'hui noyé dans un forfait à quinze euros et personne ne le compte plus.
Ce que j'en pense
Une dernière chose, et elle est de mon côté de l'écran. Je fais tourner trois sessions de Claude Code en parallèle sur trois projets, et il m'arrive de regarder le compteur de mon quota avant le reset comme on regarde la jauge d'essence. Le prix d'un token, dans ce décor-là, ce n'est pas un chiffre abstrait : c'est ce qui décide si je peux laisser une machine travailler pendant que je dors.
Pour moi, c'est la meilleure nouvelle de la semaine, et pas pour la raison qu'on croit. Je n'ai pas besoin que le modèle du mois soit plus intelligent que celui du mois dernier. J'ai besoin qu'il fasse le même travail pour deux fois moins cher, parce que c'est ça qui décide si un truc peut tourner en permanence ou seulement quand j'appuie sur le bouton.
Reste que Luna recule et que Sol rend des copies plus bâclées. Les deux ont un an de plus et une facture plus légère, avec un peu moins de soin dedans. C'est un échange que je veux bien faire pour mes scripts, pas pour tout.
Bref, merci pour la division par deux, on prend. Et bonne chance à Grok et à Opus, qui auront été les champions du prix pendant quatre-vingt-dix minutes.
Rejoignez la conversation
Vous devez avoir un compte pour commenter cet article. La création est gratuite et prend moins d'une minute.
Aucun commentaire pour le moment.