Pendant une semaine du mois d'août, un modèle inconnu a débarqué sur deux services utilisés par les développeurs, gratuit, sans nom de fabricant, sous le pseudonyme Ox Alpha. Il fallait le tester sans savoir à qui on avait affaire. Il est devenu le modèle le plus utilisé de la semaine sur ces deux plateformes. Et au bout de quelques jours, des gens ont deviné de quelle famille il venait rien qu'en regardant comment il découpait le texte en morceaux, avant que Z.ai ne confirme et ne publie les poids.
C'était GLM-5.3-Flash, et ce petit jeu n'était pas un caprice : la boîte voulait des retours de développeurs qui n'auraient pas d'avis préconçu sur la marque. Bien joué. Et vendredi, la même entreprise a remis une pièce dans la machine, avec une version qui va cinq fois plus vite et qui coûte deux fois et demie plus cher.
Ce qui a été annoncé vendredi
Le nouveau venu s'appelle GLM-5.3-FlashX. Deux chiffres dans le communiqué, et ils vont dans des directions opposées. La vitesse d'abord : jusqu'à 200 jetons par seconde, contre environ 45 pour la version Flash. Cinq fois plus vite. Le prix ensuite : la grille passe à 0,37 dollar le million de jetons en entrée, là où la Flash est à 0,15. Pour la sortie, 1,25 dollar contre 0,50. Bref, le même facteur 2,5 appliqué à toute la grille.
Un jeton, pour situer, c'est un morceau de mot. Compte environ trois quarts d'un mot français courant. Donc un million de jetons, c'est à peu près 750 000 mots, soit deux gros romans, pour quelques dizaines de centimes.
Une boîte sans étiquette posée sur l'étagère. Tout le monde l'a testée pendant une semaine sans savoir qui l'avait fabriquée
Ce que ça coûte, mis côte à côte
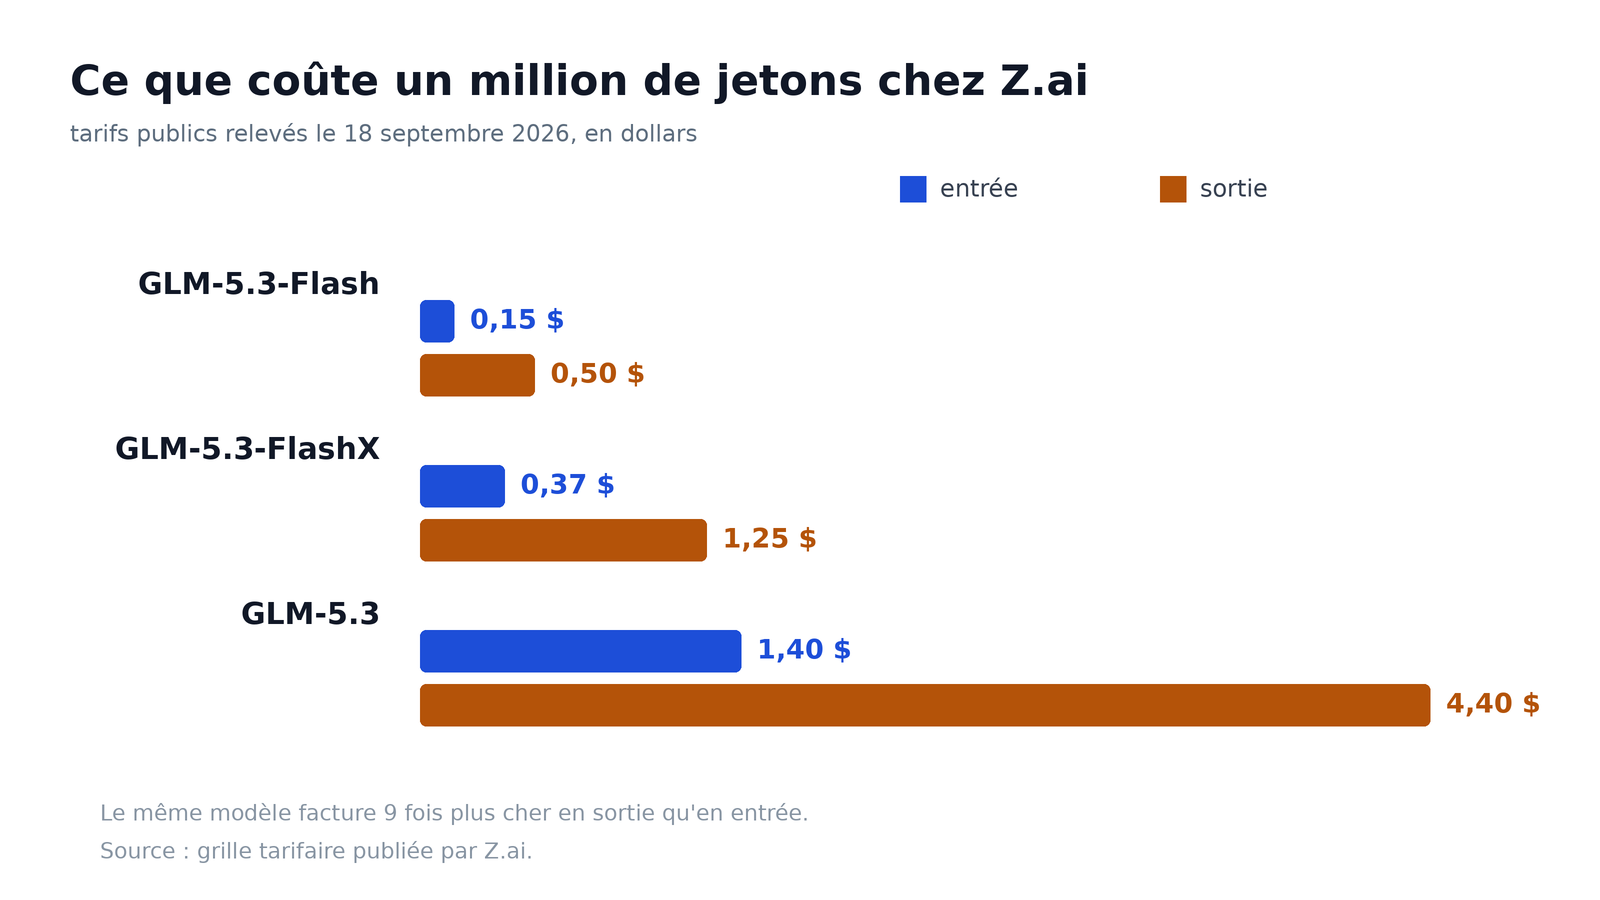
Le prix d'entrée d'un million de jetons, chez le même fabricant, le 18 septembre 2026
Le tableau complet de Z.ai est instructif, parce qu'il montre que la boîte ne s'est pas contentée de monter un prix : elle a construit un étage de plus. En bas, il y a GLM-5.3-Flash à 0,15 dollar l'entrée. Au milieu, la nouvelle FlashX à 0,37. En haut, GLM-5.3, le modèle complet, à 1,40 dollar l'entrée et 4,40 la sortie, soit presque quatre fois le prix de la FlashX.
Ce qu'il faut regarder, ce n'est pas le chiffre brut, c'est ce que la machine dépense pour faire le travail. Sur l'indice d'Artificial Analysis, qui mesure un mélange de raisonnement, de code et de connaissances, GLM-5.3-Flash sort à 57 points, ce qui le place troisième tous modèles confondus, et la tâche y revient à 0,09 dollar. Claude Opus 4.8, poussé au maximum de réflexion, marque à peu près le même score mais coûte 2,03 dollars la tâche. Voilà l'écart réel : une vingtaine de fois, pas un facteur 40 comme on le lit parfois. Et la FlashX, à 2,5 fois le prix de la Flash, reste encore très loin derrière.
Ce qui tourne là-dessous
La fiche technique a de quoi surprendre pour un modèle de cette gamme. 320 milliards de paramètres au total, mais 18 milliards seulement activés pour chaque mot produit. C'est le principe du mélange d'experts : la machine garde des dizaines de spécialistes sous la main et n'en réveille que huit sur les 288 disponibles pour traiter le morceau de texte en cours. D'où une facture qui reste basse malgré une taille affichée qui ferait peur.
C'est aussi le premier de la famille à voir, au sens propre : le texte, les images et la vidéo entrent dans le même modèle, jusqu'à un million de jetons d'entrée d'un coup. On est loin du bricolage où l'on colle un lecteur d'images à côté d'un modèle de texte.
Et il y a un détail que les Américains ont remarqué avant nous : pendant toute la semaine de test gratuite, le modèle a tourné exclusivement sur des puces fabriquées en Chine. Pas un accélérateur Nvidia là-dedans. Pour un modèle de cette qualité servi gratuitement à des milliers de développeurs en même temps, c'est une démonstration autant qu'un communiqué.
Ce que ça change dans ta facture
Si tu n'utilises jamais de modèle par l'interface de programmation, cette nouvelle ne te concerne pas directement, et je préfère le dire. Ce qui descend, ce sont les tarifs au volume, pas les abonnements.
Pour les autres, l'effet est simple et il se voit en fin de mois. Un agent qui trie tes mails, qui résume tes réunions ou qui passe la nuit à relire du code consomme des jetons en continu, et le prix du jeton décide si tu le laisses tourner ou si tu le coupes. Diviser la facture par vingt change complètement ce qu'on ose lancer. Mon propre usage ressemble à ça : je fais tourner Claude Code toute la journée, et il m'arrive de basculer sur GLM quand le quota du mois part trop vite.
L'agent qui travaille pendant que tu dors. Ce n'est pas gratuit, c'est juste devenu assez bon marché pour ne plus y penser
Attention quand même à un piège que ce genre d'annonce installe. Un modèle rapide, c'est bien, mais la vitesse se paie aussi en relecture. À 200 jetons par seconde, la machine produit plus vite que tu ne lis et bien plus vite que tu ne vérifies. Sur du code, ça veut dire des erreurs qui arrivent groupées, et une relecture qui devient le vrai goulot d'étranglement.
Ce qui reste flou, et ce n'est pas rien
Trois choses que la fiche ne dit pas. La date de coupure des connaissances n'est pas publiée, ni la provenance des données d'entraînement, ce qui est la norme chez presque tout le monde mais qui mérite d'être dit à chaque fois. Ensuite, les poids sont téléchargeables gratuitement sous licence MIT, mais la version complète GLM-5.3 ajoute une clause : une entreprise qui dépasse dix milliards de dollars de chiffre d'affaires doit passer un contrôle de sécurité avant de s'en servir. Ce n'est pas la fin du logiciel libre, c'est une condition posée au sommet du marché.
Enfin, il y a un contre-pied amusant dans les chiffres. La FlashX est cinq fois plus rapide que la Flash, mais le modèle complet GLM-5.3 reste plus rapide que la FlashX en débit réel, 78 jetons par seconde contre 45. La vitesse annoncée en pic et la vitesse que tu obtiens sur ta requête ne sont pas la même chose. C'est vrai de tous les modèles, c'est juste plus visible quand on empile trois versions du même.
La vraie question n'est pas le prix
Pendant deux ans, la promesse des modèles chinois tenait en une phrase : aussi bons, beaucoup moins chers. C'était vrai, ça l'est encore, et voilà qu'ils ajoutent un étage au-dessus et qu'ils le facturent presque trois fois le prix du dessous.
Il faut le lire comme ça : arrivés par le prix, ils veulent maintenant être payés pour autre chose. Z.ai est cotée en bourse depuis cette année, lève des milliards, et n'a plus besoin de casser les prix pour exister. C'est exactement ce qu'a fait OpenAI avant elle, et c'est le signe qu'une catégorie grandit.
Reste que la Flash gratuite, celle qui a servi de vitrine, elle est toujours à 0,15 dollar l'entrée. Combien de temps encore, si personne ne vient la concurrencer par le bas ?
Rejoignez la conversation
Vous devez avoir un compte pour commenter cet article. La création est gratuite et prend moins d'une minute.
Aucun commentaire pour le moment.