Diogo Almeida a bossé sur la méthode qui a rendu ChatGPT utilisable, la fameuse étape où des humains notent les réponses du modèle pour lui apprendre à se tenir. Le 15 septembre, il a annoncé la sortie de son propre modèle, Jev, chez TypeSafe AI, sa boîte qui vient de lever 40 millions de dollars. Et il a fait un truc que personne n'attendait de ce milieu : son modèle ne sait pas écrire.
Pas « il écrit mal ». Il n'écrit pas du tout. Vous lui donnez une situation, il vous rend une décision. Pas une phrase, pas un paragraphe, pas de « bien sûr, voici ce que je pense » : une case cochée, choisie parmi une liste que vous avez fixée vous-même, avec un pourcentage de confiance collé dessus.
Vous allez me dire que c'est une régression. Soyons sérieux deux minutes : c'est peut-être la chose la plus intéressante sortie cette semaine dans le domaine, et pour une raison très simple que je vais essayer de rendre claire.
Ce que Jev renvoie exactement
Un modèle de langage classique fonctionne à la parole. Vous lui demandez de trier une facture dans la bonne catégorie, il va vous écrire une jolie phrase pour le faire : « D'après les informations présentes, cette facture semble relever de la catégorie fournitures de bureau. » Trente mots, deux cents millisecondes par mot, pour transmettre quatre mots d'information. C'est un peu comme demander à un garagiste si votre pneu est crevé et recevoir une lettre de motivation.
Jev ne fait pas ça. Sa sortie est un ensemble de valeurs typées, c'est-à-dire des choses qui ont un type connu à l'avance : un nombre entre 0 et 1, une catégorie prise dans une liste, un vrai ou un faux. Il accepte jusqu'à 255 réponses possibles dans sa liste, et au-delà d'une centaine, il découpe la décision en deux temps de notation pour ne pas s'emmêler.
Le fondateur résume ça d'une formule que je trouve très bien trouvée : « un appel de fonction doté d'une intelligence de pointe ». Une entrée en vrac, une sortie rangée. Rien d'autre.
Pourquoi ça va deux cents fois plus vite
Un modèle qui écrit avance mot par mot. Il ne peut pas commencer sa deuxième phrase avant d'avoir fini la première, parce que chaque mot produit devient une entrée pour le suivant. C'est une chaîne, et une chaîne a la vitesse de son maillon le plus lent.
Une décision n'a pas besoin d'être construite dans l'ordre. TypeSafe appelle ça un échantillonneur parallèle : le modèle travaille toutes les possibilités de front, dans la même passe de calcul, et ressort les scores ensemble. Il n'y a pas de deuxième mot à attendre, donc il n'y a pas d'attente du tout.
Un seul guichet qui prend les dossiers un par un, ou trente guichets ouverts en même temps
Les chiffres annoncés suivent cette logique. Entre 70 et 500 millisecondes de latence, contre 3 à 329 secondes pour les modèles les plus lourds du marché. Les 329 secondes, ce n'est pas une caricature : c'est le temps que met un grand modèle à rendre un raisonnement long, et c'est un chiffre que TypeSafe compare à celui de ses concurrents.
Et l'histoire du prix, elle, est carrément brutale. Un million de jetons en entrée coûte 0,042 dollar chez TypeSafe. En sortie, c'est gratuit : leur page l'écrit noir sur blanc, « trop bon marché pour être mesuré ». Sur leurs propres essais, ils annoncent 193,6 fois plus rapide et 444,6 fois moins cher que les modèles de texte, et un pic à 200 fois sur les tâches qui leur conviennent.
Les chiffres, et le piège qui va avec
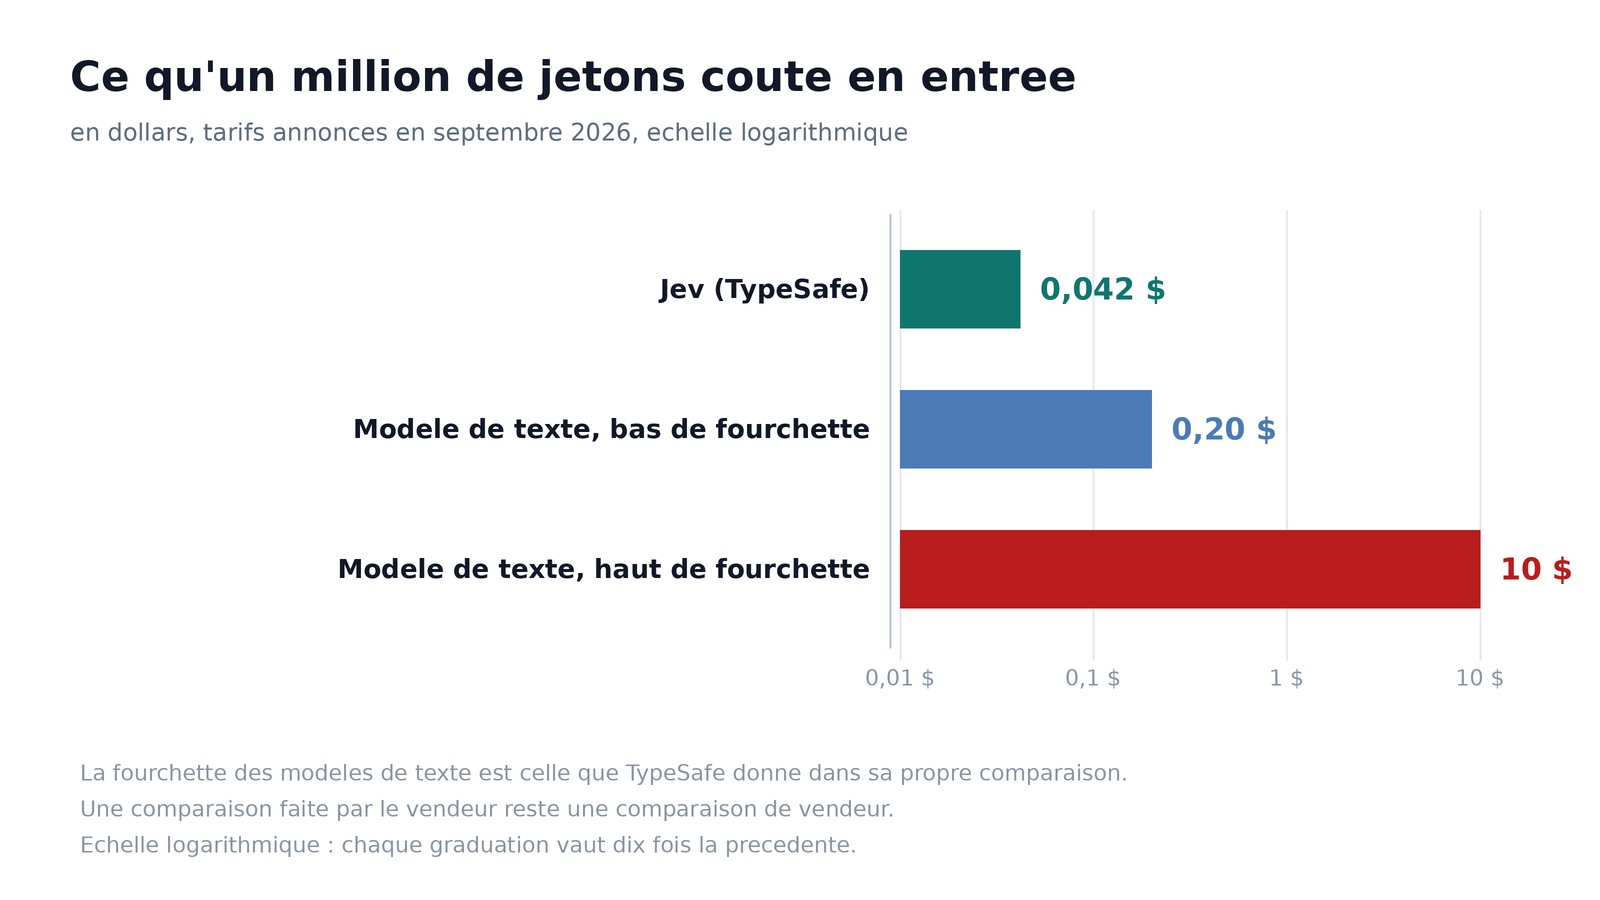
Le prix d'entrée d'un million de jetons, et la fourchette que le vendeur donne lui-même pour les modèles de texte
Il faut lire la petite ligne, et elle est de TypeSafe eux-mêmes : ces 193,6 et 444,6 viennent de leurs propres bancs d'essai, construits par leur équipe, et la référence à laquelle ils se comparent est une moyenne de deux modèles choisis par eux. Ils l'écrivent sans qu'on le leur demande, ce qui est tout à leur honneur, mais ça reste une comparaison de vendeur. Les mesures faites par des gens de l'extérieur tombent plutôt entre 5 et 25 fois plus rapide, ce qui est déjà énorme et n'a plus rien à voir avec un facteur 200.
Trois autres détails à garder en tête, et je préfère les dire tout de suite. Il n'existe aucun article scientifique derrière tout ça, aucune courbe de fiabilité publiée, alors que le cœur de la méthode est justement une histoire de confiance bien calibrée. Aucun client n'est nommé, aucun chiffre de vente n'est donné, l'accès se fait sur liste d'attente. Et quand on a demandé au fondateur si son modèle n'était au fond qu'un classificateur sophistiqué, il a répondu « exactement », avant de refuser de décrire son architecture.
Ce n'est pas forcément louche : une boîte de deux mois qui sort de l'anonymat n'a pas grand-chose à montrer. Mais ça veut dire qu'aujourd'hui, on achète une promesse avec un tarif, pas un produit éprouvé.
Ce qu'il ne sait pas faire, et il faut le dire clairement
C'est un modèle pour lequel on choisit les réponses possibles avant de poser la question. Donc si la bonne réponse n'est pas dans votre liste, il choisira la moins mauvaise et vous donnera un joli pourcentage de confiance pour accompagner l'erreur. On ne lui demande pas une dissertation, ni une recette de cuisine, ni de résumer un document. Il ne peut pas inventer une valeur qui n'existe pas dans le schéma, ce qui rend l'hallucination au sens strict impossible, mais ça ne l'empêche pas de se tromper de case. Nuance importante, parce que c'est exactement ce que la communication de la boîte laisse dans le flou.
Sur leurs propres évaluations de tâches réelles, leur tableau affiche 67,8 % de réussite. En face, 73,1 % pour Opus 5 et 74,1 % pour Sol. Autrement dit, sur le jugement général, les gros modèles de texte restent devant. Ce que Jev gagne, ce n'est pas la qualité de la réponse, c'est le prix et le temps qu'on met à l'obtenir.
Concrètement, ça change quoi pour toi ?
La plupart des choses qu'on fait faire à une IA dans une maison ne demandent aucune rédaction. Est-ce que cette photo contient un visage ou un paysage ? Est-ce que ce mail est une pub ou un message de l'école ? Est-ce qu'il faut allumer le chauffage maintenant ? Oui, non, dans cette catégorie. Une phrase complète n'a jamais servi à rien dans ces cas-là, on la payait parce qu'il n'y avait pas d'autre moyen.
Le tri des photos de famille : la machine range, personne ne lit rien, et la facture est divisée par vingt
Le vrai effet, c'est le prix et la vitesse à l'échelle d'une maison. Une box qui classe les photos du téléphone pendant la nuit, un serveur qui trie les mails avant que vous ne les ouvriez, un logiciel de sous-titres qui décide pour chaque bout de son si c'est de la parole ou de la musique : autant de tâches où l'on payait un moteur de littérature pour cocher des cases. Si le tarif annoncé tient dans le temps, ces fonctions deviennent assez bon marché pour tourner en permanence au lieu d'être un réglage qu'on hésite à activer.
L'échéance, en revanche, n'est pas pour demain matin. Le produit est en accès anticipé, sur liste d'attente, sans client public. Et le prix de 0,042 dollar, la boîte admet elle-même qu'elle ne peut pas prouver qu'il n'est pas subventionné. C'est le tarif d'appel d'une jeune entreprise qui achète ses utilisateurs, pas encore un prix de marché. Je connais assez les factures de jetons pour savoir qu'un tarif de lancement ne dit rien de celui qu'on paiera dans deux ans.
Si tu es développeur
C'est là que ça se joue vraiment, parce que le produit est vendu aux programmes, pas aux humains. Vous décrivez votre schéma de sortie, vous envoyez l'état de votre système, vous recevez une décision exploitable directement, sans analyse de texte à faire derrière.
POST /v1/decisions
{
  "schema": { "categorie": ["facture", "devis", "publicite", "autre"] },
  "input": "<le texte ou l'etat du systeme>"
}
# reponse : categorie = "devis" (0.94)
Le gain n'est pas seulement le coût : c'est de ne plus écrire de code pour parser une réponse en langue naturelle. Plus de « le modèle a répondu oui mais sous forme de paragraphe, il faut extraire la valeur ». La sortie est déjà de la donnée.
Deux réserves de développeur, que je n'ai pas vues traitées par la communication. Un schéma, ça se conçoit, et un schéma mal fichu vous rendra des erreurs parfaitement calibrées à 94 % de confiance. Et les chiffres de charge publiés sont ceux d'un service en accès restreint : aucune latence garantie sous forte affluence, aucun engagement de disponibilité. Pour du bricolage, aucun problème. Pour quelque chose qui doit répondre la nuit pendant que tout le monde dort, on attendra de voir.
Le mois dernier, j'expliquais dans un autre article que le prochain Astra ne répondrait pas plus vite, mais qu'il travaillerait plus longtemps. C'était la tendance générale du moment : des modèles qui passent trente secondes à réfléchir pour gagner en qualité. Voilà qu'un ancien de la maison part exactement dans l'autre sens, en acceptant de perdre en finesse ce qu'il gagne en temps. Les deux approches ne s'excluent pas, elles se répartissent le travail : le raisonnement long pour ce qui mérite réflexion, la décision immédiate pour tout le reste.
Reste une question que je me pose depuis que j'ai lu leurs chiffres, et je n'ai pas la réponse : si la moitié de ce qu'on fait faire à une IA n'a jamais eu besoin qu'elle écrive, combien de temps allons-nous encore payer au mot ce qui se vend à la décision ?
Rejoignez la conversation
Vous devez avoir un compte pour commenter cet article. La création est gratuite et prend moins d'une minute.
Aucun commentaire pour le moment.